Dynamic Linear Attention
作者:Xin Wang, Hui Shen, Boyuan Zheng, Xueshen Liu, Minkyoung Cho
作者提出动态线性注意力(DLA)框架,通过信息感知动态状态合并和容量受限内存建模,解决现有线性注意力方法中固定状态合并策略无法适应动态 token 重要性的问题。该方法根据 token 级别的信息变化自适应确定状态边界,在语义转换处保留高分辨率表示,同时在稳定区域进行压缩。
论文信息摘要
论文要解决什么
现有线性注意力方法在长上下文建模中依赖固定的状态合并策略,假设序列信息密度均匀,导致关键 token 被过早压缩且无法恢复,引发长序列上的误差累积和性能下降。
论文方法概览
- Backbone: Linear Attention Models (e.g., Mamba-2, Gated DeltaNet)
- 关键模块: Information-Aware Dynamic State Merging, Capacity-Bounded Memory Modeling
- 损失函数: 标准预训练损失
读后要点
个人理解,欢迎指正
实验表明 DLA 在 16 个数据集上优于最先进方法(如 Log-Linear Attention),且在 Mamba-2 上性能可比全注意力 Transformer。动态合并机制有效平衡了内存效率与表示能力,避免了固定策略带来的信息丢失。
局限与疑问
动态状态合并的计算开销(如状态信息分数计算)在极端长序列下的实际延迟影响需进一步验证;阈值参数 τ 的敏感性未详细讨论。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.10650v1。
Dynamic Linear Attention 阅读笔记
1. 背景与动机
大型语言模型(LLMs)在长上下文设置下的扩展性主要受限于标准注意力机制的二次计算和内存复杂度。为了解决这一问题,线性注意力(Linear Attention)机制因其亚二次复杂度而成为研究热点。然而,为了在长序列下提高表示能力,现有的多状态线性注意力方法(如 Log-Linear Attention)通常将历史上下文划分为块并总结为紧凑的内存状态。
论文指出,现有的多状态线性注意力方法存在显著缺陷。这些方法依赖于固定的状态合并策略(例如固定的块大小或基于规则的合并时间表),无法适应长序列中非均匀且动态演变的信息结构。这种设计隐含地假设序列中的信息密度是均匀的,导致无法适应动态出现的语义转换。关键 token 可能被过早地吸收到粗略的摘要中,且一旦异构 token 被压缩进单一状态,其个体贡献便无法恢复,导致长序列上的误差累积。
因此,作者认为有效的长上下文线性注意力需要同时具备“信息感知”和“容量控制”的内存建模机制。
2. 方法详解:动态线性注意力 (DLA)
为了解决上述挑战,作者提出了动态线性注意力(Dynamic Linear Attention, DLA)框架。DLA 是一个信息感知的线性注意力框架,能够动态构建紧凑的内存状态集,以实现高效的长上下文建模。
2.1 整体架构
论文通过图 1 展示了 DLA 的整体概览。与依赖固定时间调度或预定义块边界的先前方法不同,DLA 根据 token 级别的信息变化自适应地确定状态粒度。
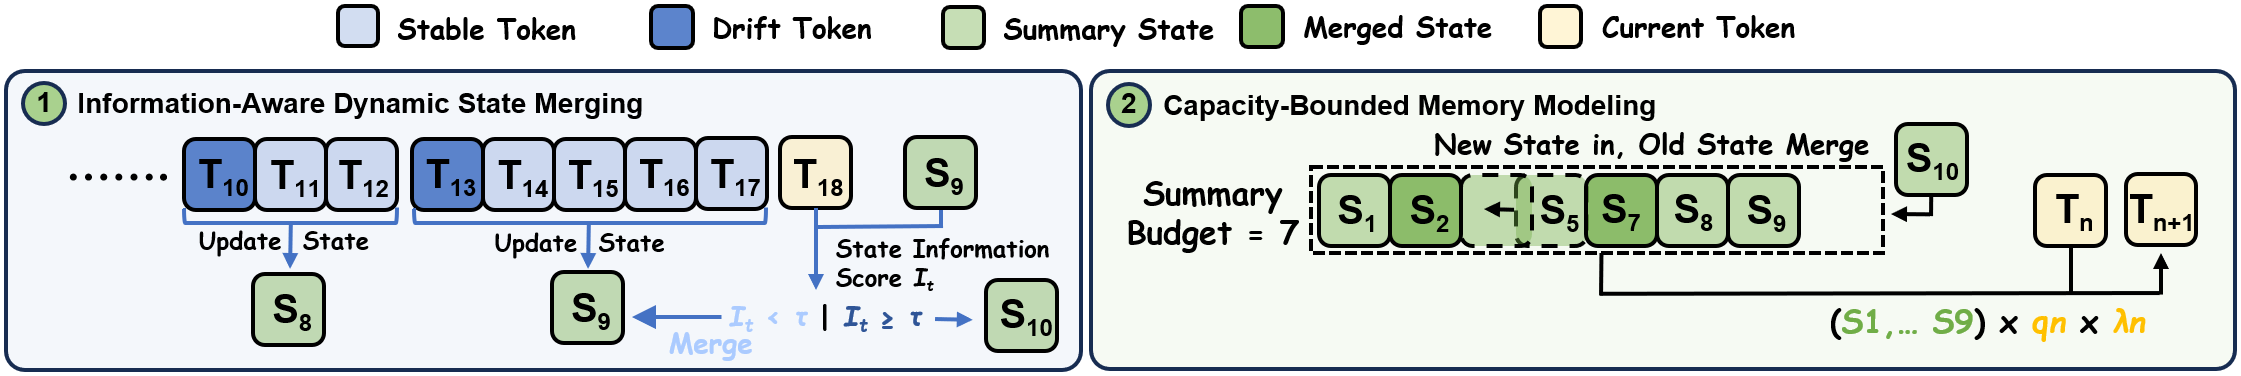
具体流程如下:
- 顺序处理:Token 被顺序处理。
- 状态信息评分:对于每个新 token,DLA 计算一个轻量级的“状态信息分数”(State Information Score),衡量其相对于最近内存状态的表示变化。
- 动态合并:信息变化低的 token 被合并到当前状态,而表现出显著漂移的 token 则启动新状态。这使得模型能够在语义转换周围进行细粒度建模,同时对稳定的 token 跨度进行激进摘要。
- 容量限制:为了限制内存和计算,DLA 维护一个容量受限的状态缓存。当缓存达到最大大小时,DLA 选择性地合并相邻的低信息密度状态,保持时间顺序同时最小化信息损失。
2.2 核心组件
DLA 主要包含两个关键创新点:
-
信息感知动态状态合并 (Information-Aware Dynamic State Merging) 该机制基于 token 级别的信息变化动态确定状态边界。算法 1 描述了这一过程:计算当前 token 状态与上一个状态之间的差异(使用 Frobenius 范数归一化),如果差异超过阈值 ,则创建新状态;否则将当前 token 合并到现有状态中。
-
容量受限内存建模 (Capacity-Bounded Memory Modeling) 该机制维护一个固定大小、按时间顺序排列的状态缓存。当缓存满时,系统会合并相邻的低信息状态,从而确保推理期间的计算和内存成本是可预测的。
2.3 与现有方法的对比
论文通过图 2 直观地对比了标准线性注意力、对数线性注意力(Log-Linear Attention)和动态线性注意力(DLA)的区别。
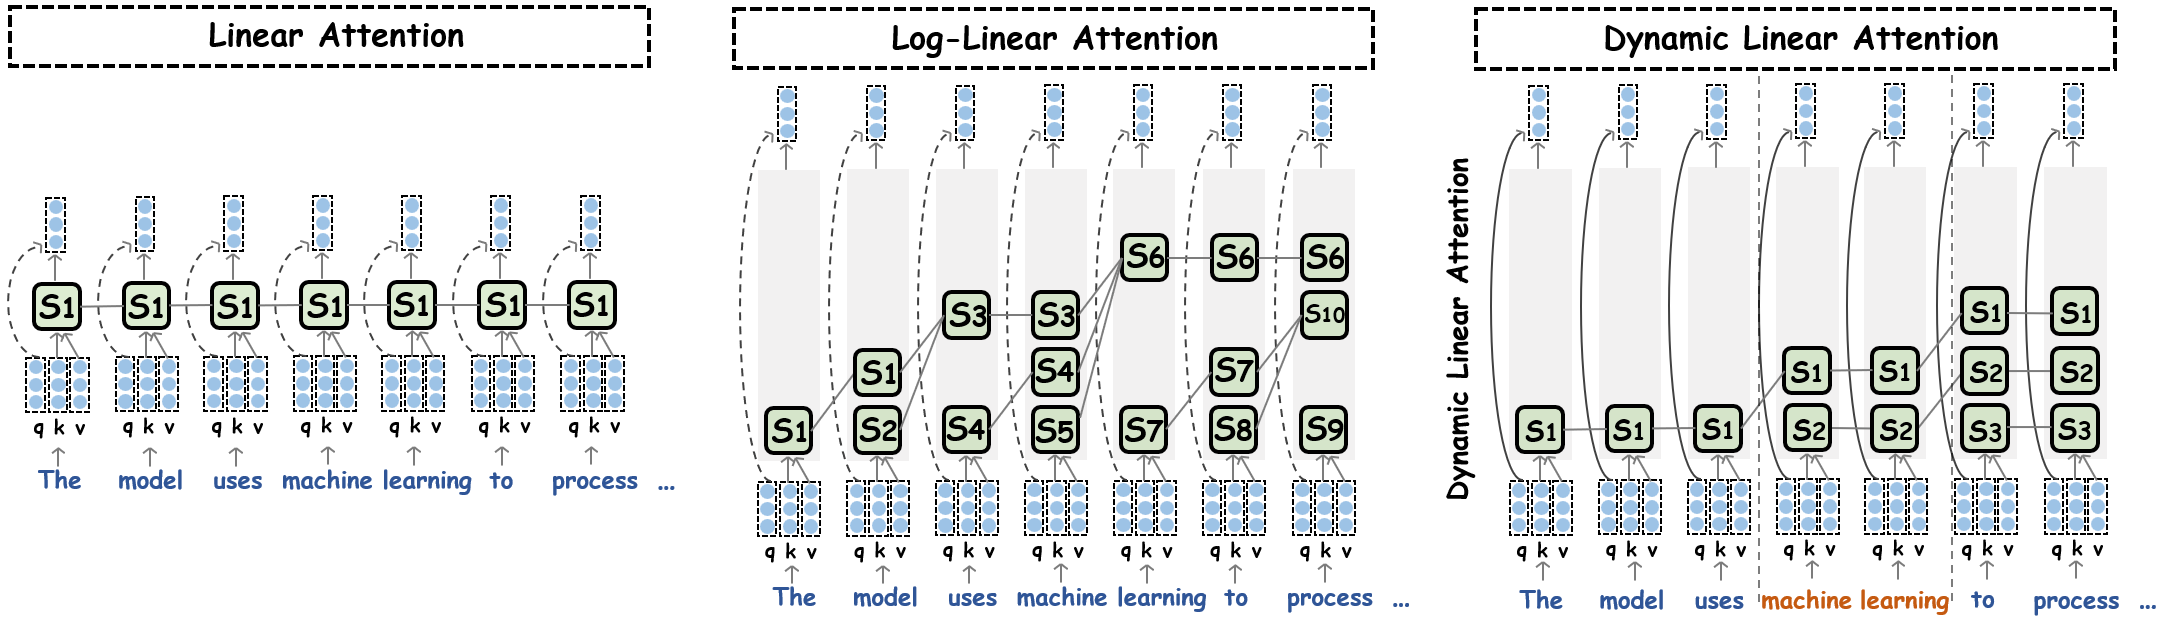
- 标准线性注意力 (左):通常维护单个全局状态,虽然计算效率高,但难以在长序列中选择性保留细粒度信息。
- 对数线性注意力 (中):使用固定的分层调度(Fenwick 树分解)来构建多尺度状态。虽然实现了 的训练复杂度,但其内存状态的粒度由固定层级决定,独立于 token 级别的表示变化。
- 动态线性注意力 (右):DLA 根据信息密度动态调整状态边界。在语义变化剧烈的区域保持高分辨率,在稳定区域进行压缩,从而在保持效率的同时提升了表示能力。
3. 实验与结果
作者在两个不同的线性注意力模型(Mamba-2-780M 和 Gated DeltaNet-1.3B)上预训练了 DLA,并在涵盖三个类别的 16 个数据集上进行了评估:
- 八个常识推理基准。
- 六个上下文检索数据集。
- 两个长上下文建模数据集。
3.1 主要发现
实验结果证明了 DLA 优于最先进的方法(State-of-the-Art),主要发现包括:
- 性能优越性:DLA 在所有任务上始终优于最先进的多状态方法 Log-Linear Attention。
- 与全注意力 Transformer 的对比:当应用于 Mamba-2 时,DLA 变体甚至实现了与具有相似参数预算的全注意力 Transformer 相当的性能。
- 效率优势:DLA 实现了更高的吞吐量和更低的运行时内存消耗,优于 Log-Linear Attention。
4. 总结
论文提出了一种名为 Dynamic Linear Attention (DLA) 的新框架,旨在解决现有线性注意力方法在长上下文建模中因固定状态合并策略导致的性能下降问题。通过引入信息感知动态状态合并和容量受限内存建模,DLA 能够自适应地根据 token 重要性调整内存分辨率,并在保持亚二次复杂度的同时显著提升表示能力。实验表明,该方法在多个基准测试中均取得了优于现有技术的性能,为长上下文 LLM 的高效扩展提供了新的解决方案。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。