Cross-Modal Masked Compositional Concept Modeling for Enhancing Visio-Linguistic Compositionality
作者:Wei Li, Zhen Huang, Xinmei Tian
作者提出 MACCO 框架,通过在一个模态中掩码组合概念并利用另一模态的完整上下文进行重建,以捕捉跨模态组合结构。
论文信息摘要
论文要解决什么
现有对比训练视觉语言模型(如 CLIP)存在“词袋”行为,难以捕捉对象关系、属性绑定及词序依赖,且现有硬负样本构建方法成本高、噪声大。
论文方法概览
- Backbone: CLIP-like VLM (ViT + Transformer)
- 关键模块: 跨模态掩码重建模块,全局到局部语义注入
- 损失函数: 掩码增强跨模态对齐损失 (MCA),掩码增强模态内正则化损失 (MIR)
读后要点
个人理解,欢迎指正
实验表明该方法显著提升了 VLM 的组合理解能力,同时增强了句法结构捕捉能力,并对文本到图像生成及多模态大语言模型任务有益。
局限与疑问
论文未明确讨论具体局限,但掩码重建策略可能增加训练计算开销,且泛化性有待进一步验证。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.13288v1。
arXiv 论文阅读笔记:Cross-Modal Masked Compositional Concept Modeling for Enhancing Visio-Linguistic Compositionality
论文概览
- 论文 ID: 2606.13288v1
- 标题: Cross-Modal Masked Compositional Concept Modeling for Enhancing Visio-Linguistic Compositionality
- 作者: Wei Li, Zhen Huang, Xinmei Tian
- 机构: 中国科学技术大学 (University of Science and Technology of China)
- 核心贡献: 提出了 MACCO 框架,通过跨模态掩码概念重建来增强视觉 - 语言模型(VLM)的组合理解能力,无需显式的硬负样本构建。
研究背景与动机
作者指出,以 CLIP 为代表的对比训练视觉 - 语言模型(VLMs)在学习联合图像 - 文本表示方面取得了显著进展,但在**组合理解(compositional understanding)**方面仍面临挑战。论文认为,这些模型往往表现出“词袋(bag-of-words)”行为,难以捕捉对象关系、属性 - 对象绑定以及词序依赖。
例如,模型可能无法区分“马在吃草”和“草在吃马”,或者混淆“黑狗和白猫”与“白狗和黑猫”的描述。作者分析认为,这种局限性不仅源于优化依赖于全局单向量表示,还源于未能充分利用配对图像 - 文本数据中固有的丰富组合信息。
现有的改进方法多侧重于构建具有细微语义差异的硬负样本(hard negative samples),如基于规则的模板、LLM 生成的标题或合成场景。然而,作者指出这些方法往往成本高昂、存在噪声,且可能导致模型过度关注特定负样本的表层模式,甚至引发对语义等价标题的错误排序。因此,论文提出一个关键问题:除了挖掘硬负样本外,是否可以通过设计训练框架来更好地利用现有图像 - 文本对中固有的对齐组合信息来提升 VLM 的组合性?
核心方法:MACCO 框架
为了解决上述问题,作者提出了 MACCO (MAsked Compositional Concept MOdeling) 框架。该框架的核心思想是在一个模态中掩码(mask)组合概念,并基于另一个模态的完整上下文信息对其进行重建。
跨模态掩码与重建
如图 1 所示,MACCO 方法通过在文本模态中掩码组合概念词(如动作、属性),利用完整的图像特征进行重建;反之,在图像模态中掩码对应组合概念的图像区域,利用完整的文本特征进行重建。这种设计旨在让模型更有效地捕捉和对齐跨模态的组合结构。
在重建过程中,作者特别强调了对文本编码器能力的提升。由于先前的研究表明对比 VLM 在捕捉对象关系和属性绑定方面存在文本编码器的局限性,因此在训练过程中,作者对两个预测器中的图像特征梯度进行了停止(stop-grad),确保损失函数专注于优化文本表示。
辅助损失函数与架构
为了促进这种掩码跨模态重建,论文引入了两个新的辅助目标函数,其整体架构如图 2 所示。
-
掩码增强跨模态对齐损失 (Masked-augmented Cross-Modal Alignment Loss, MCA): 该损失将掩码文本或掩码图像的全局特征整合到跨模态对比学习过程中,以促进有效的跨模态重建和对齐学习。
-
掩码增强模态内正则化损失 (Masked-augmented Intra-Modal Regularization Loss, MIR): 该损失用于正则化每个模态内掩码实例的全局特征,以防止表示坍塌(representational collapse)。
此外,为了在重建过程中更好地约束全局特征并丰富局部令牌(tokens)的上下文全局语义,作者引入了一种无参数的全局到局部语义注入操作(global-to-local semantic injection operation)。在推理阶段,图像和文本预测器会被移除,仅保留编码器部分。
实验结果与分析
作者在五个广泛使用的视觉 - 语言组合基准(compositional benchmarks)上进行了广泛实验,并使用了四个不同的骨干网络(backbones)进行验证。实验结果表明,MACCO 方法显著增强了 VLM 的组合性。
组合性与句法结构提升
深入分析显示,MACCO 不仅提高了组合理解能力,还增强了模型捕捉句法结构和语义细微差别的能力。模型生成的嵌入更加具有概念感知性(concept-aware),对语义不变扰动表现出更强的鲁棒性,并且能更好地保留细粒度的语言信息。
嵌入相似度分布分析
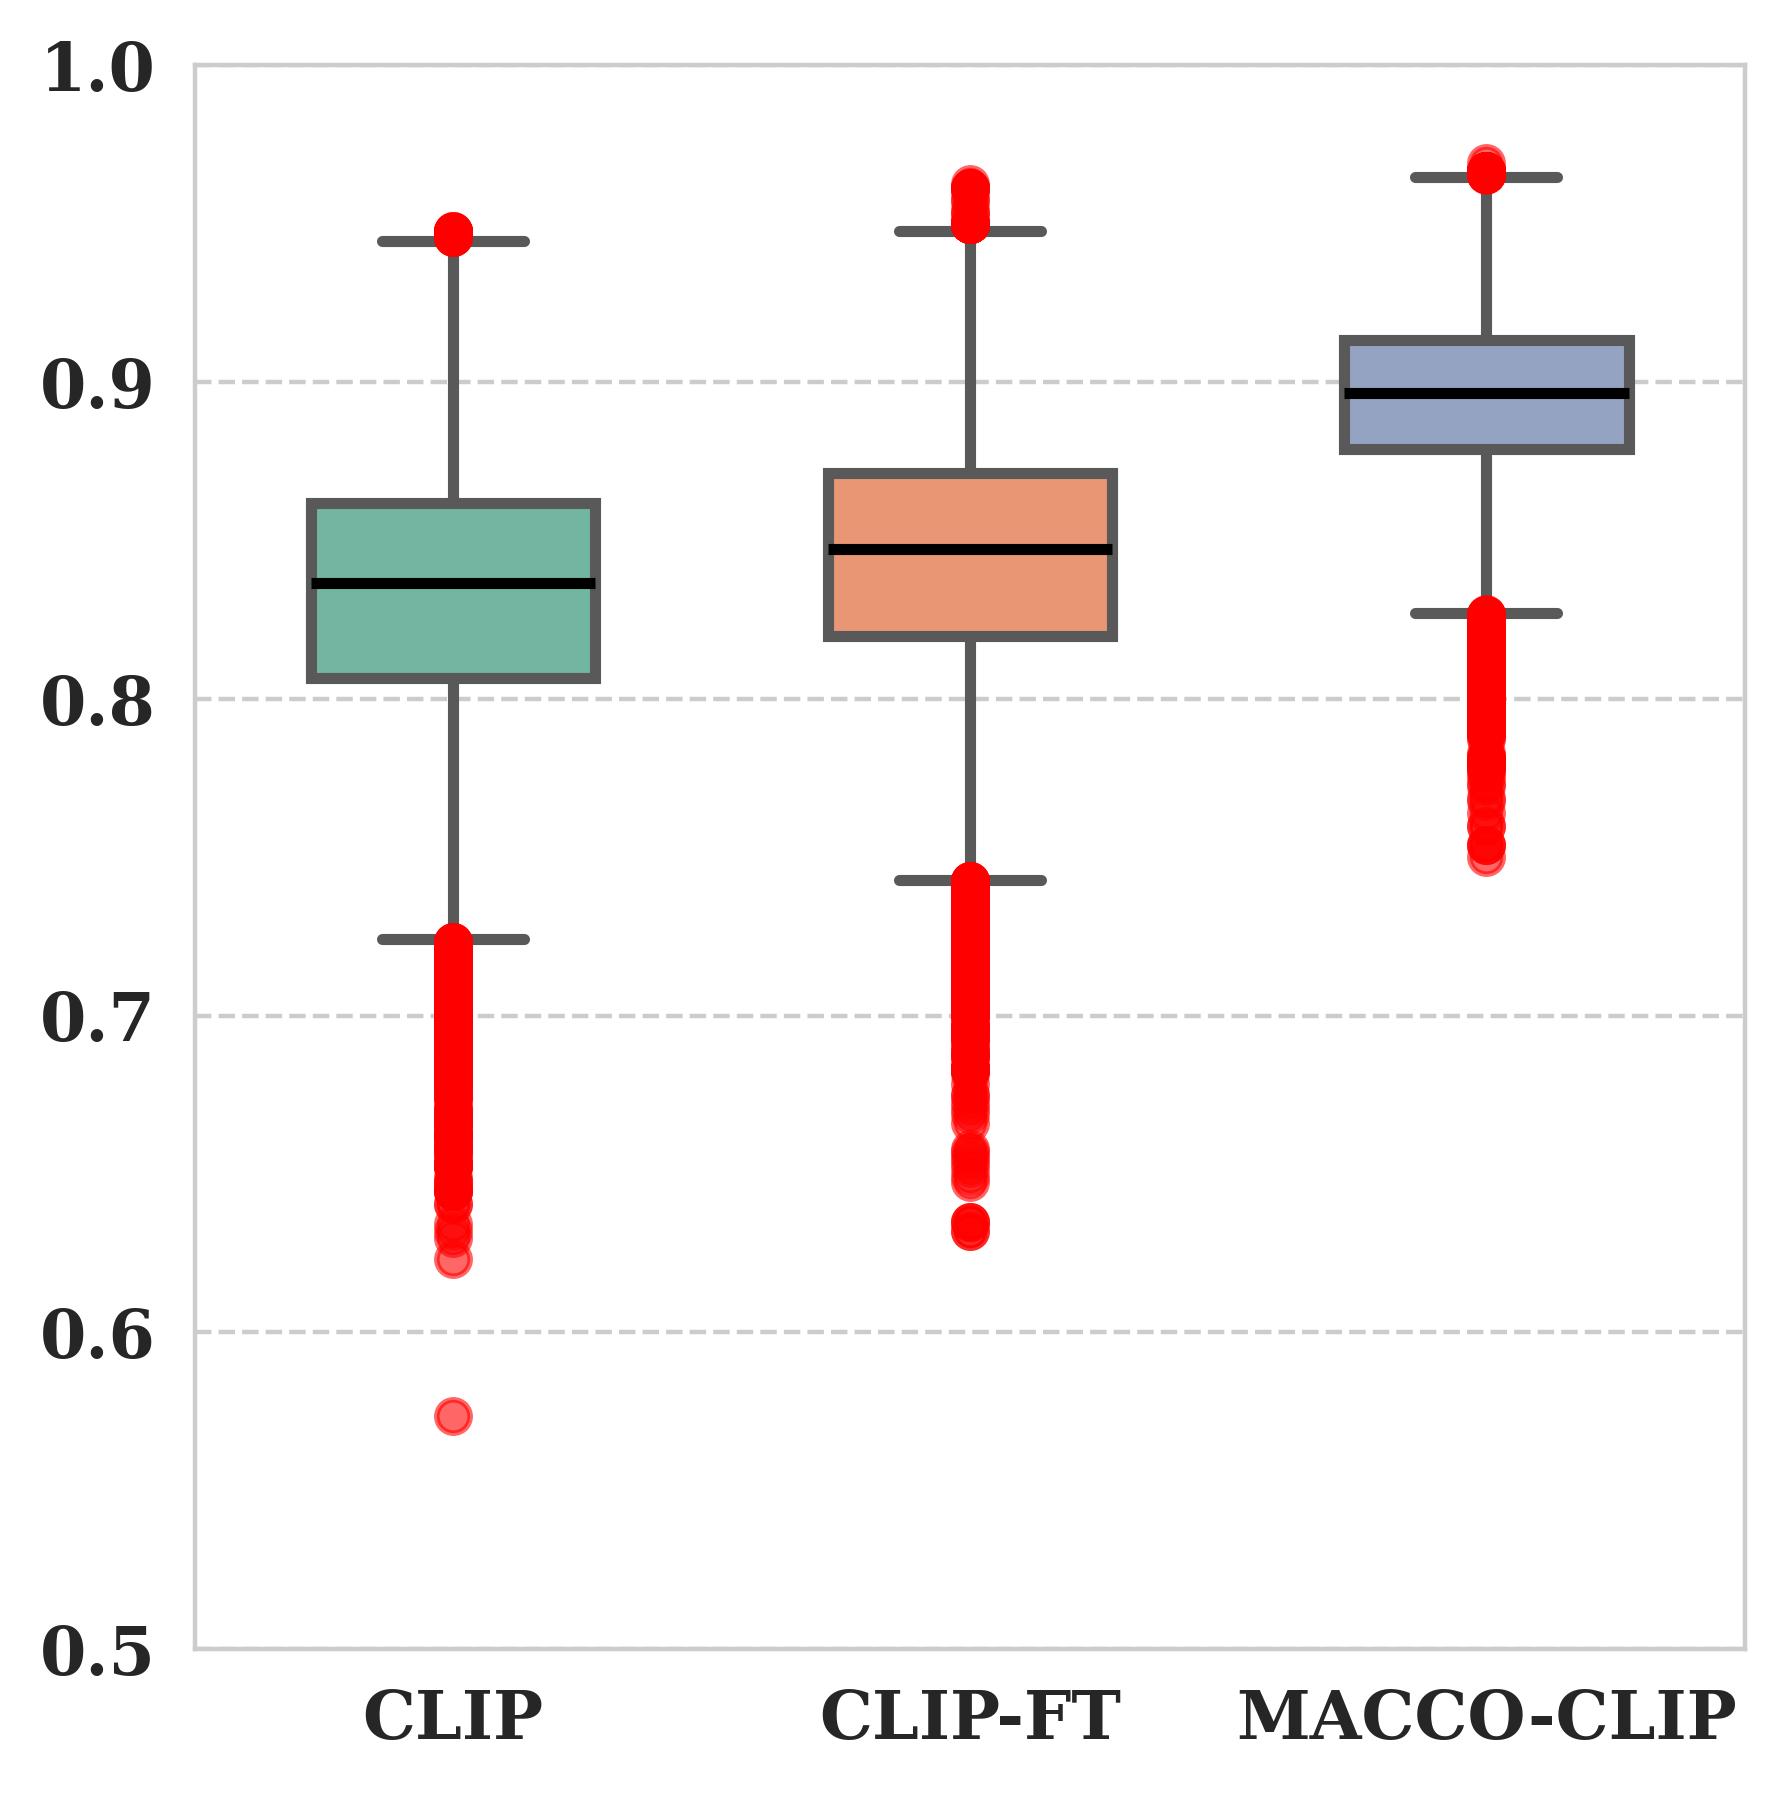
论文还通过可视化分析了嵌入之间的相似度分布。如图 3 所示,作者展示了不同条件下嵌入相似度的分布情况,这有助于理解模型在引入 MACCO 后,其表示空间在区分不同组合概念时的变化。
下游任务增益
除了基准测试,论文还进一步实验表明,改进后的组合性对以下任务也有益:
- 文本到图像生成 (Text-to-Image Generation)
- 多模态大语言模型 (Multimodal Large Language Models)
此外,作者指出 MACCO 框架与现有的硬负样本挖掘方法兼容,结合使用可以获得额外的性能增益。
总结
本文针对现有视觉 - 语言模型在组合理解上的不足,提出了一种无需显式构建硬负样本的 MACCO 框架。通过跨模态掩码概念重建及引入 MCA 和 MIR 两个辅助损失,该方法有效利用了配对数据中的组合信息。实验证明,该方法不仅提升了模型在组合基准上的表现,还增强了句法结构捕捉能力,并惠及下游的多模态生成与理解任务。代码已开源,可供后续研究复现与扩展。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。