Reasoning for Mobile User Experience with Multimodal LLMs: Task, Benchmark, and Approach
作者:Ruichao Mao, Zhou Fang, Teng Guo, Hao Yang, Yaping Li
作者提出了 UXBench 基准和 UI-UX 模型,旨在评估和提升多模态大模型在 UI 截图上的用户体验推理能力。UXBench 包含 2000 个 VQA 样本覆盖 8 个任务,UI-UX 基于 Qwen3-VL 并通过强化学习增强推理过程。
论文信息摘要
论文要解决什么
现有 UI 基准测试主要侧重视觉感知任务,缺乏基于 UI 截图的细粒度 UX 推理评估,导致模型难以检测设计规范与用户心智模型错位引发的问题。
论文方法概览
- Backbone: Qwen3-VL-4B-Thinking
- 关键模块: 奖励路由机制、不对称转换奖励
- 损失函数: GRPO 强化学习损失
读后要点
个人理解,欢迎指正
论文实验表明主流 MLLM 在 UI 推理能力上存在根本性限制,UI-UX 通过动态平衡感知与推理及抑制冗余步骤,在 UXBench 上实现了 SOTA 性能。
局限与疑问
基准数据集规模仅为 2000 样本,依赖专家标注验证,模型在更多样化 UI 场景下的泛化能力有待进一步验证。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.13192v1。
arXiv 论文阅读笔记:Reasoning for Mobile User Experience with Multimodal LLMs
1. 背景与动机
论文指出,在现代人机交互系统中,成功的关键已从单纯的功能实现转向用户体验(UX)的质量。用户体验涵盖可用性、感知一致性和功能清晰度,涉及用户在整个交互旅程中的情感、认知和行为反应。尽管多模态大语言模型(MLLMs)在 UI 理解、生成及用户情感识别方面取得了进展,但基于 UI 截图评估 UX 的研究仍不成熟。
作者认为,现有的 UI 基准测试(如 Screen2Words、Mobile-bench 等)主要侧重于视觉感知任务(如元素检测、布局解析),缺乏基于行为结果、认知心理学和信任动态的目标。这导致当前模型难以检测引发用户错误或负面情绪的设计模式。此外,UX 问题往往源于设计规范与用户心智模型之间的错位,而非可见的布局缺陷,这对多模态模型提出了从“感知界面”到“推断体验”的根本性挑战。
2. UXBench 基准测试
为了解决上述评估缺失的问题,作者提出了 UXBench,这是一个包含 2,000 个 VQA 数据样本的新型多模态基准,旨在评估 MLLMs 进行基于 UI 推理的能力。
2.1 任务设计与维度
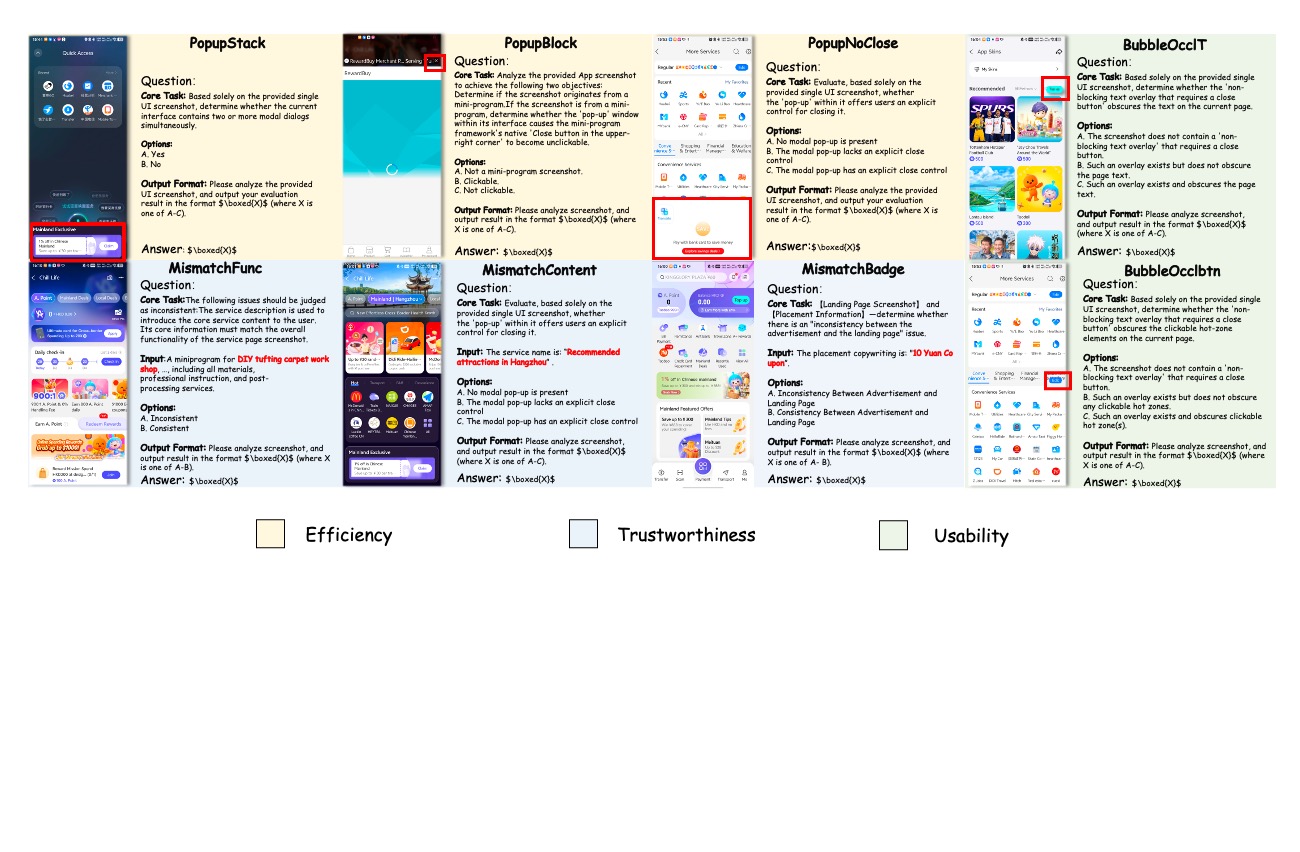
UXBench 基于真实世界的 UI 截图,包含 8 个细粒度诊断任务。这些任务要求模型在布局关系、视觉层次和内容一致性方面进行细粒度的 UX 问题诊断。论文将 UX 问题分为三个维度:
- 可用性 (Usability)
- 效率 (Efficiency)
- 可信度 (Trustworthiness)
如图 1 所示,UXBench 的样本涵盖了上述三个维度。每个案例都需要视觉 - 语义推理来检测 UX 问题(例如重叠的模态窗口、欺骗性内容、缺失的控制按钮)。红色边界框表示用于定量评估的真实缺陷区域。任务涉及推断超出像素级感知的体验后果。
2.2 数据分布与构建
论文通过大规模 MLLM 辅助标注,并结合四轮资深 UX 专家的两轮验证,确保了标签的一致性。图 2 展示了 UXBench 中的数据分布情况,反映了不同任务类别和维度下的样本构成。
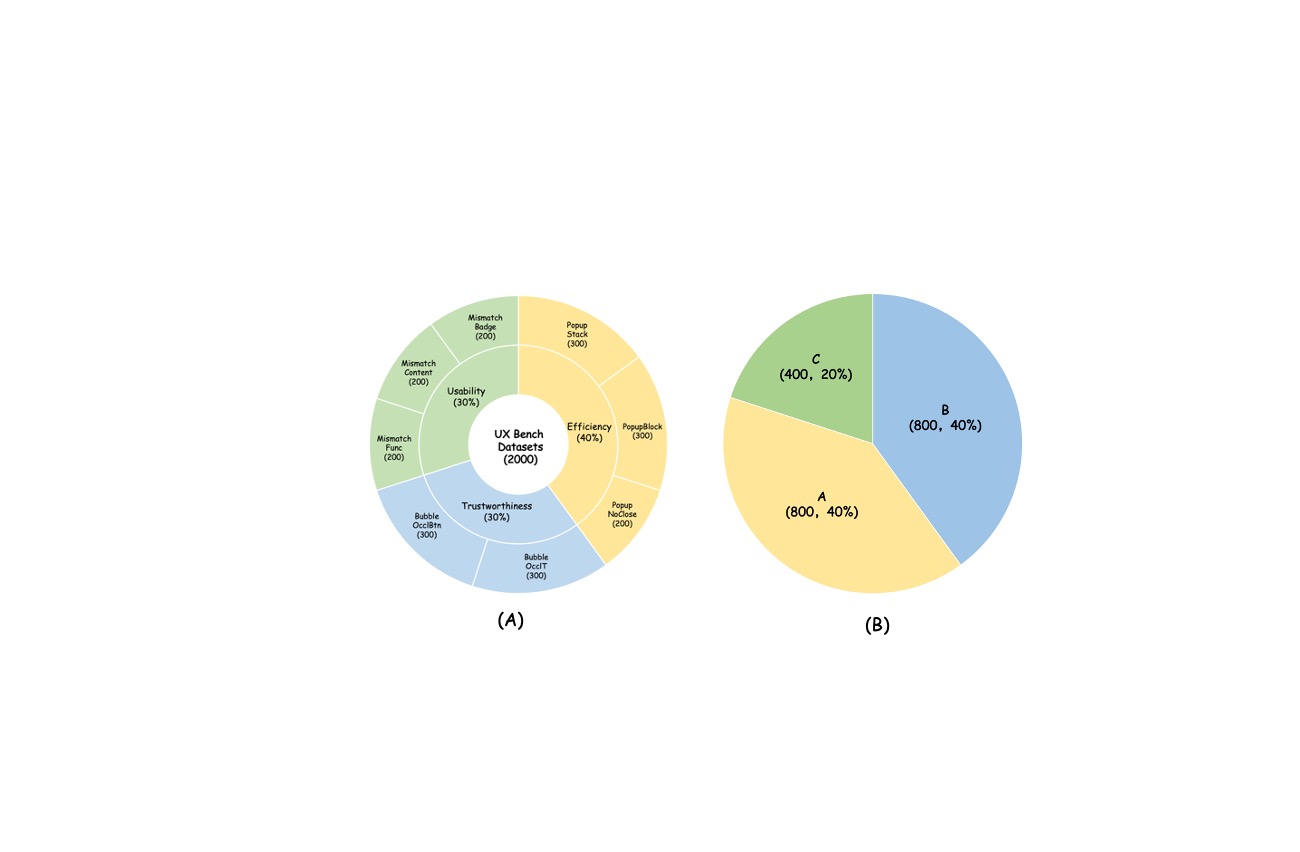
作者指出,现有方法通常依赖手动标注的指令 - 动作对,或将 UX 评估简化为二分类,忽略了 UX 问题的多维性和上下文依赖性。UXBench 中的每个任务都被设计为二选或三选一的问题,要求因果推理并映射到设计原则,而非简单的关键词匹配。
3. UI-UX 模型架构
为了缩小当前模型在 UI 推理能力上的差距,作者提出了 UI-UX,这是一个基于 Qwen3-VL-4B-Thinking 基础模型并通过强化学习(RL)增强的 MLLM。
3.1 训练流程
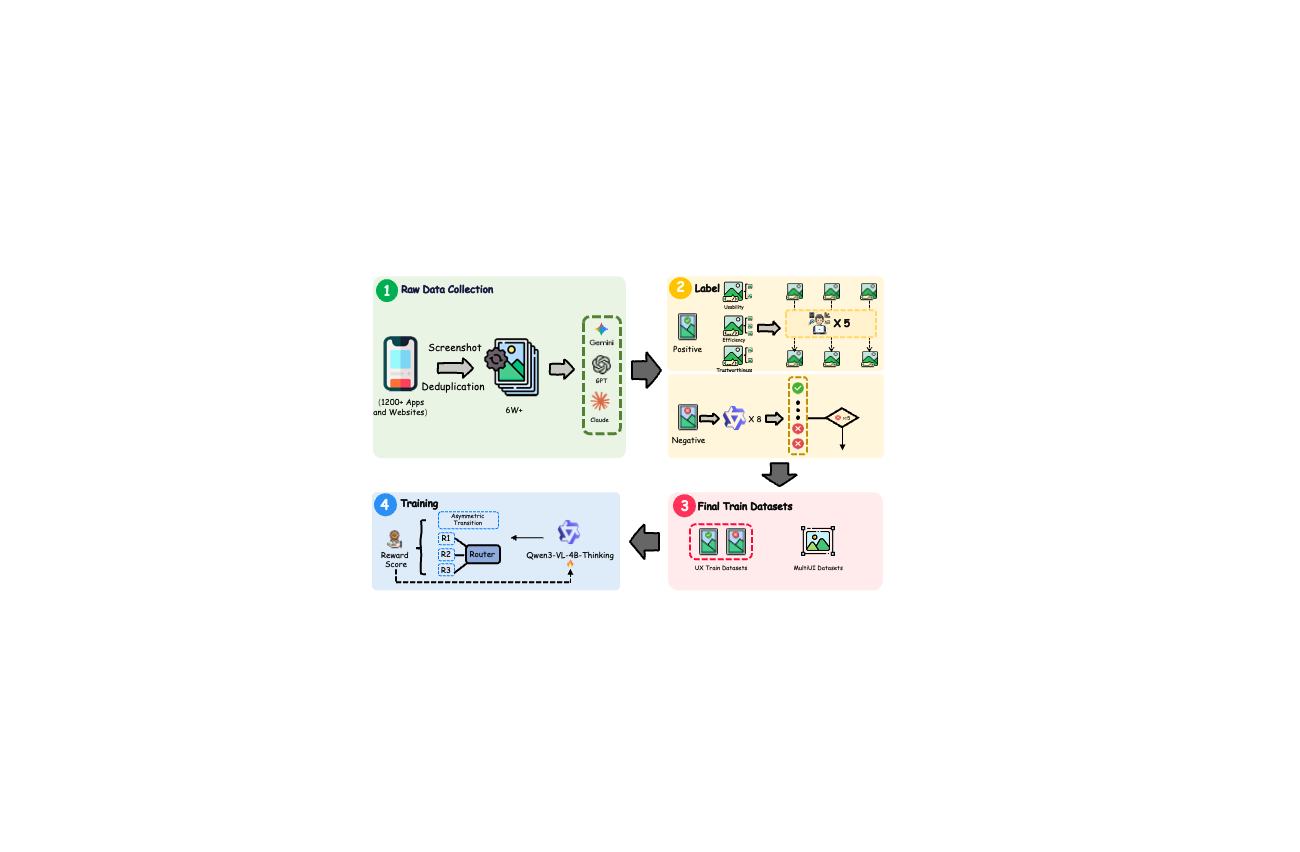
UI-UX 的训练流程如图 3 所示。该框架无需手动偏好标注,通过 GRPO 算法进行端到端优化。训练过程包括原始数据收集、数据增强、奖励路由机制以及不对称转换奖励的应用。
3.2 关键创新点
UI-UX 引入了两项关键创新以提升推理性能:
-
奖励路由机制 (Reward Routing Mechanism): 该机制在推理过程中动态平衡感知理解和逻辑推理。针对 UX 诊断任务使用准确率奖励,针对通用 UI 理解使用 ROUGE-L 分数进行语义对齐,针对定位任务使用命中奖励。
-
不对称转换奖励 (Asymmetric Transition Reward): 该机制旨在抑制冗余或不足的推理步骤,从而减少推理延迟。
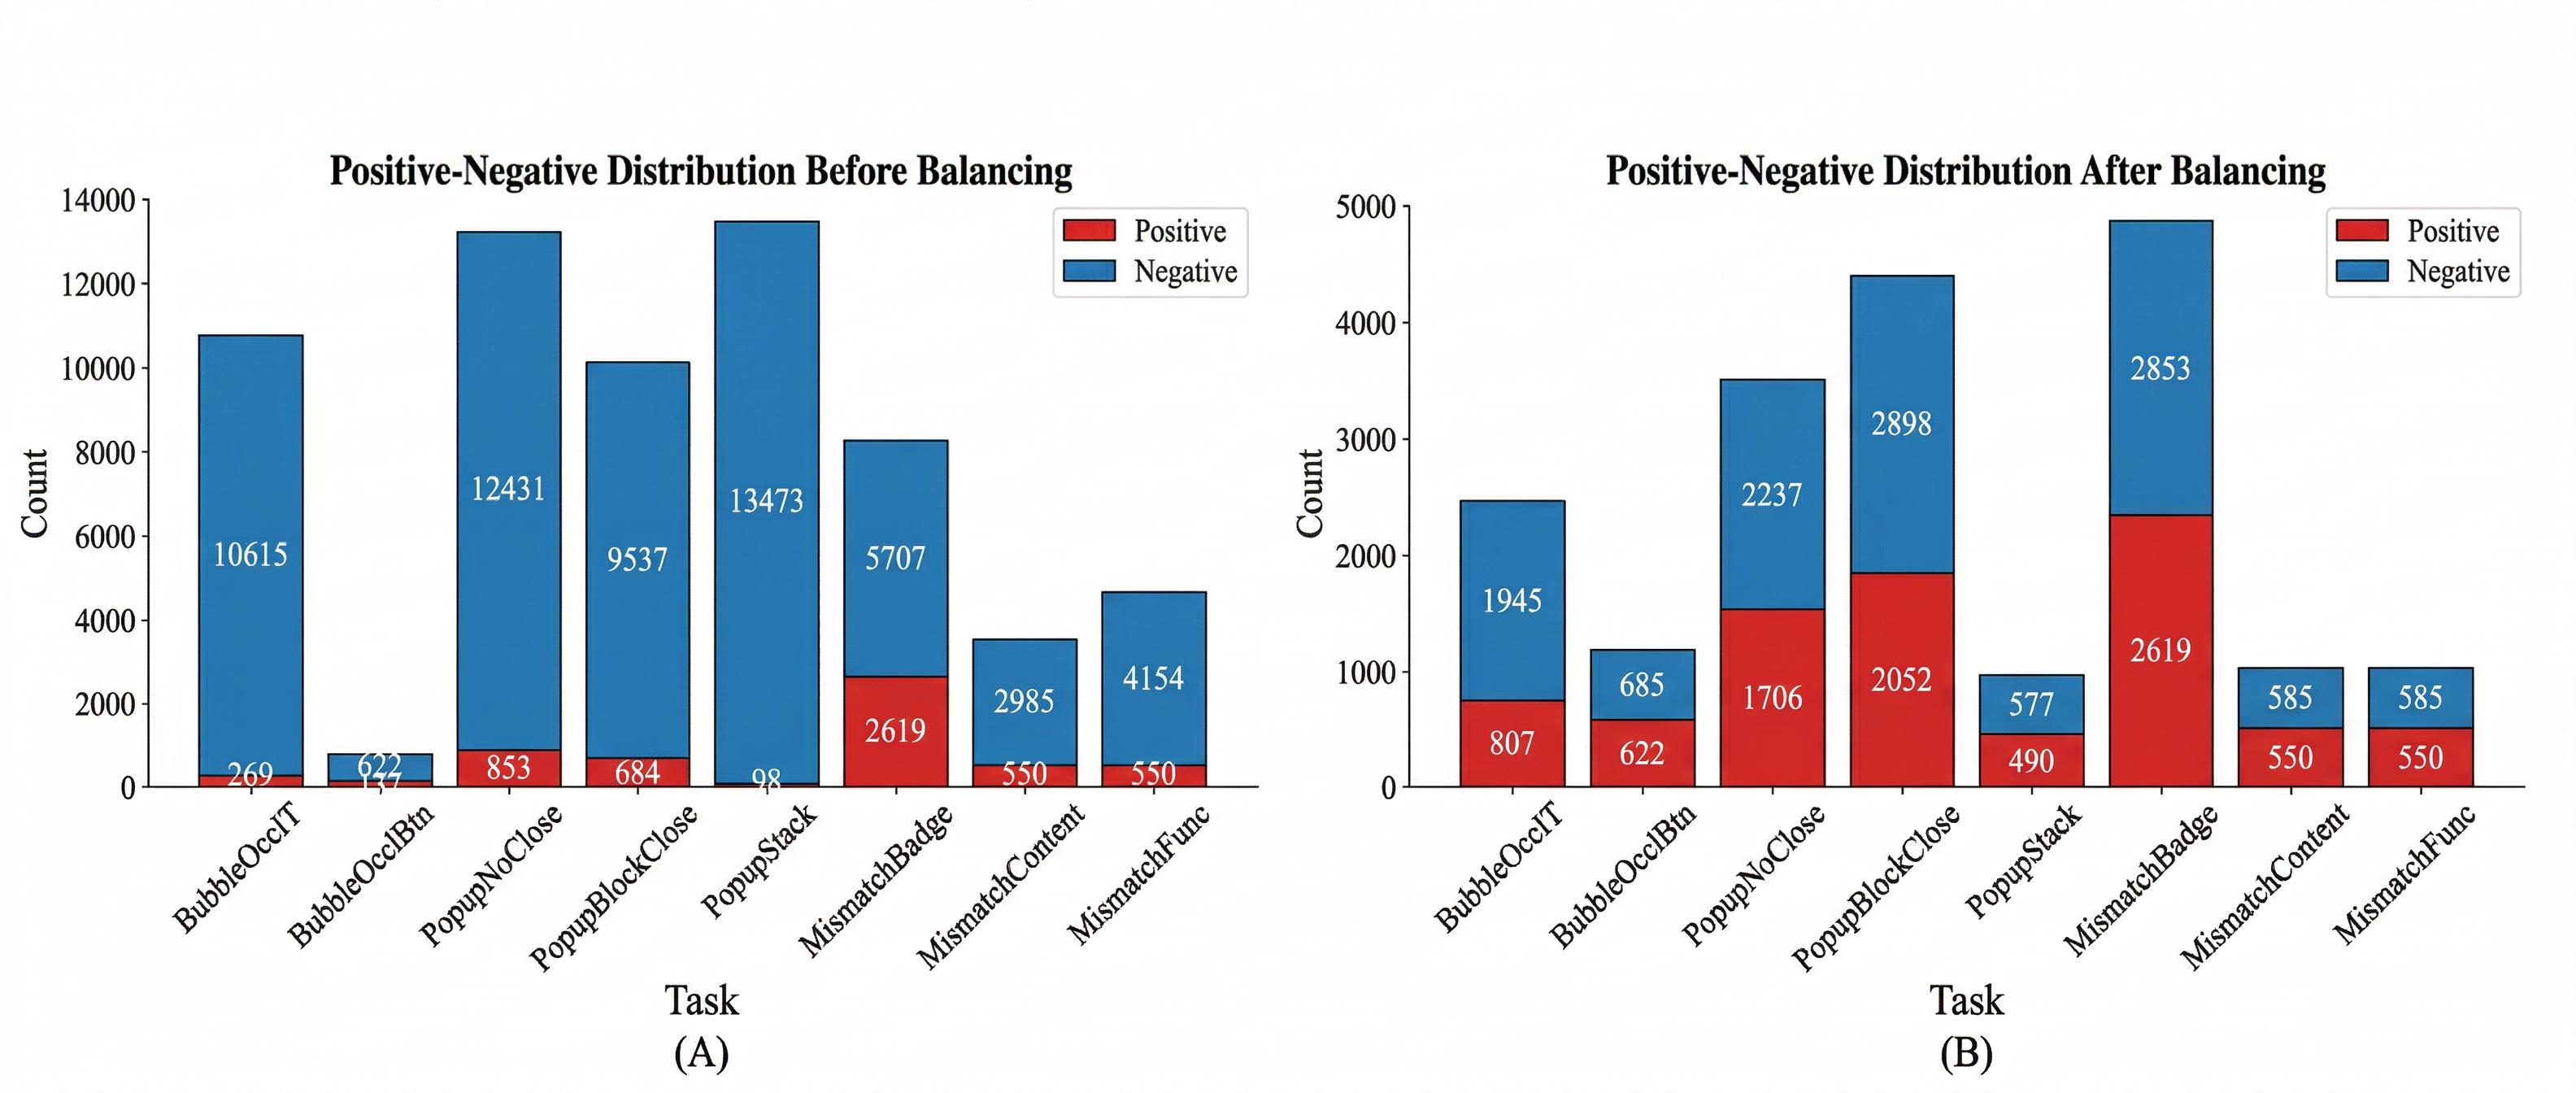
此外,针对真实场景中阳性样本稀缺和极端类别不平衡的问题,作者引入了硬负样本采样和语义保留增强策略。图 4 展示了平衡前后的正负样本分布情况,显示了数据平衡策略对模型训练数据分布的改善效果。
4. 实验结果与分析
论文对主流 MLLMs 进行了广泛评估,结果显示它们在基于 UI 的推理能力上仍存在根本性限制。UI-UX 模型在 UXBench 上取得了最先进(SOTA)的性能。
- 准确率:UI-UX 在 UXBench 上的准确率达到 0.7963。
- 对比表现:这一成绩超越了 Claude-4.5-Sonnet 的 0.6550。
- 泛化能力:实验表明 UI-UX 在多样化的 UI 任务上表现出强大的泛化能力。
- 效率:模型在保持高性能的同时,维持了较低的推理延迟。
作者强调,仅对齐视觉和文本不足以实现真正的 UX 理解,模型需要在语义关联、反事实推理和意图建模方面取得进步。UI-UX 通过强化学习框架有效解决了这些问题,实现了超越人类专家的 MLLM UX 推理性能。
5. 总结
本文的主要贡献在于:
- 首个 UX 推理基准:提出了 UXBench,定义了 8 个细粒度、可评估、以用户为中心的 UI 诊断任务,填补了该领域的关键空白。
- 奖励路由策略:引入了硬负样本采样和语义保留增强策略,解决了真实场景中的样本稀缺和类别不平衡问题。
- 高效推理模型:提出的 UI-UX 模型结合了奖励路由和过度思考惩罚,实现了低延迟、高鲁棒性的 UX 推理能力。
论文认为,未来的研究需要进一步关注从视觉感知到体验推断的跨越,以支持更智能的 UI 设计评估、自动化测试和设计辅助系统。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。