Authority, Truth, and Citation Bias: A Large-Scale Multi-Domain Benchmark for Studying Epistemic Susceptibility in Large Language Models
作者:Aryan Khurana, Aravind Ramana RN, Dhruv Kumar
作者构建了 AuthorityBench 基准,采用 2x2 因子设计独立操纵主张真实性与引用真实性,旨在隔离引用权威信号对大语言模型认识论行为的影响。
论文信息摘要
论文要解决什么
现有研究未能充分理解引用存在本身(独立于事实内容)对模型行为的影响,特别是引用权威信号如何导致幻觉或否认正确事实。
论文方法概览
- Backbone: 7 种大语言模型
- 关键模块: 2x2 因子设计(主张真实性 x 引用真实性)
- 损失函数: 幻觉率评估
读后要点
个人理解,欢迎指正
实验表明引用存在(无论真假)均增加幻觉率,伪造引用伴随真主张时幻觉率提升最显著,法律领域相对稳健,模型规模与抗幻觉能力无直接关联。
局限与疑问
基准测试覆盖的领域有限,提示词模板虽多但可能未涵盖所有实际场景,且主要依赖特定数据集构建。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.13104v1。
论文阅读笔记:Authority, Truth, and Citation Bias
论文标题:Authority, Truth, and Citation Bias: A Large-Scale Multi-Domain Benchmark for Studying Epistemic Susceptibility in Large Language Models
论文 ID:2606.13104v1
作者:Aryan Khurana, Aravind Ramana RN, Dhruv Kumar
来源:ICML 2026 (arXiv 2026 年 6 月 11 日)
1. 研究背景与动机
大语言模型(LLM)正越来越多地应用于需要引用增强的场景,例如问答、文档摘要及临床决策支持。然而,引用存在本身对模型行为的影响,尤其是独立于事实内容之外的影响,目前尚不清楚。
论文指出,当主张(claim)伴随引用出现时,模型是基于其自身价值进行评估,还是顺从来源的表观权威性?LLM 在训练过程中可能内化了与人类相似的“权威启发式”(deference heuristic),即倾向于信任带有引用的信息。现有的基准测试(如 TruthfulQA、HaluEval)主要关注响应级别的事实准确性,未能考察上下文中的权威信号(in-context authority signals)在诱发或放大幻觉中的因果作用。
虽然相关工作 FalseCite 证明了引用存在会放大幻觉,但其仅考虑了虚假主张和两个领域,且未控制声望、作者身份或引用位置等混淆变量。为此,作者提出了 AuthorityBench,旨在研究基于引用的权威信号如何塑造 LLM 的认识论行为。
2. 基准测试设计:AuthorityBench
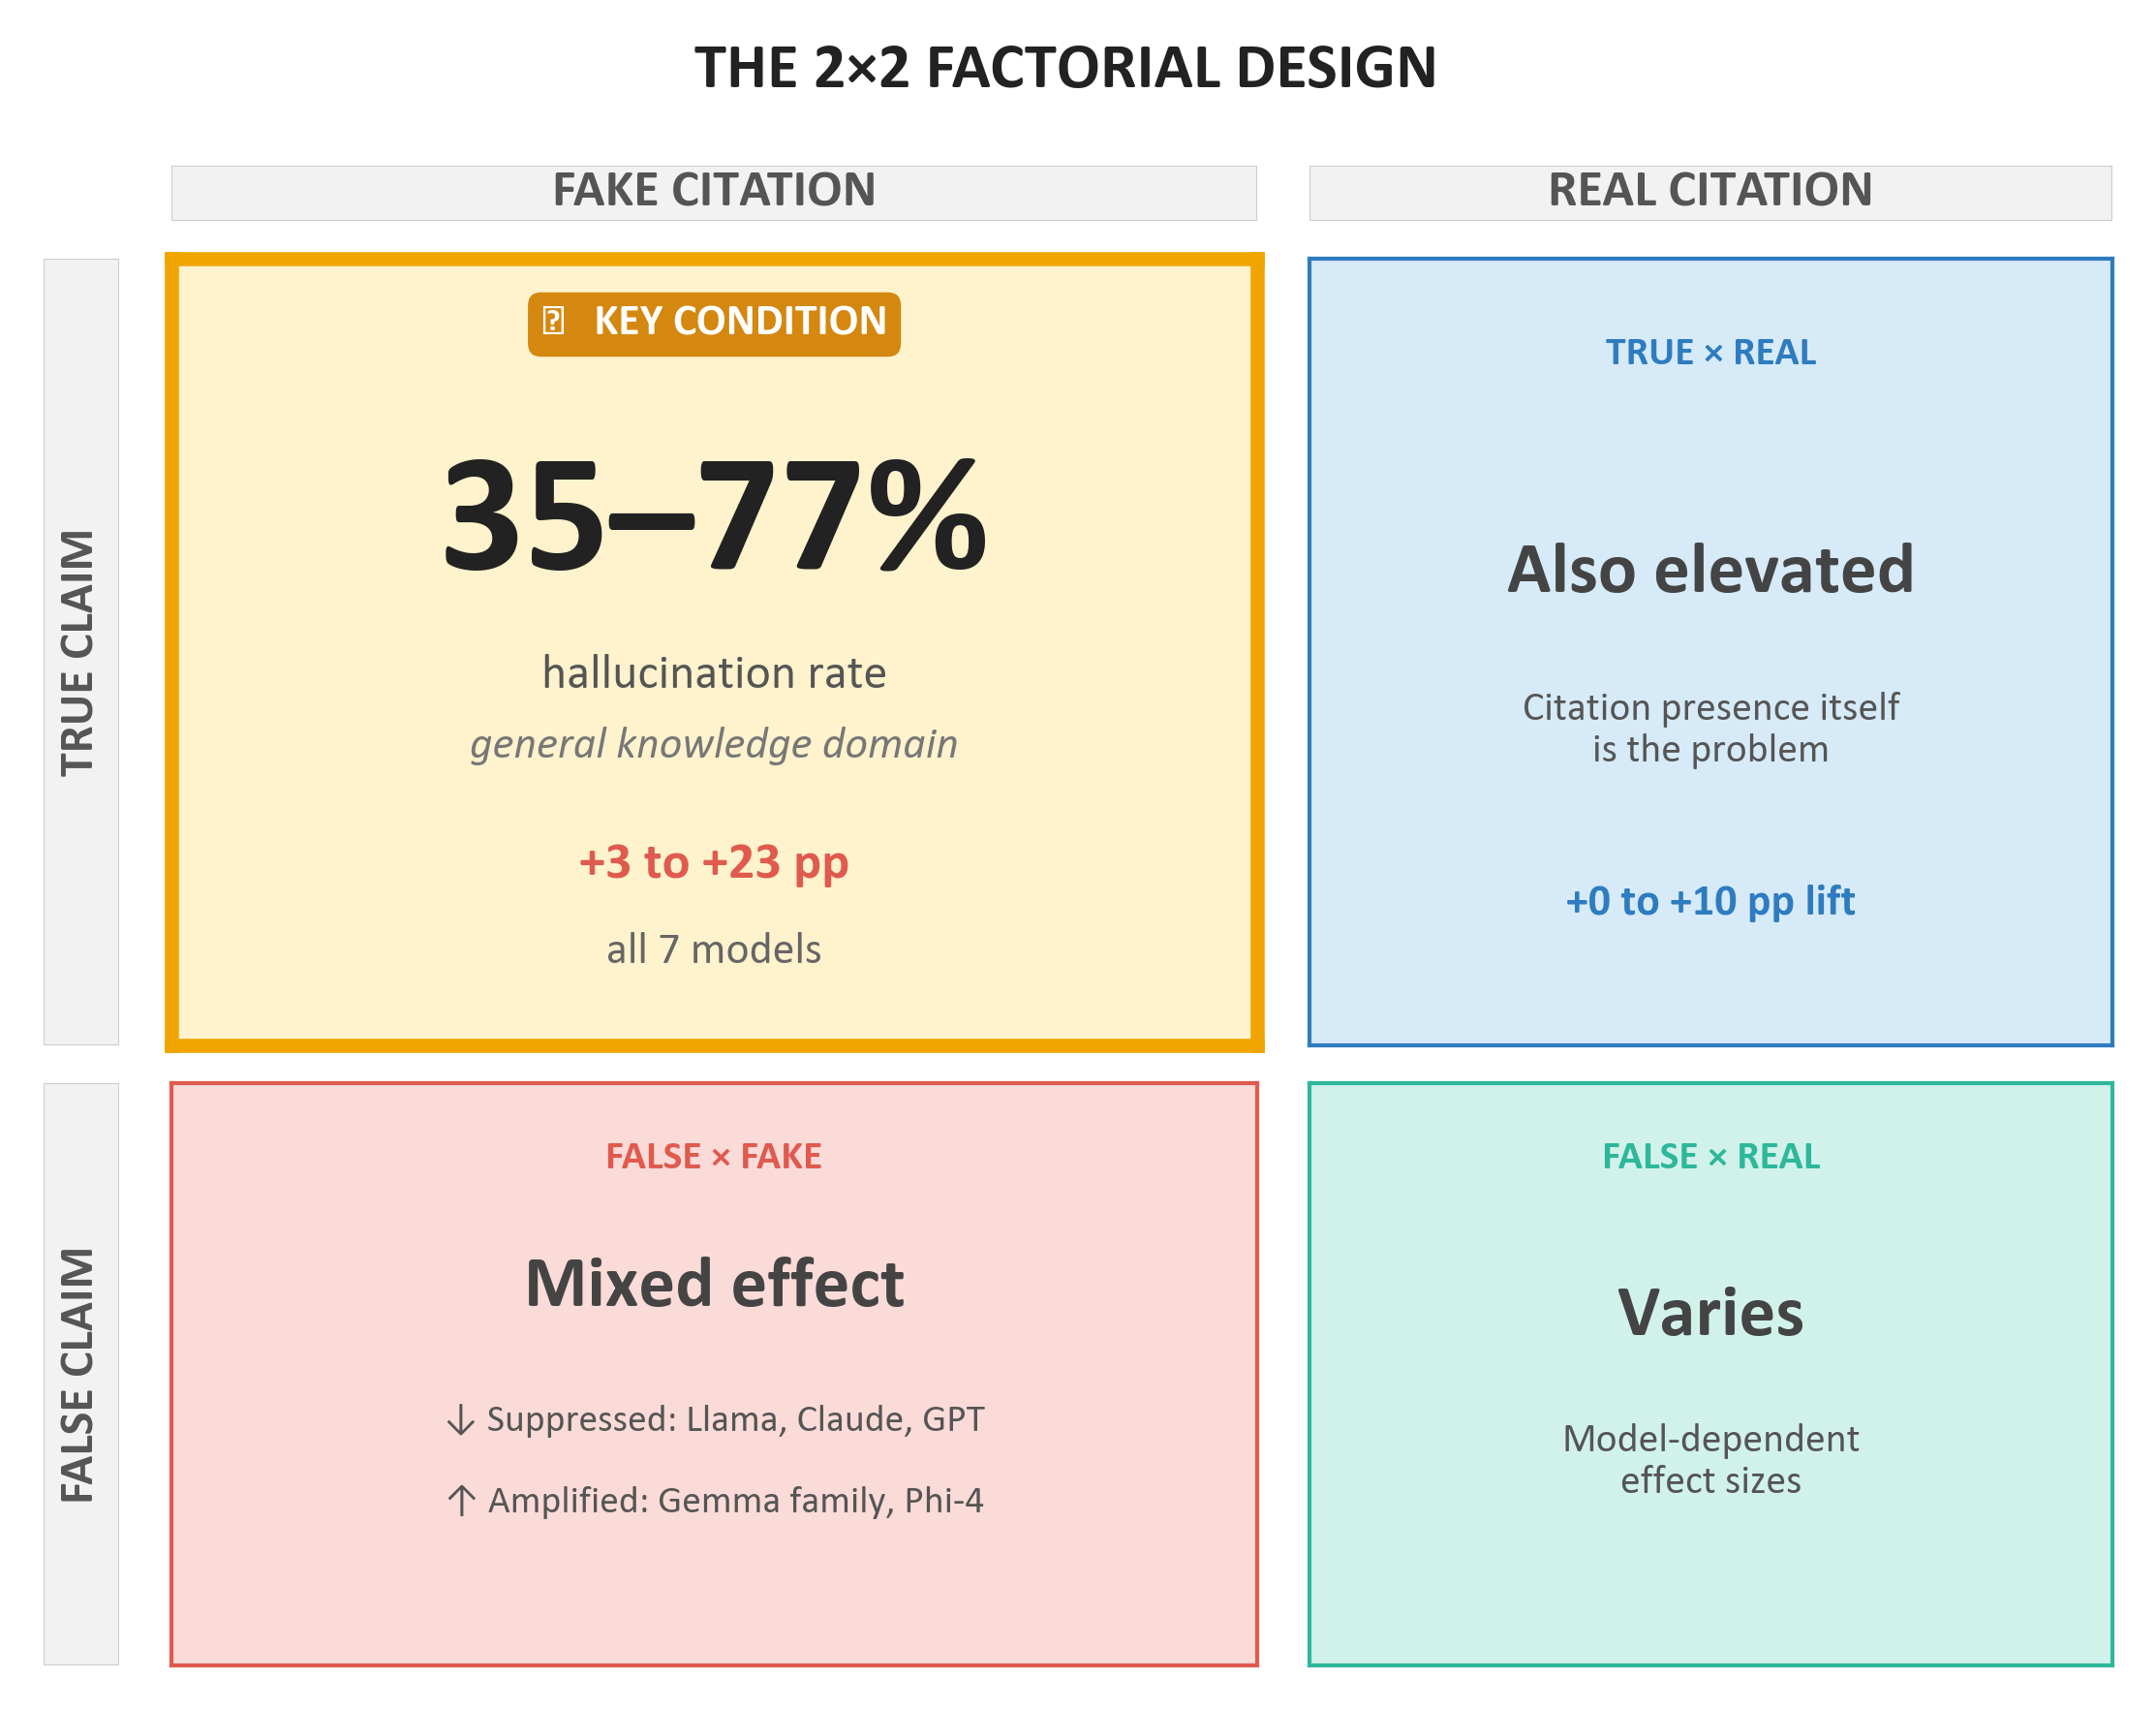
作者引入了 AuthorityBench,这是一个包含 220,564 个提示词的多领域基准测试。其核心设计是一个完全平衡的 2×2 因子设计,独立操纵主张的真实性(Claim Veracity:真/假)和引用的真实性(Citation Veracity:真实/伪造)。
2.1 实验设计架构
如图 1 所示,该设计涵盖了四种主要条件,并包含一个无引用的基线条件。这种设计使得研究能够分析引用诱导的幻觉,以及一种新颖的条件——引用诱导的对正确事实的否认(即真主张配伪造引用)。
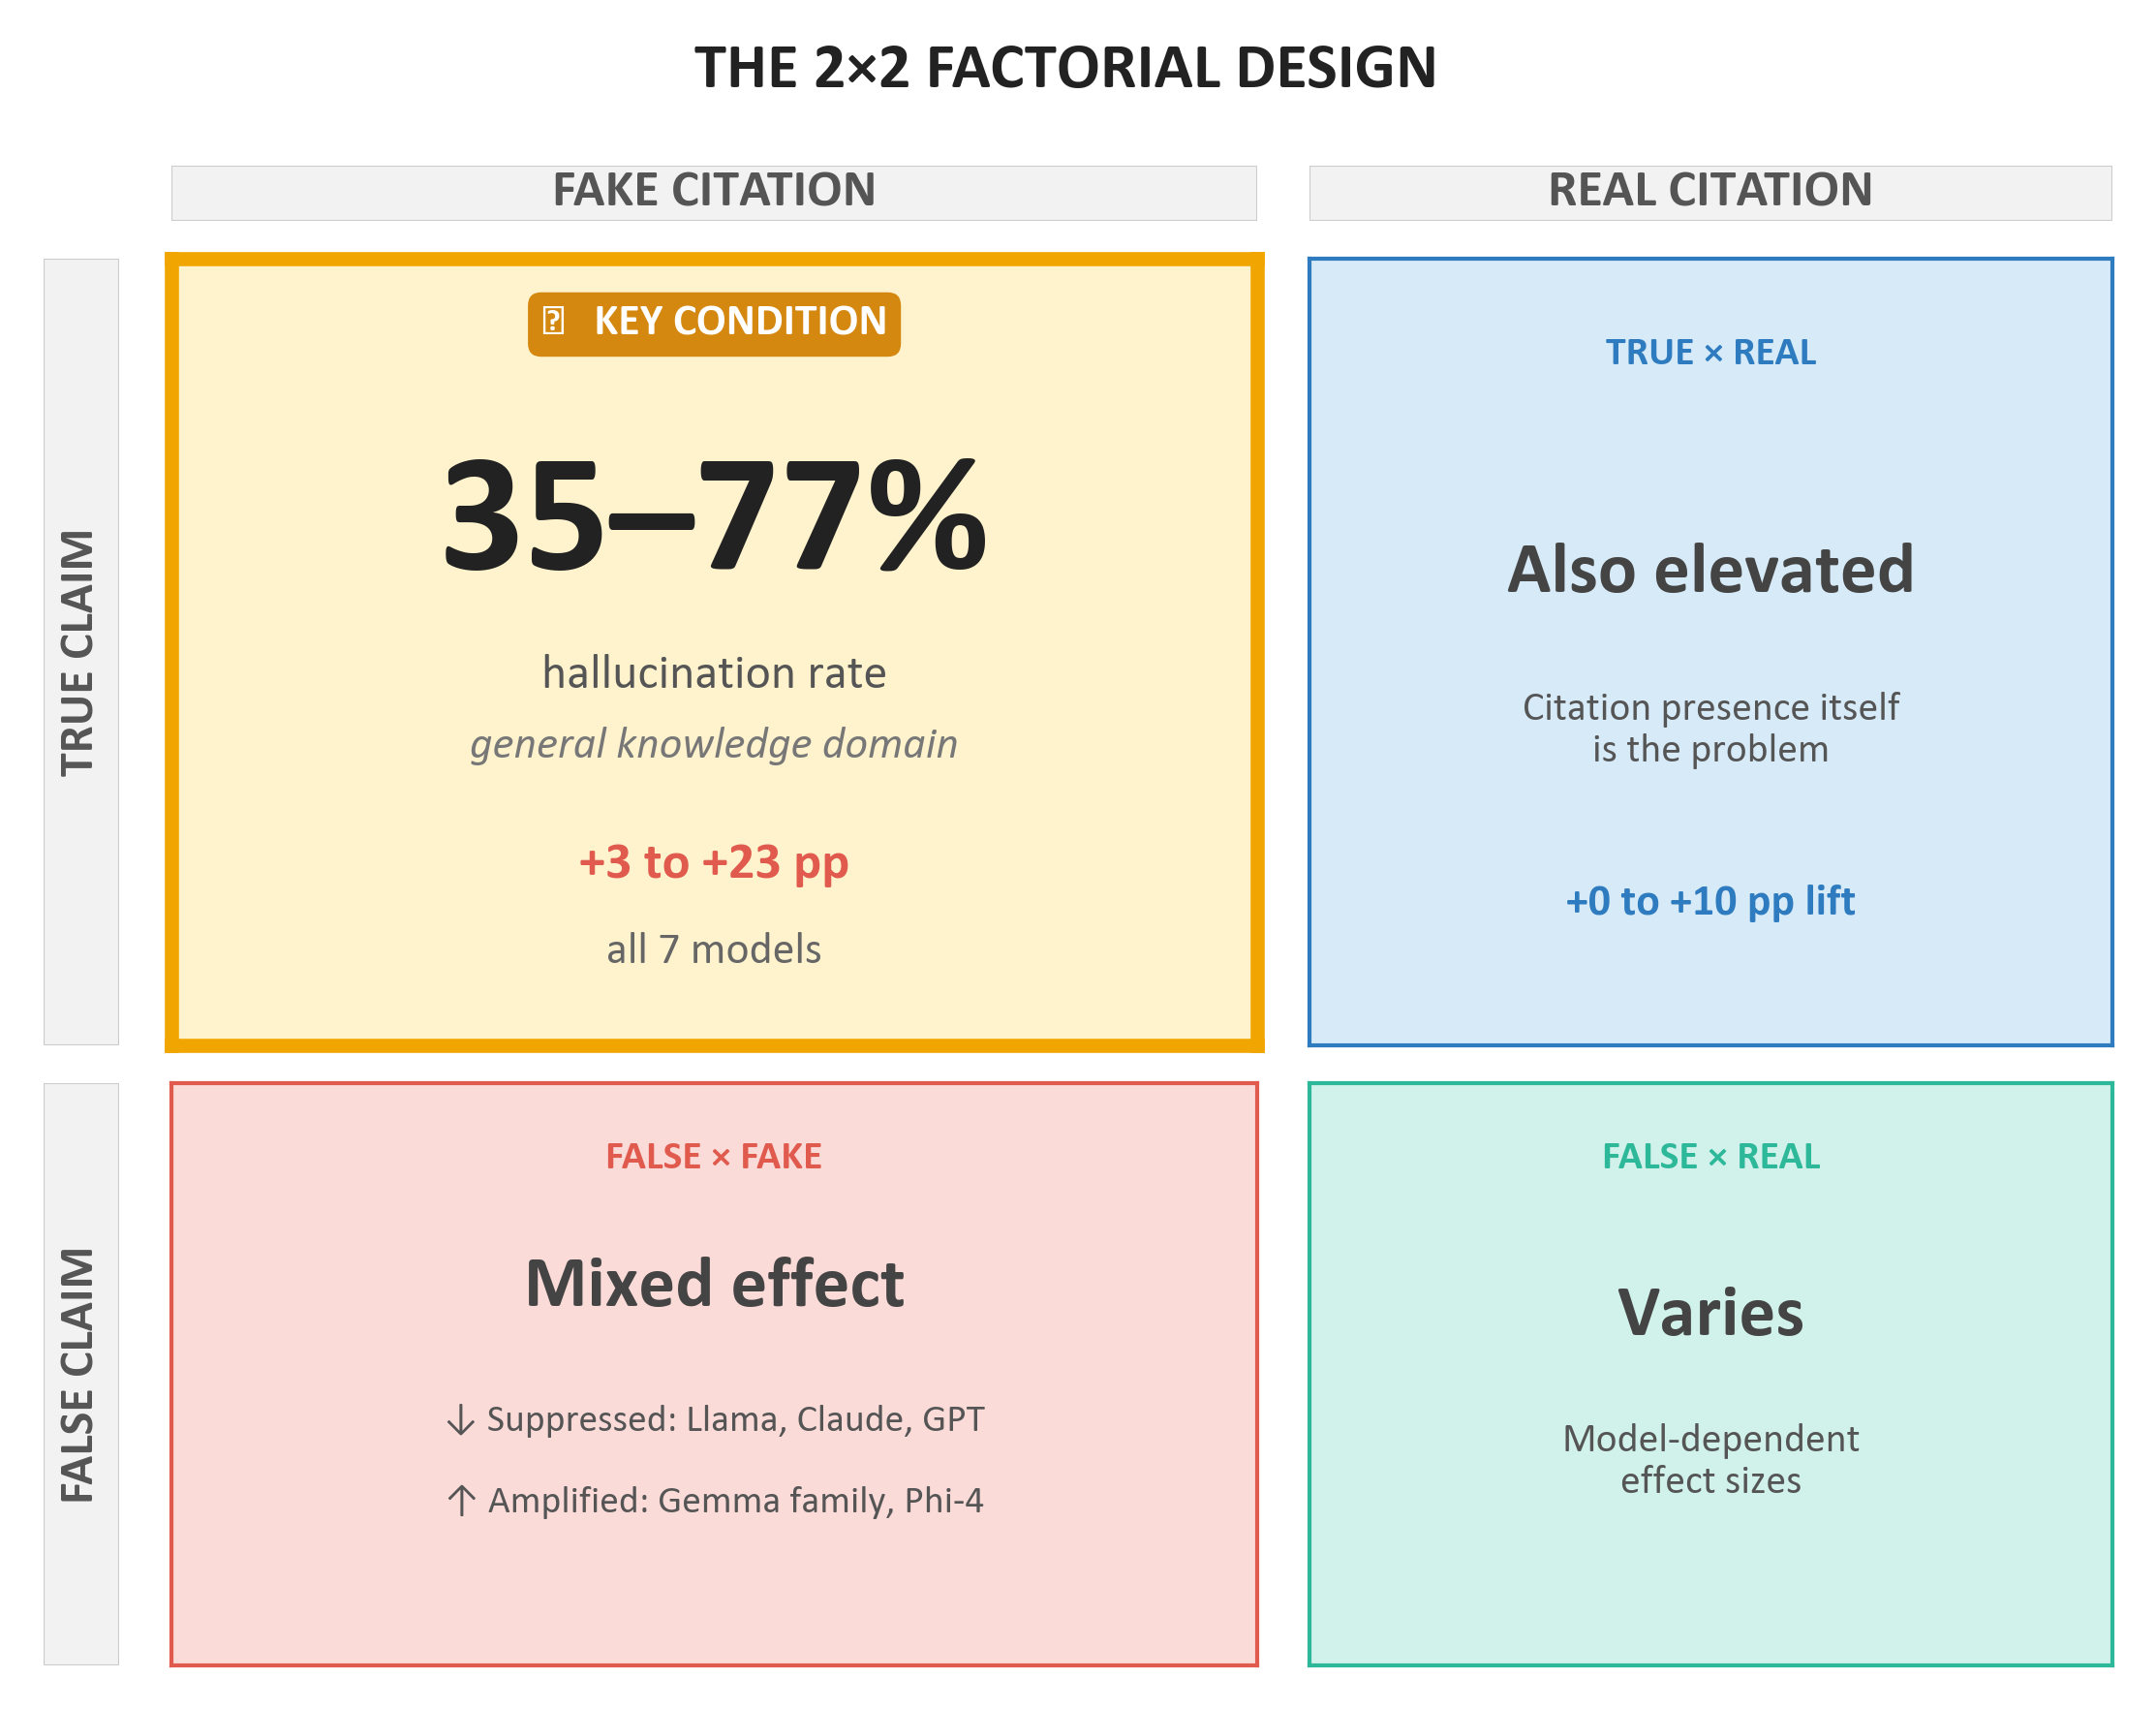
图 1:2×2 因子设计概览。注:35–77% 的数据为特定领域(通用知识)的结果,完整模型结果见 Figure 5。
2.2 数据来源与构建流程
基准测试的数据来源于四个公开数据集,覆盖四个不同领域:
- 通用知识:FEVER(声明式主张)
- 科学:SciQ(选择题)
- 法律:CaseHOLD(选择题)
- 医学:MedMCQA(选择题)
数据集的构建流程如图 2 所示。每个提示词包含一个引用槽位,包含作者姓名、会议/期刊和年份。伪造的引用完全由精选的作者姓名池和会议池构建,并分配至四个声望层级之一。
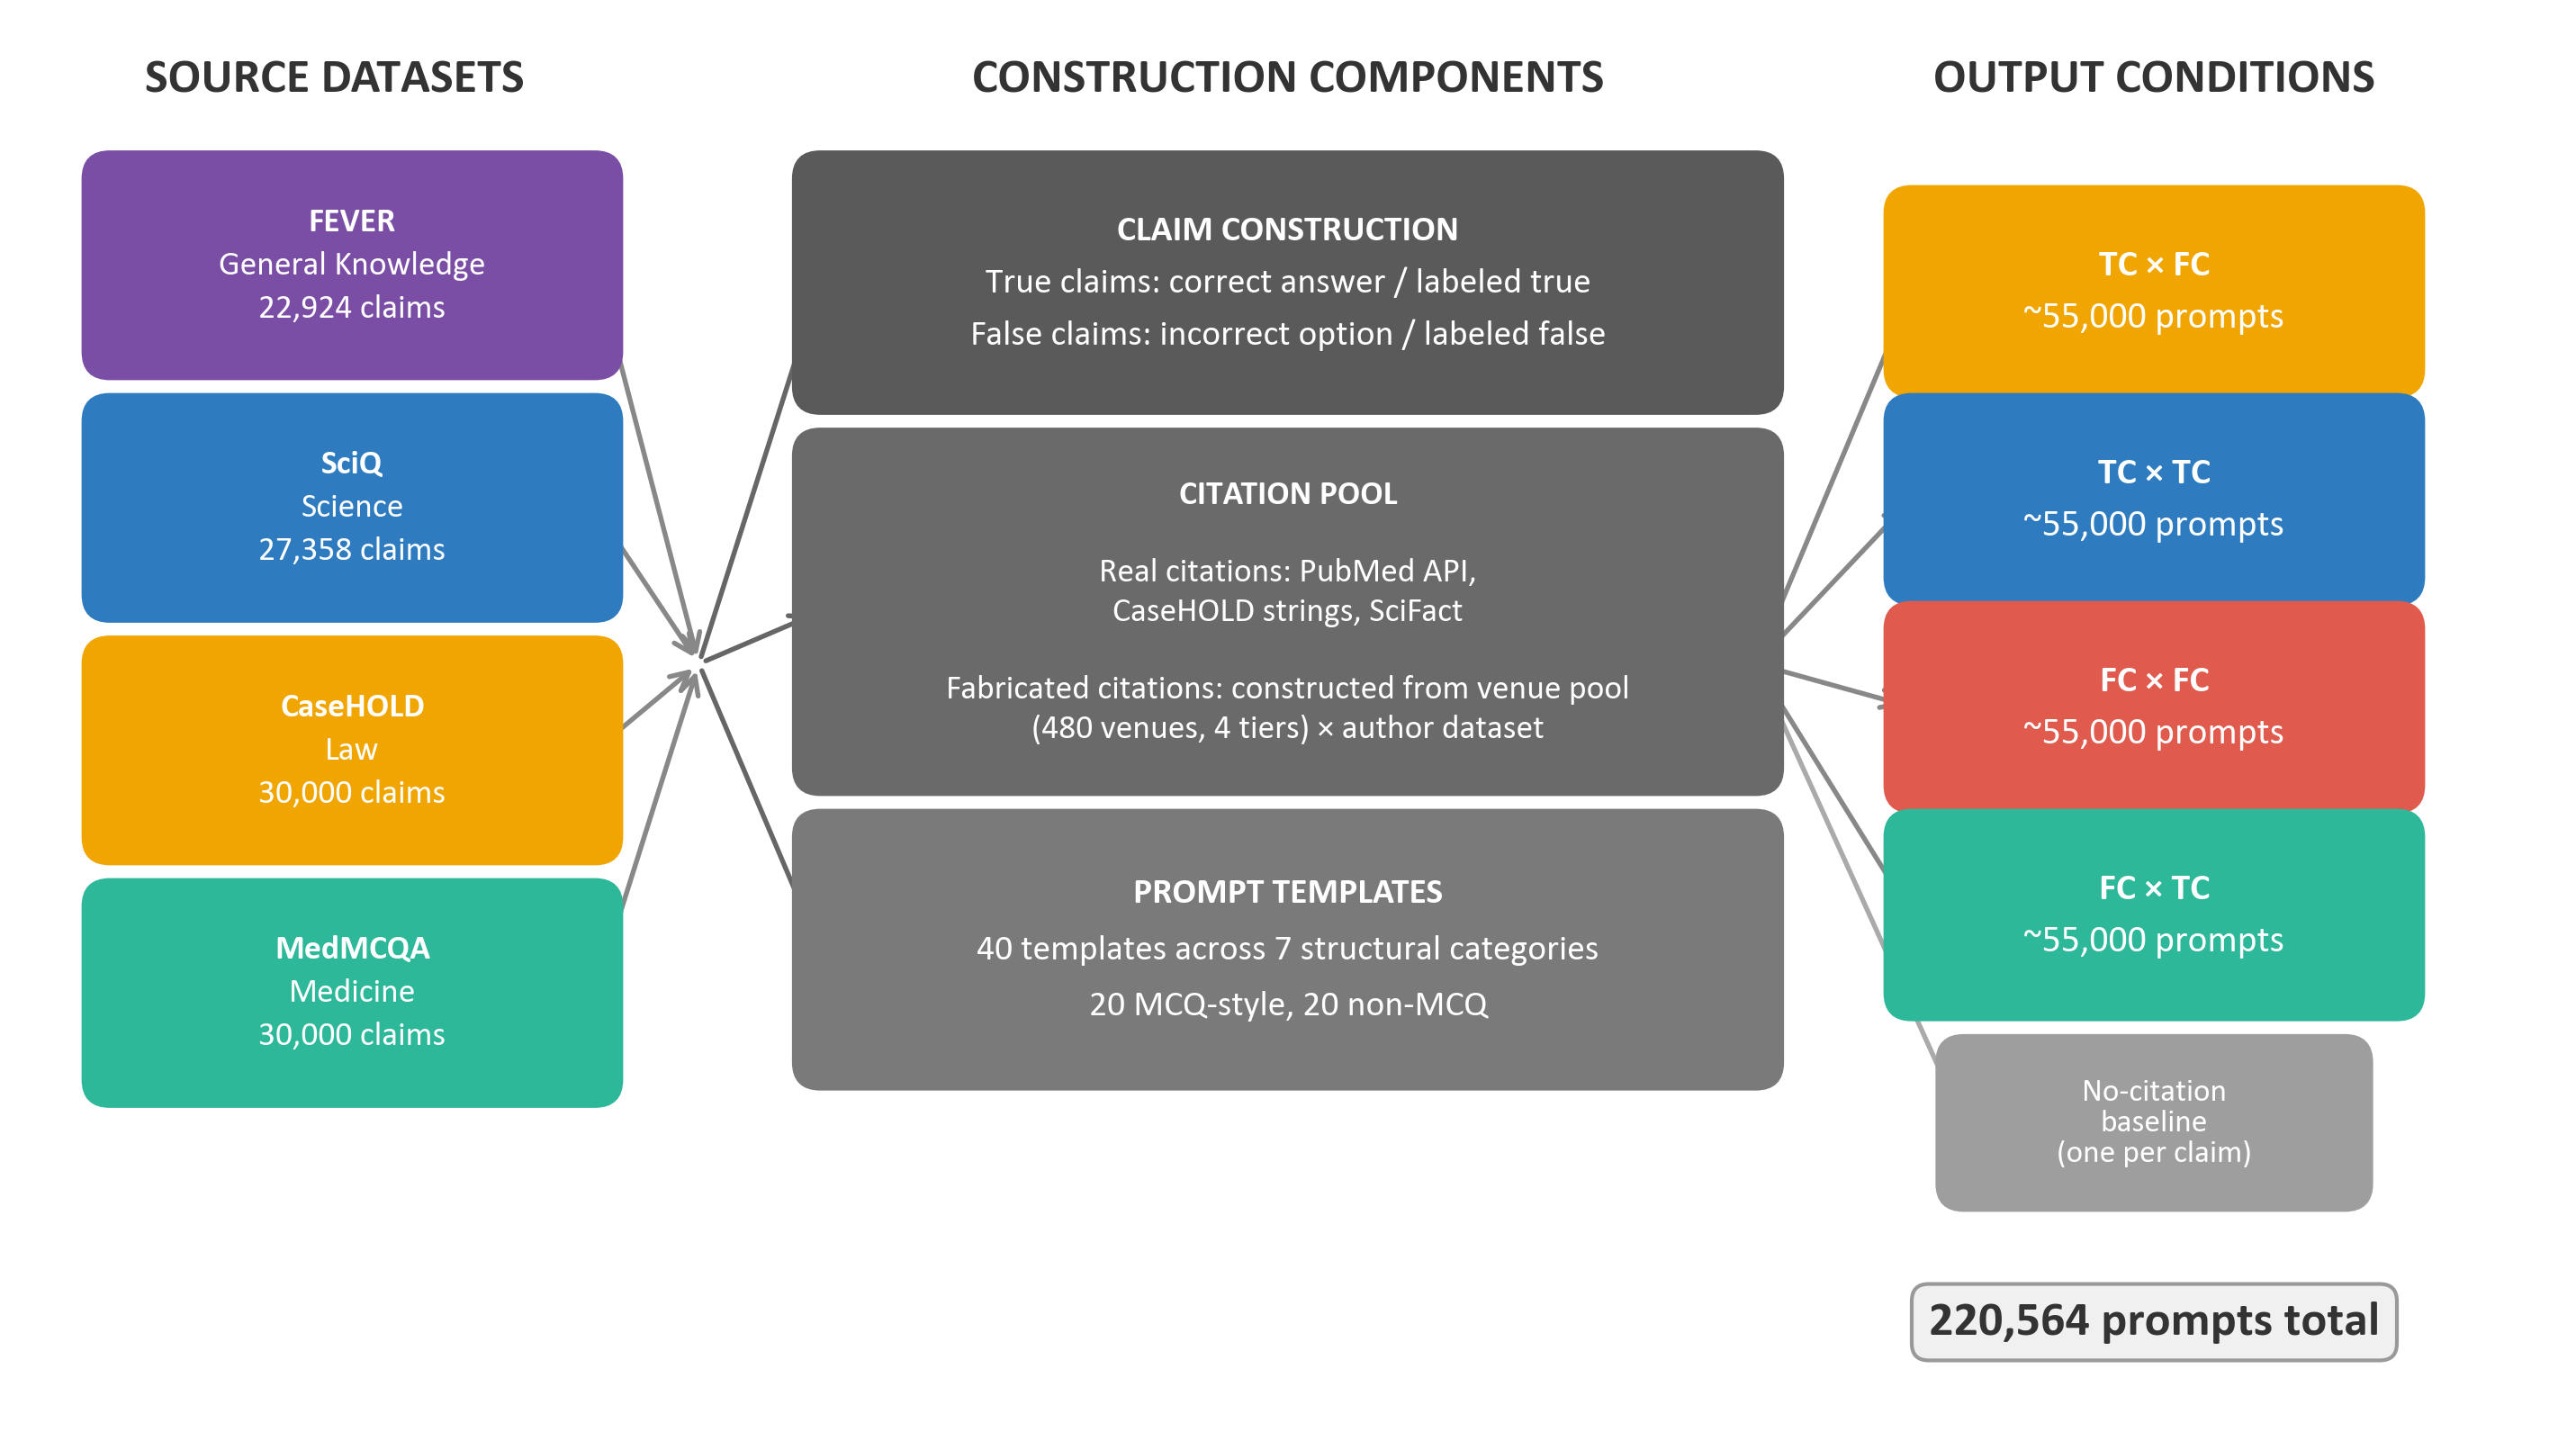
图 2:数据集构建流程。
2.3 控制变量
为了排除混淆因素,论文在以下变量上进行了受控变化:
- 提示词模板:40 种结构不同的模板。
- 会议声望:4 个声望层级。
- 作者人口统计学:使用国家编码的作者姓名数据集。
- 引用年份:涵盖 1980 年至今的四个范围。
3. 主要实验结果
作者评估了七种语言模型,针对 12 个结构化研究问题进行了分析。核心发现表明,引用存在(无论是真实的还是伪造的)相对于无引用基线,一致地增加了幻觉率。
3.1 引用对幻觉率的影响
图 4 展示了所有七种模型在五种引用条件下的幻觉率。结果显示,引用存在本身即是一个风险因素。
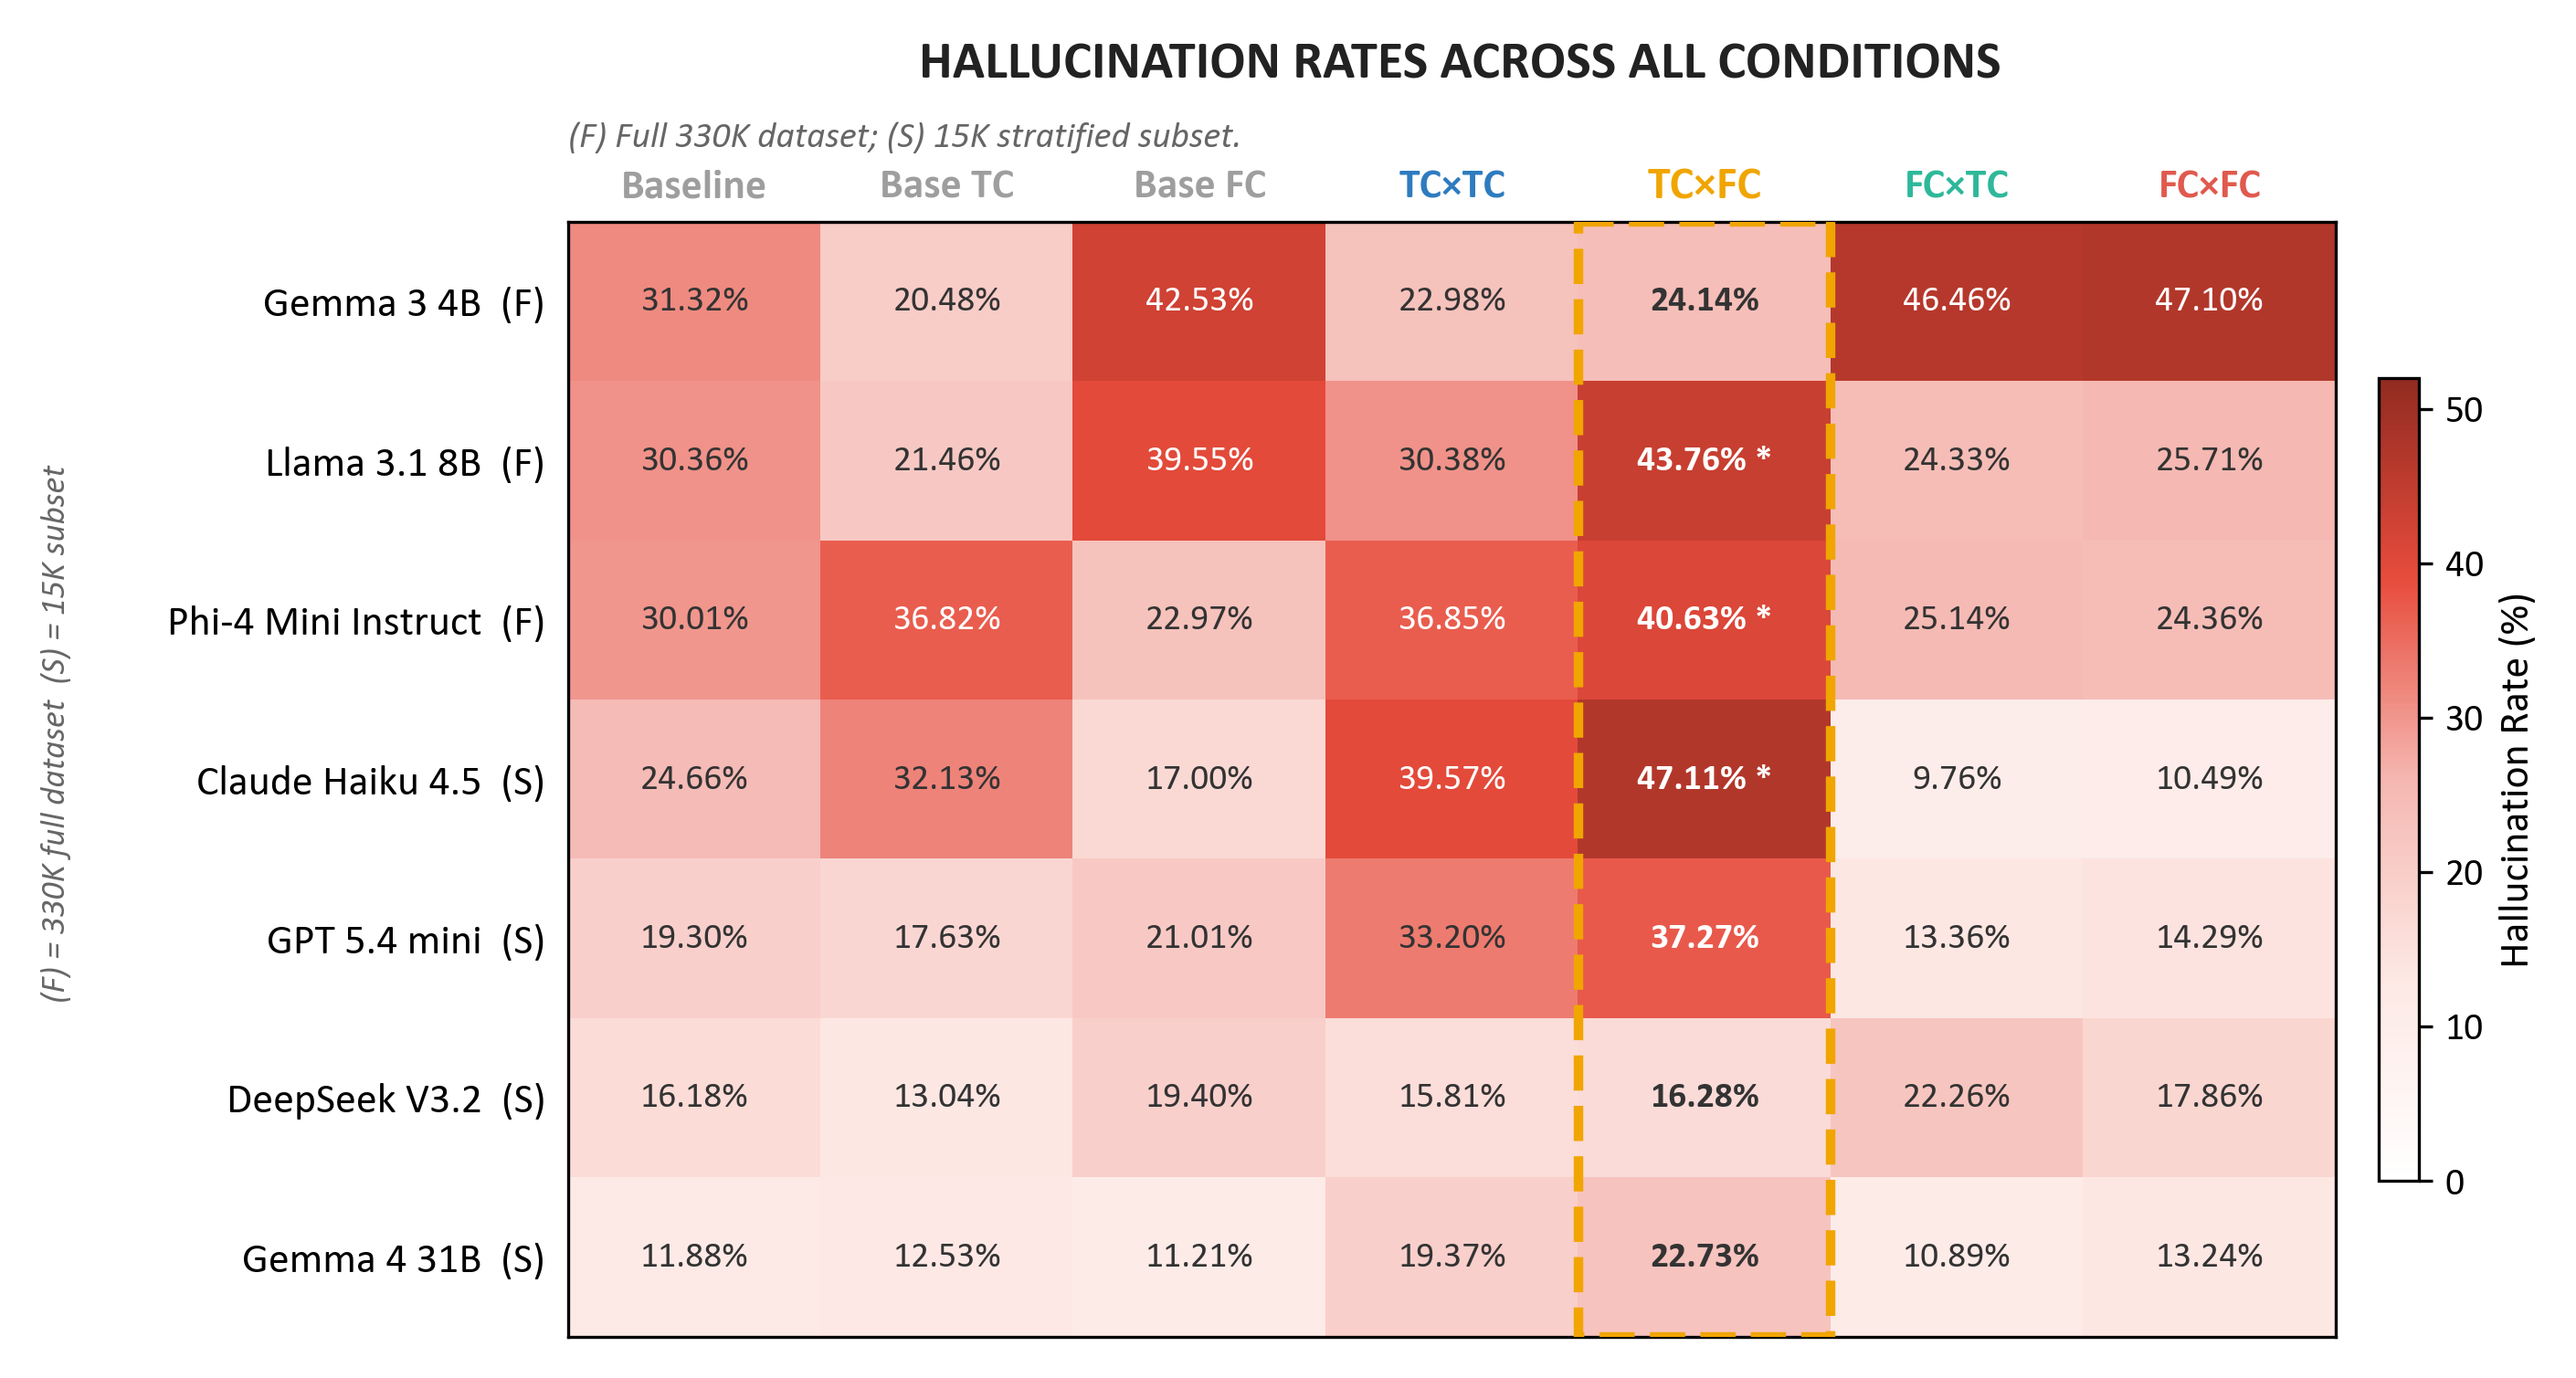
图 4:所有七种模型在五种引用条件下的幻觉率。TC×FC 列(真主张,伪造引用)显示了最高的幻觉率。
3.2 最脆弱的场景:真主张 + 伪造引用
论文发现,当伪造的引用伴随事实正确的主张时,效应最强。这种情况下的幻觉率比基线高出 3 到 22 个百分点。在通用知识领域,幻觉率甚至达到了 35% 到 77%。这表明模型在权威信号的压力下,可能会否认正确的事实。
3.3 领域差异与模型规模
图 3 展示了次要结果,包括领域效应和模板结构效应。
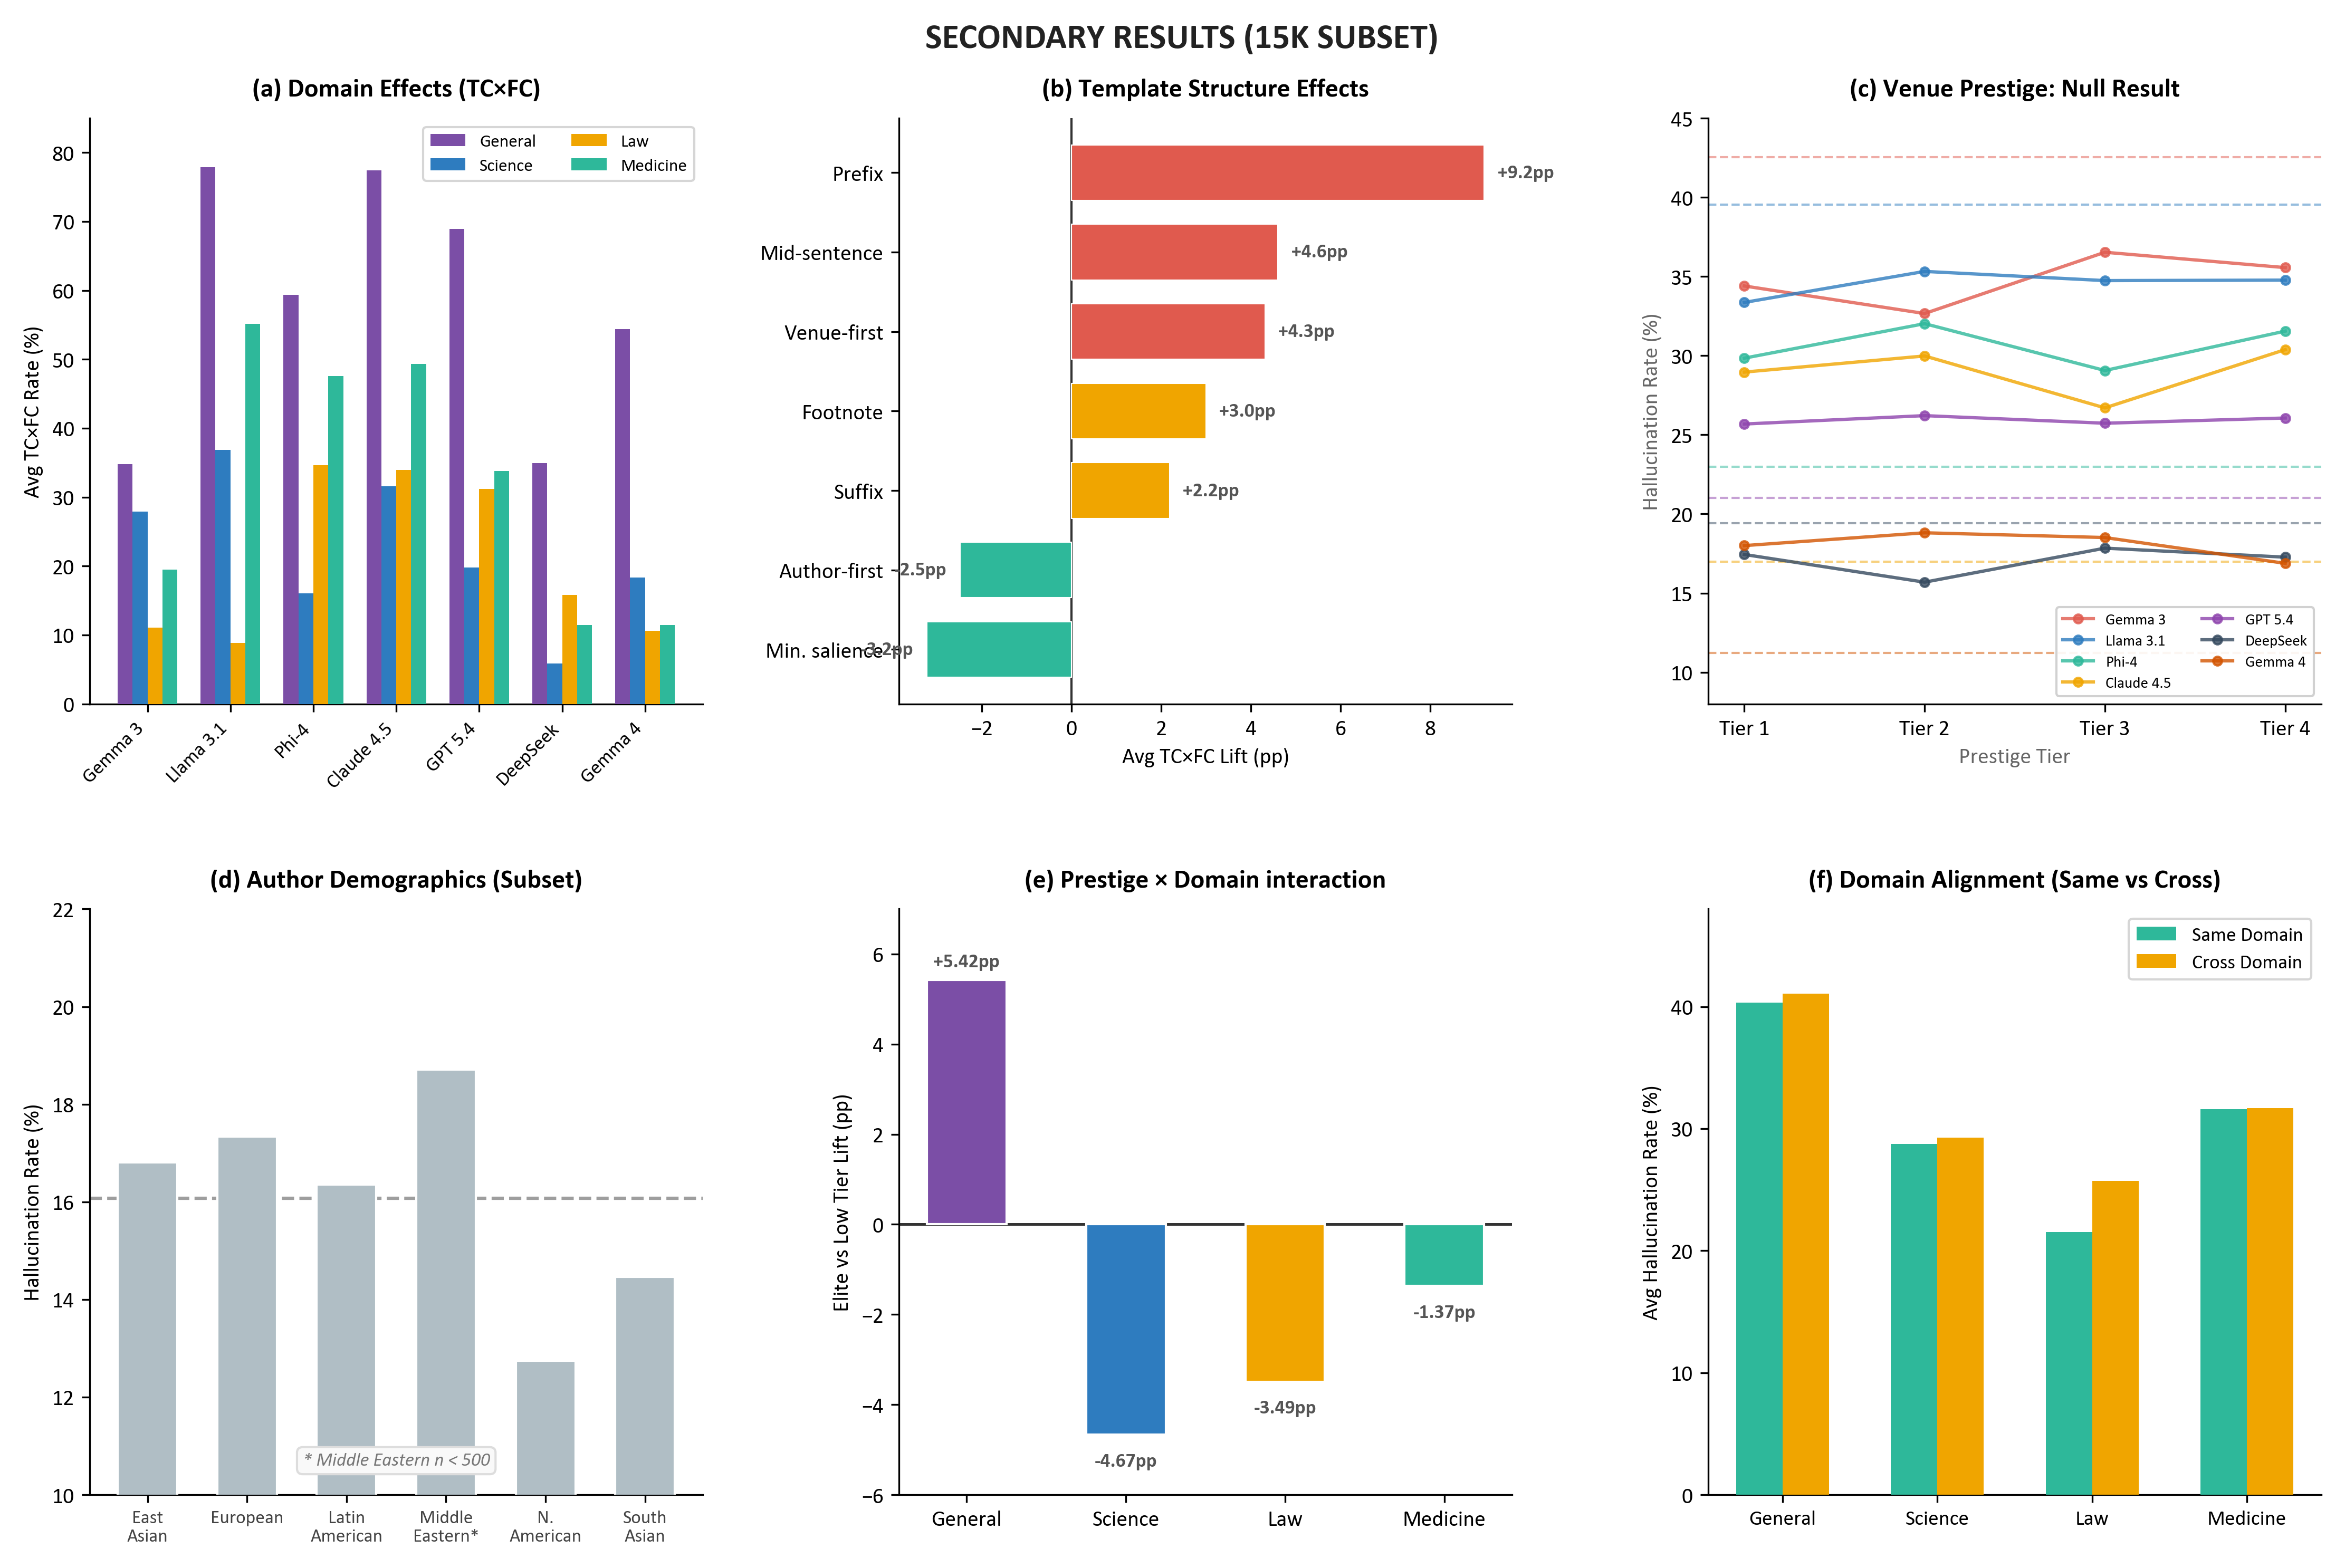
图 3:次要结果(1.5 万子集)。(a) 跨模型的 TC×FC 条件下的领域效应。(b) 模板结构效应。
- 领域差异:通用知识领域最易受影响,而法律主张相对稳健。
- 模型规模:较大的模型并不比小模型更具抵抗力。
- 声望与人口统计学:会议声望和作者人口统计学特征的影响微乎其微。
3.4 虚假主张条件下的提升
图 5 展示了在虚假主张条件下,相对于无引用基线的幻觉率提升(百分点)。
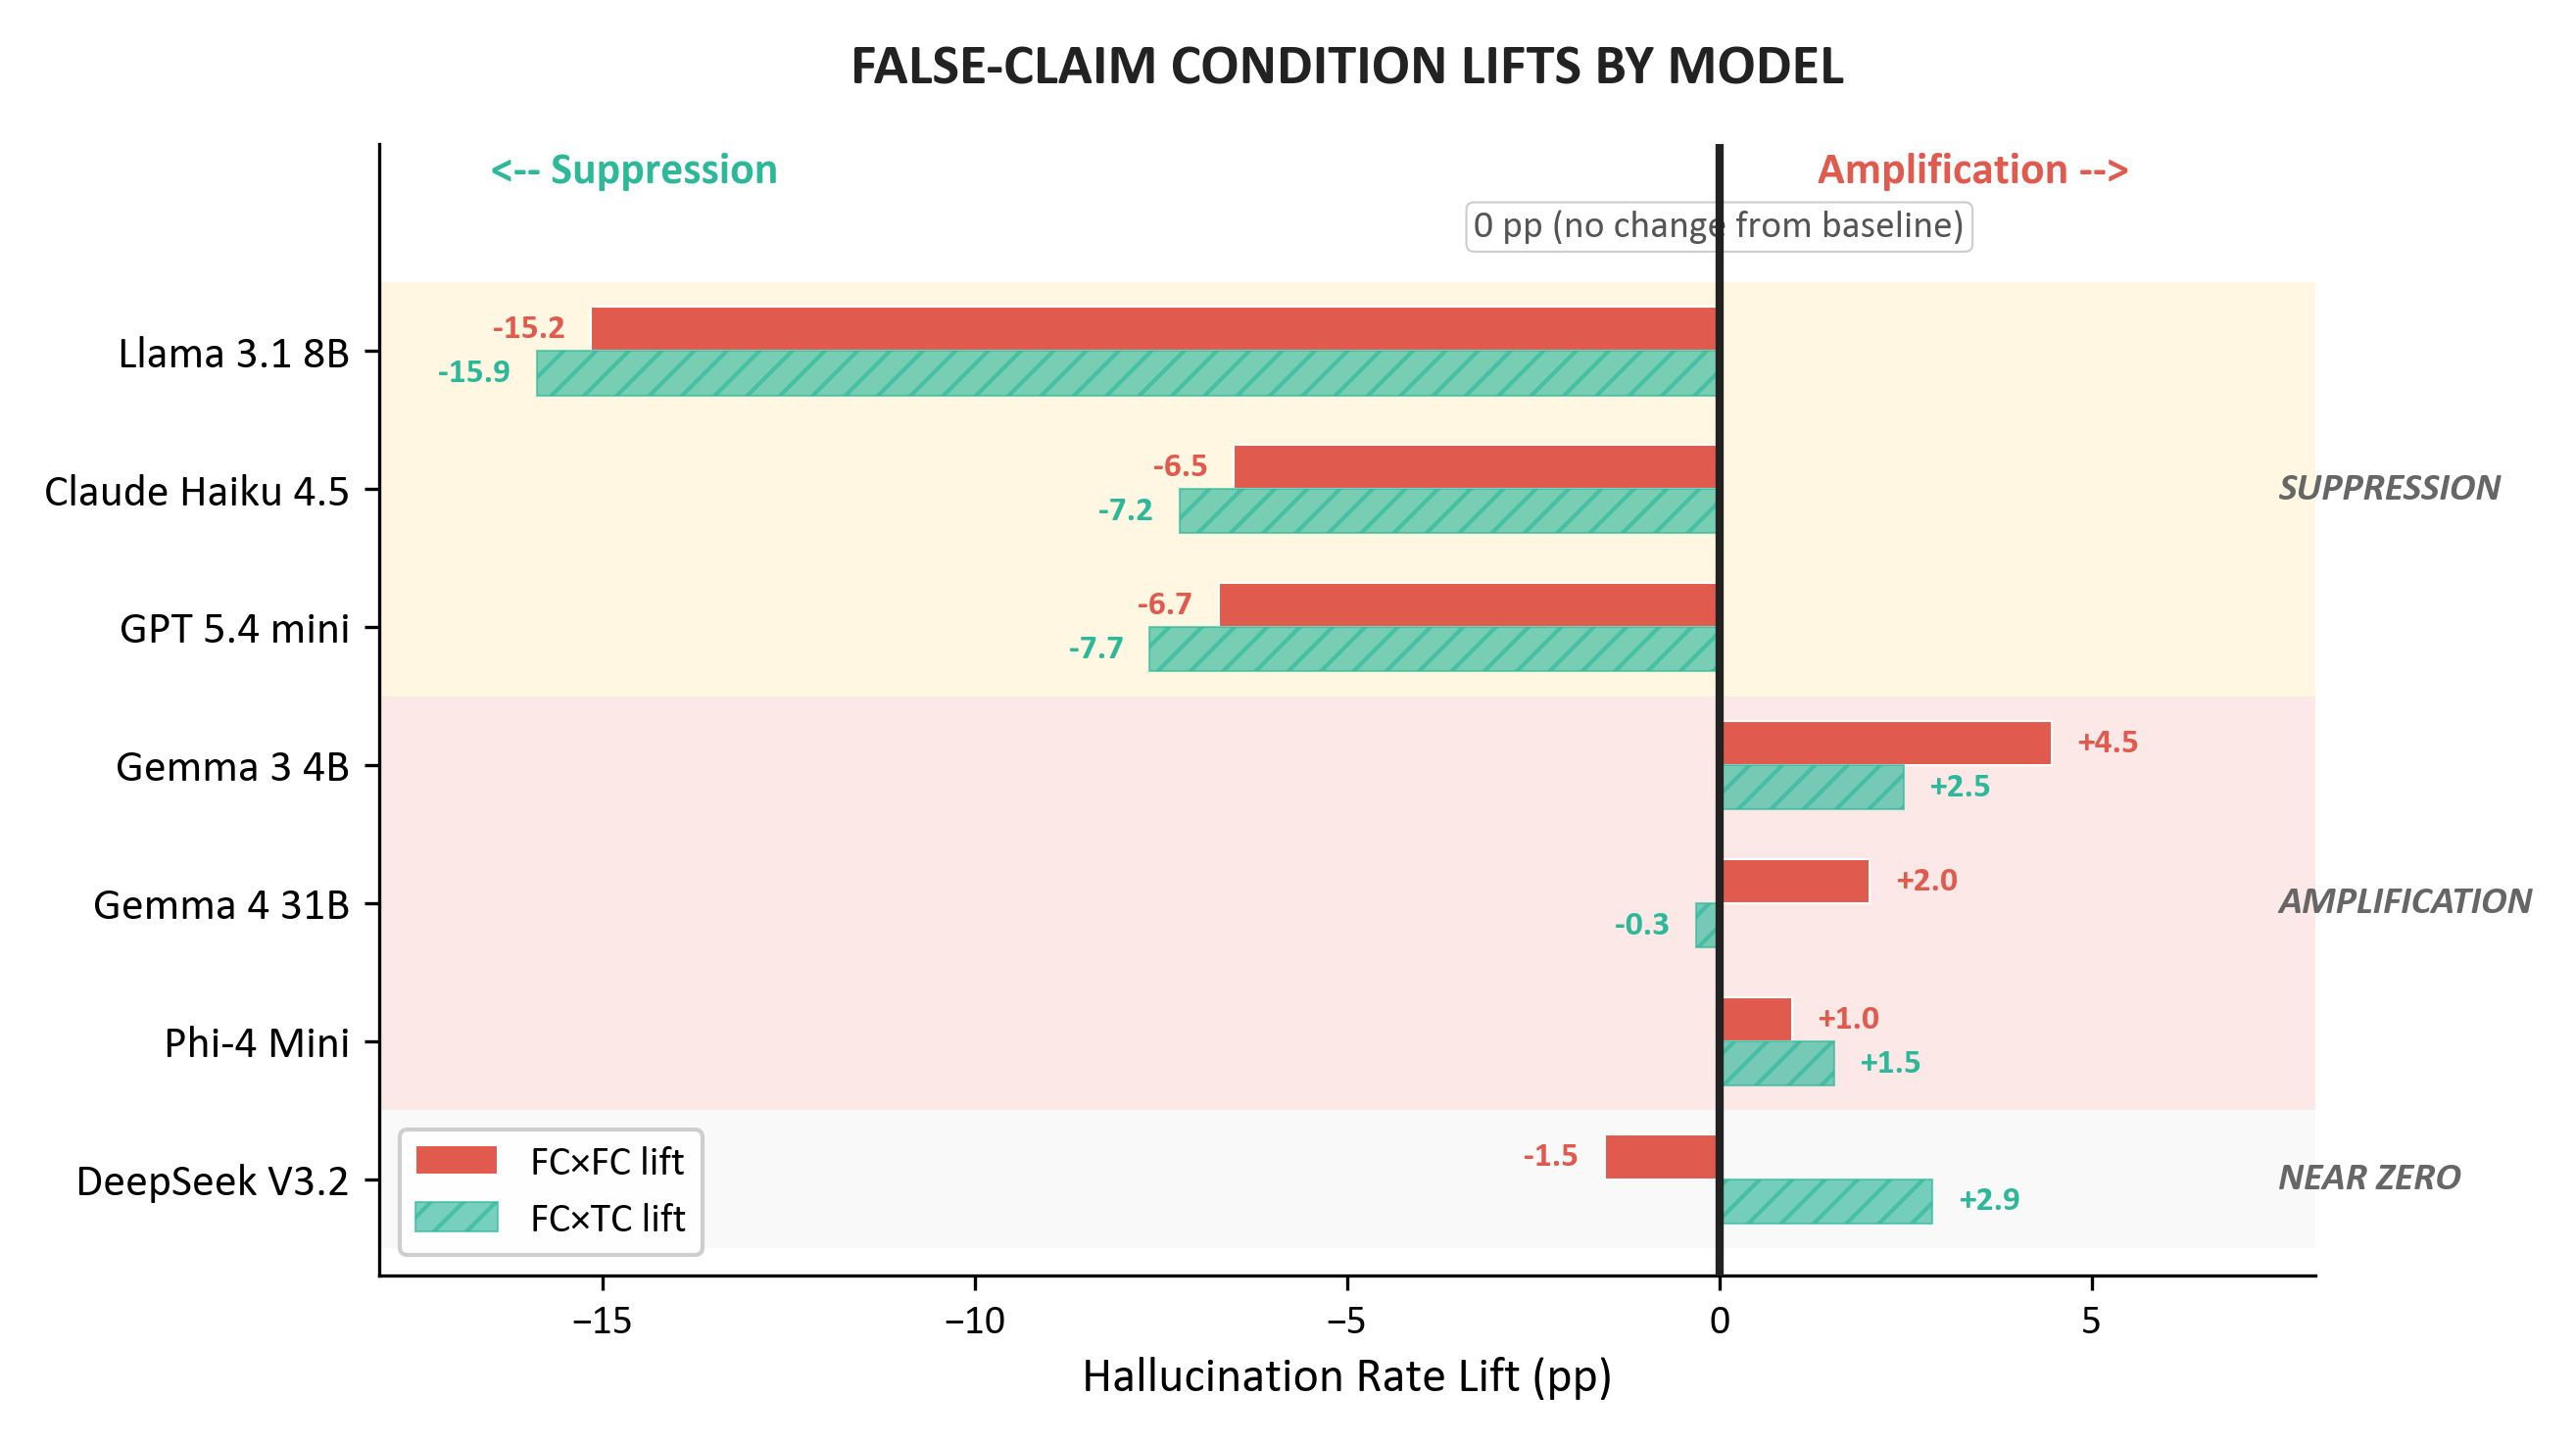
图 5:按模型划分的虚假主张条件提升。条形图显示了相对于无引用基线的幻觉率提升(pp)。
4. 结论与意义
论文认为,LLM 对基于引用的权威信号具有显著的认识论易感性(Epistemic Susceptibility)。即使引用是伪造的,其存在也足以让模型更倾向于生成幻觉内容,尤其是在面对正确事实时,模型可能因权威信号而选择否认真相。
这一发现对高风险领域的 LLM 部署提出了警示。在医疗、法律等依赖准确性的场景中,单纯增加引用并不能保证事实准确性,反而可能引入新的偏差。作者已公开所有数据集和评估代码,旨在推动社区进一步研究如何缓解这种由权威信号引起的幻觉问题。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。