How Does Reasoning Flow? Tracing Attention-Induced Information Flow for Targeted RL in LLMs
作者:Zhichen Dong, Yang Li, Yuhan Sun, Weixun Wang, Yijia Luo
作者提出 FlowTracer 框架,通过构建注意力诱导的有向无环图来追踪面向答案的推理流。该方法利用聚合注意力权重作为边容量,并通过流量守恒约束提取信息流骨干,从而基于流量吞吐量对 Token 进行信用分配。
论文信息摘要
论文要解决什么
解决大语言模型强化学习中 Token 级别信用分配困难的问题,现有方法通常平等对待所有 Token 或仅使用点式启发式信号,忽略了信息传播的全局结构。
论文方法概览
- Backbone: LLM (e.g., Qwen3-4B)
- 关键模块: FlowTracer (Attention-induced DAG, Flow Conservation)
- 损失函数: Token-level reward shaping via flow throughput
读后要点
个人理解,欢迎指正
实验表明,基于全局信息流结构的 Token 重要性评分能有效区分关键推理步骤与填充词,从而提升 RL 训练效率。该方法将图论流量分析引入 LLM 内部机制分析具有创新性,但计算开销需关注。
局限与疑问
构建注意力图并进行流量计算可能增加推理或训练阶段的计算开销;方法对注意力权重的聚合方式敏感;文中未详细披露具体数据集名称及代码开源情况。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.10646v1。
论文阅读笔记:How Does Reasoning Flow? Tracing Attention-Induced Information Flow for Targeted RL in LLMs
1. 研究背景与问题定义
在大语言模型(LLM)的强化学习(RL)训练中,Token 级别的信用分配(Token-level credit assignment) 一直是一个关键障碍。论文指出,现有的 RL 方案通常平等对待所有 Token,无法区分决定性的推理步骤与常规的格式填充或流畅的填充词(fluent filler)。
虽然近期有尝试利用模型内部信号(如熵、注意力统计)来进行细粒度的信用分配,但这些方法往往基于点式启发式(point-wise heuristics),忽略了信息传播的全局结构。作者认为,解决 Token 级别信用分配问题的关键在于回答一个更根本的问题:推理流是如何在 LLM 内部从提示词流向最终答案的?
2. 核心方法:FlowTracer 框架
为了解决上述问题,作者提出了 FlowTracer,这是一个基于图的信用分配方法,旨在从模型的注意力结构中提取面向答案的推理骨干(reasoning backbone),并以此指导 RL 更新。
2.1 注意力诱导的有向无环图(DAG)
论文将 Token 序列视为一个由注意力机制诱导的有向无环图(DAG):
- 节点(Nodes):对应序列中的每个 Token。
- 边(Edges):有向边携带非负容量,源自聚合的注意力权重,解释为潜在信息传递的强度。
2.2 面向答案的图条件化与重加权
直接使用原始注意力权重是不够的,因为注意力图中包含许多对最终答案无贡献的分支。为了消除结构偏差,FlowTracer 引入了显式的**答案条件化(answer-conditioning)**步骤:
- 定义答案区域:例如最终的 Answer Span。
- 计算全局可达性势(Global Reachability Potential):衡量每个 Token 的下游影响力最终能到达答案的程度。
- 重加权边容量:仅保留能到达答案区域的影响力部分,并过滤掉可达性为零的 Token。
2.3 流量守恒与骨干提取
为了处理路径长度或无关分支导致的影响力稀释问题,FlowTracer 在目标条件化图上执行流量分析:
- 流量守恒(Flow Conservation):强制局部流量守恒,确保中间 Token 不会因路径长度或分支而损失或获得有效质量。
- 超级源与超级汇:从连接到 Prompt Token 的超级源注入单位流量,并在连接到 Answer Token 的超级汇收集流量。
- 信息流骨干:通过上述过程恢复出支持最终预测的主导多跳路径(dominant multi-hop routes)。
2.4 Token 信用评分与奖励塑造
基于提取的信息流骨干,FlowTracer 通过**流量吞吐量(flow throughput)**对 Token 进行评分:
- 高吞吐量 Token:被视为中转枢纽(transit hubs)或聚合检查点(aggregation checkpoints),介导长距离依赖。
- 奖励塑造(Reward Shaping):将推导出的重要性用于塑造 Token 级别的奖励,放大高影响力路由 Token 的学习信号,抑制低影响力填充词的更新。
3. 方法概览与可视化分析
论文通过 Figure 1 展示了 FlowTracer 的整体流程。该图描绘了从构建注意力诱导的 Token 图,到针对答案进行条件化保留支持预测的路径,再到归一化以确保局部一致流的过程。通过从 Prompt 的超级源向 Answer 的超级汇注入流量,系统提取出主导的多跳信息路径骨干,进而通过 Token 吞吐量识别关键路由枢纽,用于 Token 级别的信用分配和奖励塑造。
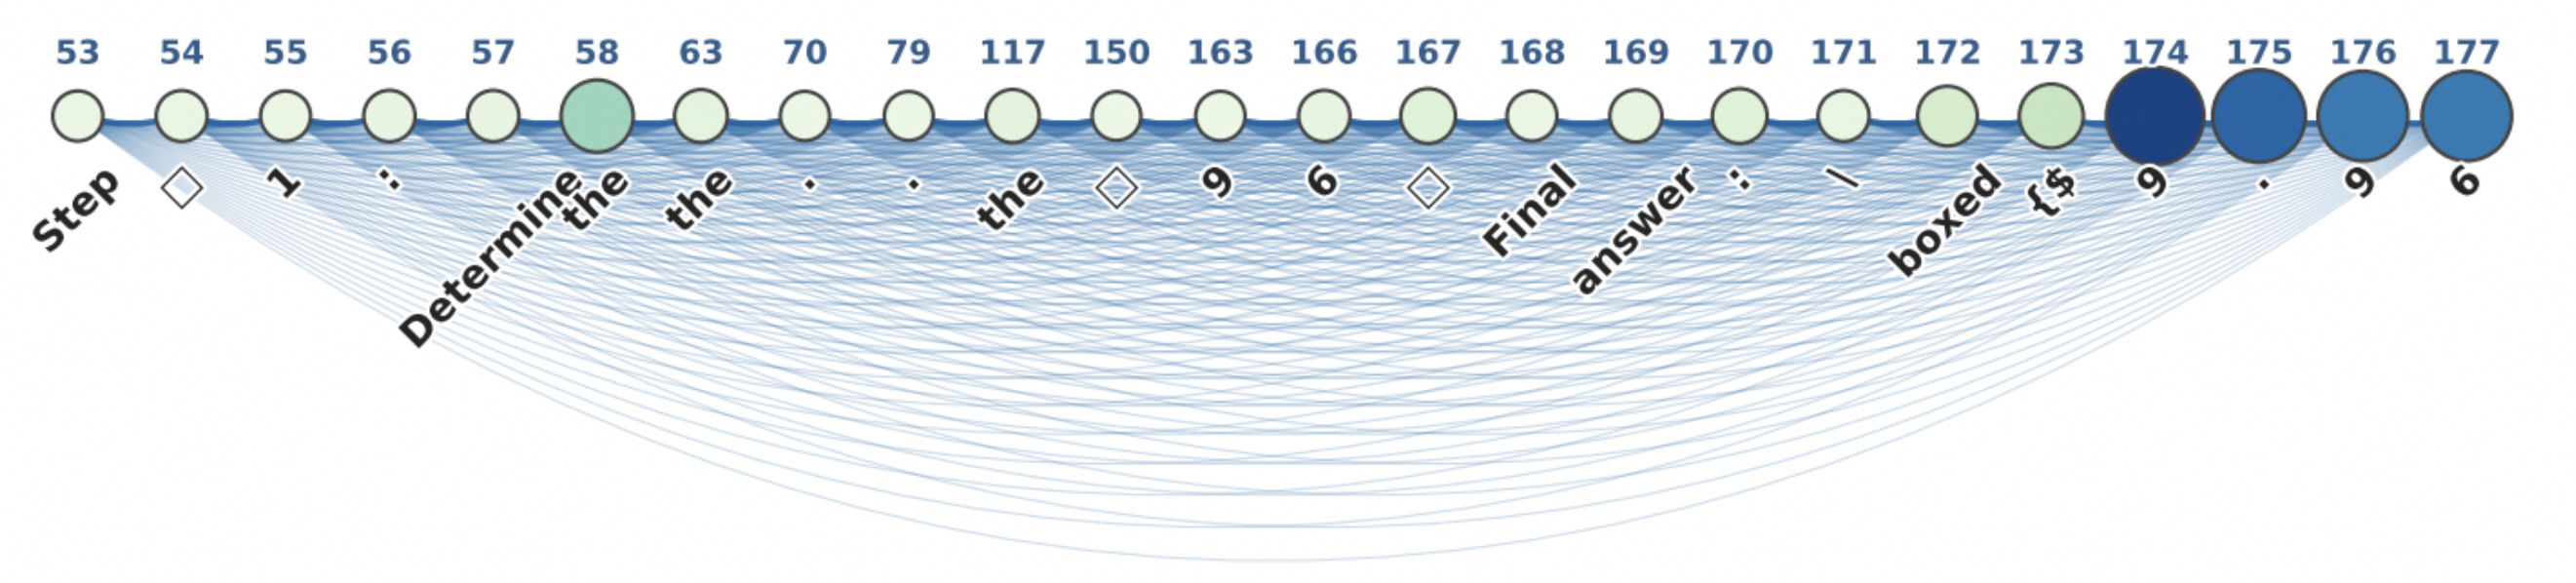
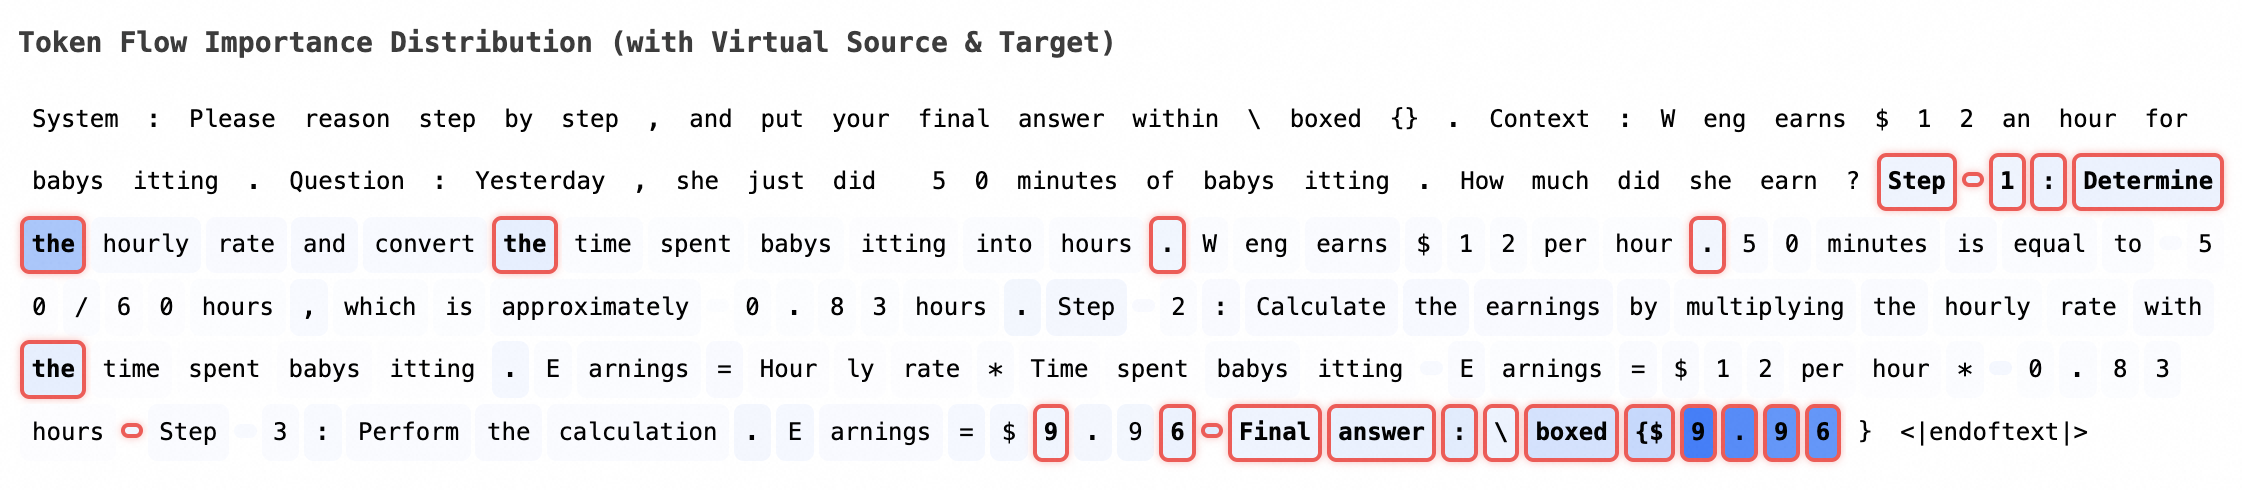
为了验证该方法的有效性,作者在 Qwen3-4B 模型上进行了可视化分析。Figure 2 展示了面向答案的 Token 流重要性。通过将生成过程建模为 DAG,论文追踪了从 Prompt 到最终答案的影响力流。图中深色节点表示更高的流量吞吐量,识别出了超越常规填充词的决断性 Token 推理骨干。这为针对特定目标的 RL 提供了更细粒度的 Token 级别信用分配依据。
此外,Figure 3 通过词云展示了高流量和低流量 Token 的分布情况。这种可视化进一步揭示了 FlowTracer 如何区分关键推理步骤与无关内容,高流量 Token 往往对应于推理过程中的核心概念或变量,而低流量 Token 则多为填充词或格式符号。
4. 实验结果与意义
论文在多个推理任务上进行了实验,结果表明 FlowTracer 能够带来一致的性能提升。通过利用全局结构而非点式启发式,该方法能够更准确地识别对答案生成至关重要的 Token。
4.1 与现有工作的对比
- 传统 RL 方法:通常依赖稀疏的延迟监督,难以准确估计 Token 级别的价值,导致归因噪声大且不稳定。
- 内部信号启发式:如熵或注意力统计,虽然利用了模型内部动态,但往往忽略了信息传播的全局结构。
- FlowTracer:通过图论方法提取全局一致的路径,识别真正的传输枢纽,并结合 Doob-h 变换隔离面向答案的多跳推理骨干。
4.2 对 RLVR 的增强
FlowTracer 将全局一致的信用概念通过 Token 级别的奖励塑造和损失重加权(loss reweighting)集成到 RLVR(Reinforcement Learning with Verifiable Rewards)中。这种方法不仅提高了学习效率,还增强了推理性能,使得学习信号能够精确聚焦于将信息路由至(或远离)正确答案的 Token 上。
5. 总结
FlowTracer 提出了一种新颖的视角,将 LLM 的推理过程视为信息流在注意力图上的传播。通过构建注意力诱导的 DAG 并施加答案条件化与流量守恒约束,该方法成功提取了连接问题与答案的信息流骨干。这种基于全局结构的 Token 信用分配机制,有效解决了传统 RL 方法中 Token 重要性区分度不足的问题,为提升 LLM 在复杂推理任务中的表现提供了新的技术路径。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。