Small Data, Big Noise: Adversarial Training for Robust Parameter-Efficient Fine-Tuning
作者:Eitan Cohen, Idan Simai, Uri Shaham
作者提出 SDBN 框架,将对抗训练引入参数高效微调(PEFT),利用离散不确定性集增强模型在低资源和噪声环境下的鲁棒性与泛化能力。
论文信息摘要
论文要解决什么
现有 PEFT 方法在训练数据有限及存在文本噪声(如拼写错误、格式不一致)时,性能显著下降且泛化能力不足,难以适应现实部署场景。
论文方法概览
- Backbone: PEFT (LoRA/Adapter/BitFit)
- 关键模块: Adversarial Training with Discrete Uncertainty Sets (SDBN-h/SDBN-p)
- 损失函数: Worst-case Adversarial Loss
读后要点
个人理解,欢迎指正
实验表明对抗训练能显著提升 PEFT 在少样本场景下的抗噪能力,且无需增加额外参数,仅带来适度计算开销。
局限与疑问
SDBN-p 依赖 LLM 生成变体可能增加计算成本;离散不确定性集的覆盖范围及在不同任务上的普适性有待进一步验证。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.10610v1。
论文阅读笔记:Small Data, Big Noise: Adversarial Training for Robust Parameter-Efficient Fine-Tuning
论文 ID: 2606.10610v1
标题: Small Data, Big Noise: Adversarial Training for Robust Parameter-Efficient Fine-Tuning
作者: Eitan Cohen, Idan Simai, Uri Shaham
机构: Bar-Ilan University
1. 研究背景与问题定义
参数高效微调(Parameter-Efficient Fine-Tuning, PEFT)已成为将基础模型适配到下游自然语言处理(NLP)任务的关键策略。常见的 PEFT 方法包括 Adapter、BitFit 和 LoRA 等,它们通过仅更新少量参数来显著降低计算和存储需求。然而,论文指出当前的 PEFT 方法在面对噪声数据和有限训练数据时存在明显的鲁棒性不足问题。
在现实世界的 NLP 部署中,文本数据往往包含拼写错误、格式不一致或方言变化等不完美之处。此外,在医疗、航空航天或濒危语言等领域,训练样本往往非常有限。作者观察到,尽管 PEFT 方法在大规模语料上表现优异,但在低资源设置下,其性能会显著下降,且对文本扰动(如单词交换)非常敏感。
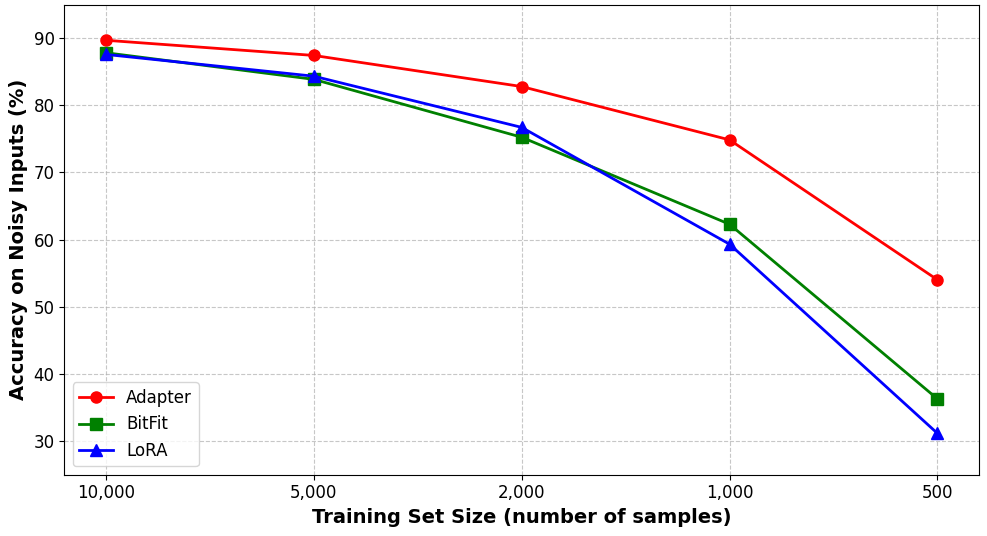
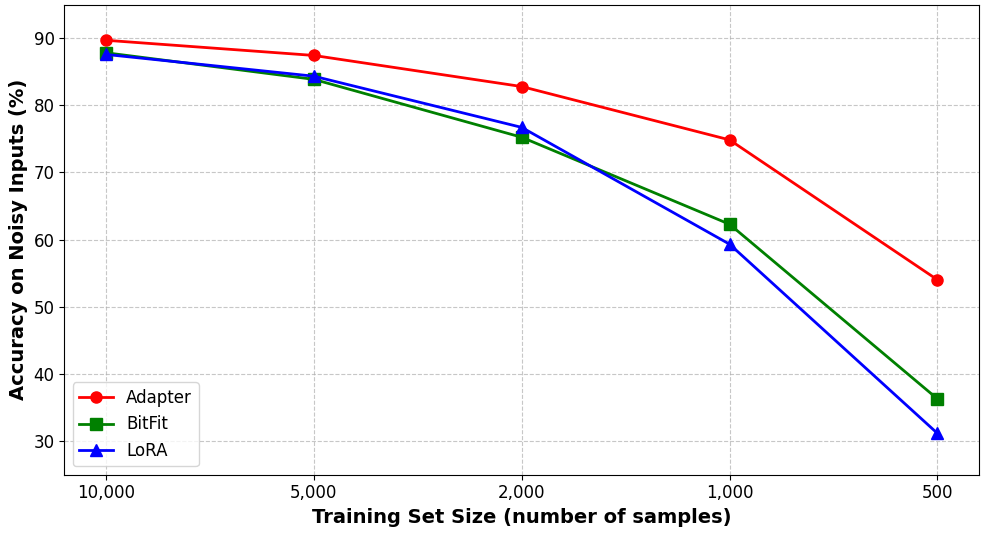
为了直观展示这一问题,论文在引言部分提供了实验数据。如图 1 所示,随着干净训练数据(Banking77 数据集)规模的减少,三种常见 PEFT 方法(Adapter, BitFit, LoRA)在含有单词交换噪声的测试集上的准确率均出现显著下降。在某些情况下,当训练样本少于 1,000 个时,准确率损失超过 50%。这一趋势强调了当前 PEFT 模型在低资源设置下对现实文本扰动的脆弱性。
2. SDBN 框架设计
针对上述挑战,作者提出了 SDBN (Small Data Big Noise) 框架。这是一个统一的框架,旨在将对抗训练(Adversarial Training)原则引入 PEFT 中,以增强模型的鲁棒性和泛化能力。
论文认为,尽管对抗训练在防御攻击方面已被广泛采用,但将其应用于低资源、噪声环境下的 PEFT 方法尚未得到充分探索。SDBN 框架的核心思想是在微调过程中引入对抗扰动,使模型能够适应最坏情况下的损失,从而在数据稀缺和噪声干扰并存的环境中表现更稳定。
该框架不仅关注连续嵌入空间中的扰动,还特别针对 NLP 领域特有的离散扰动进行了设计。作者指出,传统的基于范数球的不确定性集无法覆盖某些特定的 NLP 扰动场景,例如破坏分词的字符级编辑或语义丰富的生成式变体。因此,SDBN 引入了离散不确定性集的实例化方案来补充传统方法。
3. 离散不确定性集策略
为了处理不同类型的噪声,论文介绍了 SDBN 的两个变体,分别利用离散不确定性集来构建对抗样本:
- SDBN-h (Character-level edits): 该变体枚举字符级的编辑操作,并利用梯度选择最坏情况的变体。这种方法旨在解决那些会破坏分词(tokenization-breaking)的字符级噪声问题。
- SDBN-p (LLM-generated variants): 该变体利用大语言模型(LLM)生成对抗变体,用于生成式任务中的鲁棒优化。这种方法能够产生语义上更丰富的扰动。
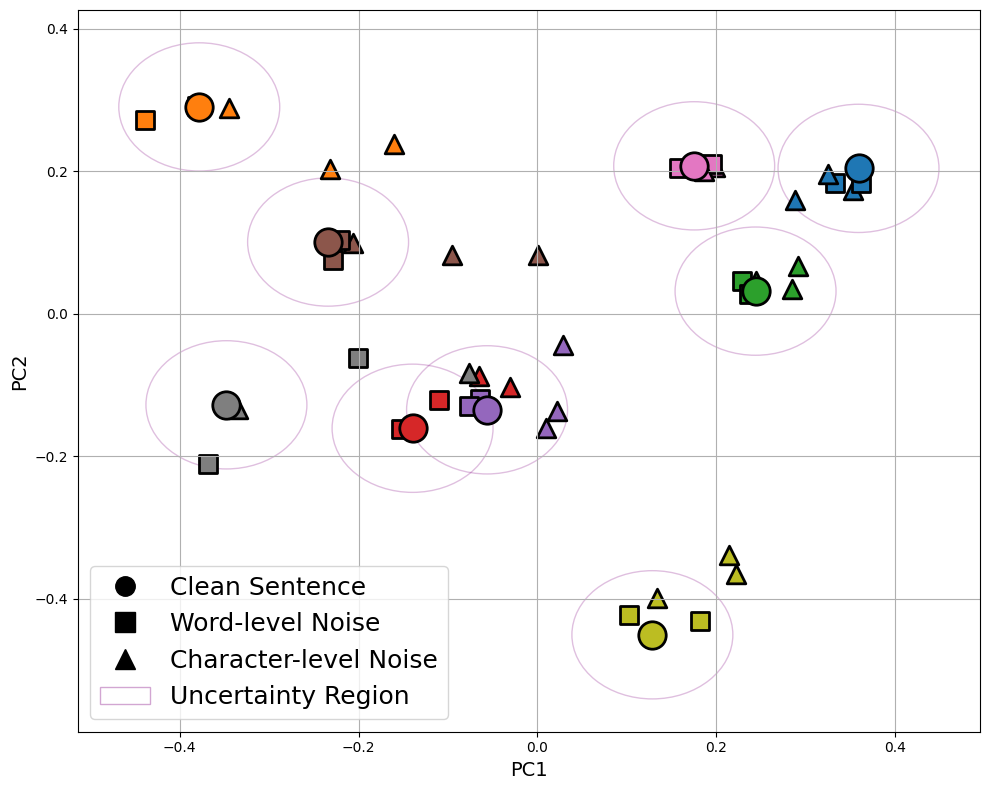
论文通过图 2 展示了不同扰动机制下对抗训练所覆盖的区域。该图通过 PCA 可视化展示了嵌入空间中的扰动情况,说明了 SDBN 框架如何通过不同的扰动策略(如连续扰动与离散扰动)来覆盖更广泛的鲁棒性需求,特别是针对那些传统方法难以处理的字符级和语义级变化。
4. 实验评估与结果分析
作者在多个基准测试上进行了实验,验证了 SDBN 框架在低资源设置和不同噪声类型下的有效性。
4.1 低资源设置下的对抗训练效果
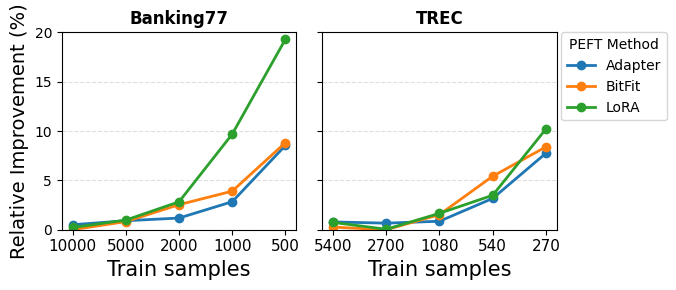
实验表明,SDBN 在训练数据有限的情况下能显著提升模型性能。图 3 展示了在有限数据条件下,对抗训练对模型效果的影响。结果显示,引入对抗训练后,模型在数据稀缺场景下的表现优于传统的 PEFT 基线,验证了该方法在缓解数据不足带来的性能下降方面的作用。
4.2 不同强度噪声下的鲁棒性
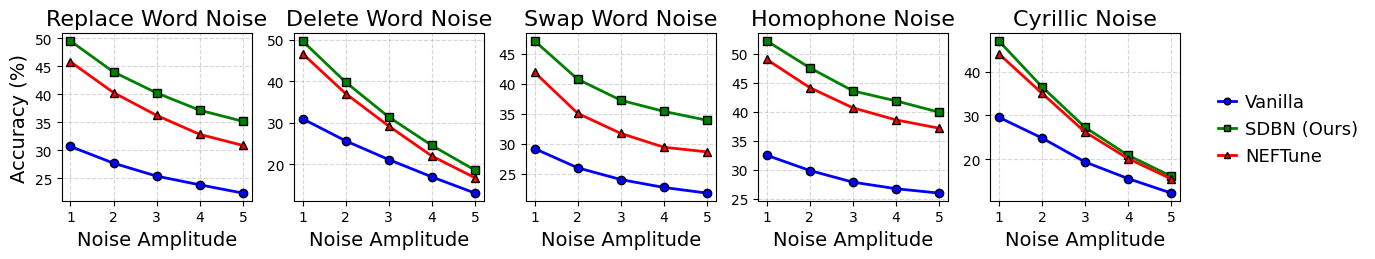
为了评估模型对不同强度噪声的适应能力,论文对比了不同噪声强度下的性能。图 4 展示了 LoRA PEFT 实现中,对抗训练在可变强度噪声下的性能对比。实验结果表明,SDBN 框架能够适应不同强度的噪声干扰,且在噪声强度增加时,其性能下降幅度小于未采用对抗训练的基线方法。
4.3 嵌入空间差异分析
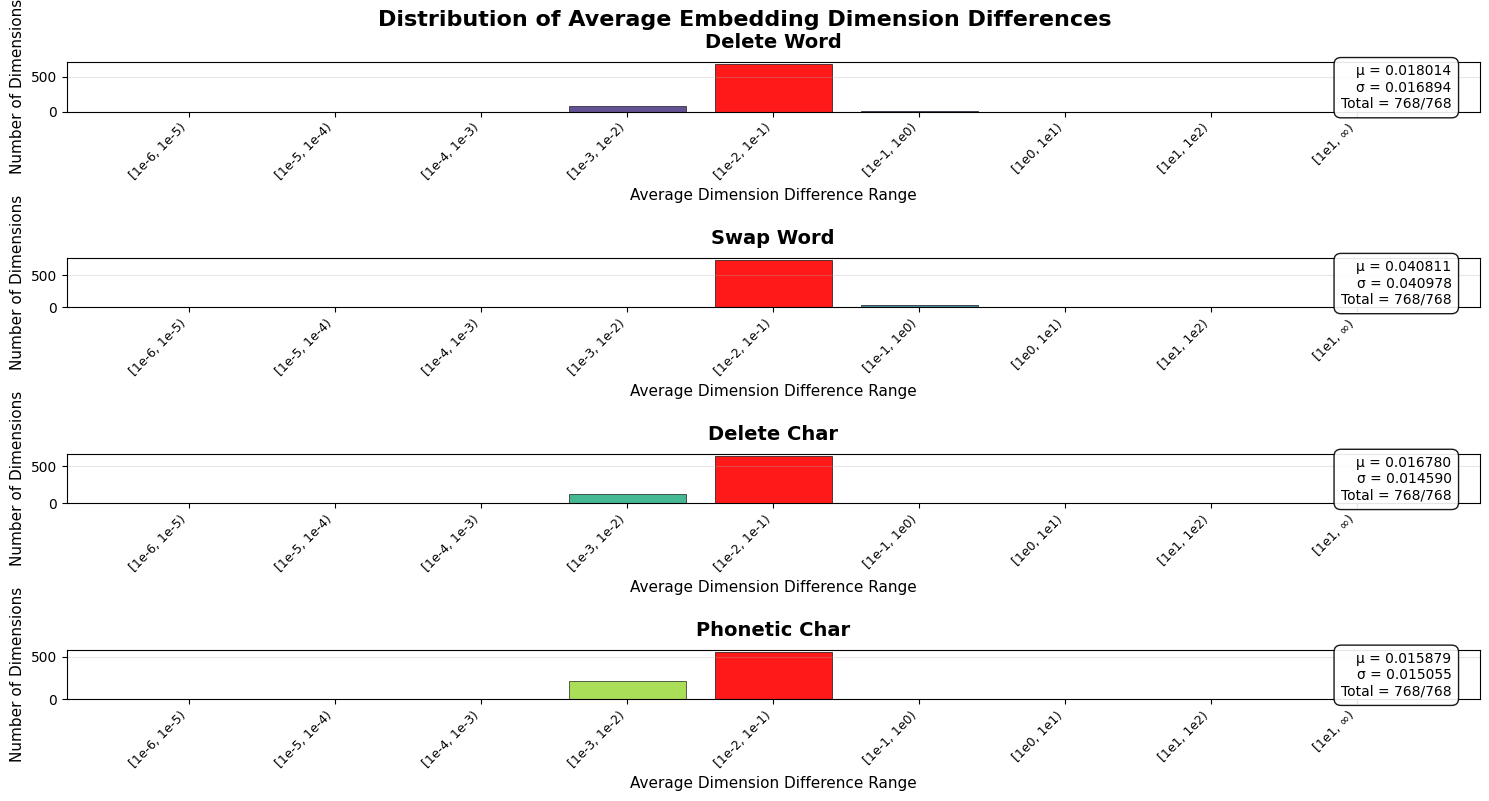
为了深入理解噪声对模型内部表示的影响,作者分析了噪声句子与干净句子之间的嵌入差异。图 5 展示了多种噪声类型下,噪声与干净句子之间嵌入差异的直方图。该分析揭示了不同类型的噪声(如单词级与字符级)在嵌入空间中造成的分布差异,说明了为什么某些噪声(如字符级编辑)对模型影响更大,因为它们可能导致分词失效,从而在嵌入空间中产生更大的偏移。
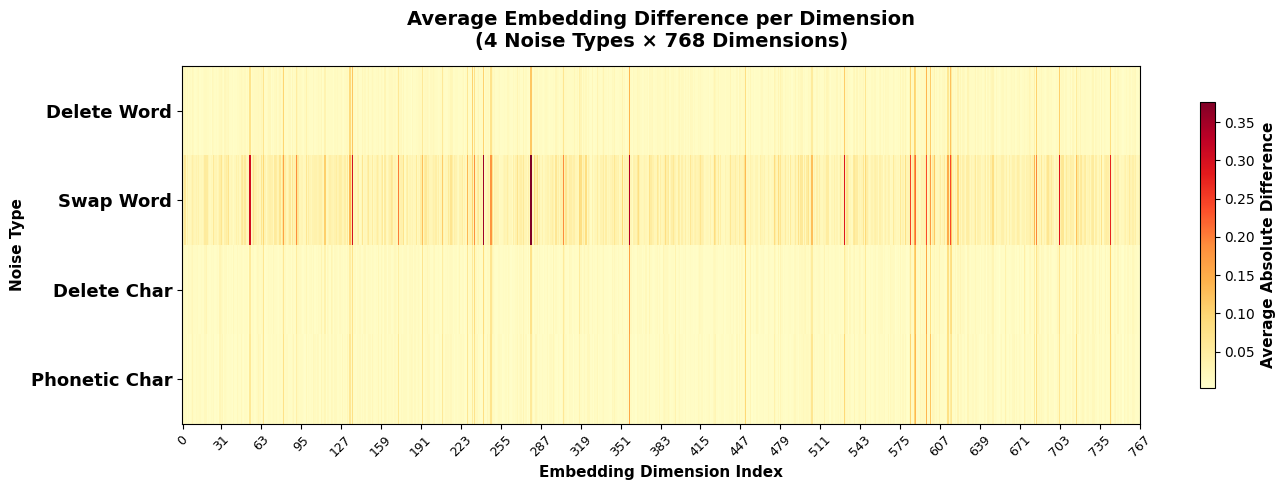
进一步地,图 6 提供了多种噪声类型下坐标级嵌入差异的热力图。每一行代表一种噪声类型,展示了噪声如何在不同的嵌入维度上影响模型表示。这一可视化分析支持了作者关于字符级扰动会破坏分词并导致嵌入空间大幅偏移的观点,也解释了 SDBN-h 变体针对此类扰动进行优化的必要性。
5. 总结与贡献
综上所述,SDBN 框架成功地将对抗训练与参数高效微调相结合,解决了 PEFT 在低资源和噪声环境下的鲁棒性问题。论文的主要贡献包括:
- 提出 SDBN 框架: 首次系统性地将对抗训练引入 PEFT 设置,专门针对低资源场景下的鲁棒性提升。
- 引入离散不确定性集变体: 提出了 SDBN-h(基于字符级扰动)和 SDBN-p(基于 LLM 生成扰动)两种变体,分别解决了分词破坏和语义生成任务中的鲁棒性挑战。
- 实验验证: 在多个基准测试中证明了该方法在单词级和字符级腐蚀下的显著鲁棒性增益,且无需引入额外的可训练参数,仅带来适度的计算开销。
作者认为,SDBN 为在资源受限和噪声并存的现实世界场景中部署可靠的语言模型提供了一种实用的解决方案,填补了 PEFT 与对抗训练交叉领域的研究空白。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。