PADD: Path-Aligned Decompression Distillation for Non-Router Teacher to Guide MoE Student Learning
作者:Xinyue Peng, Yi Qian, Jiaojiao Lin, Wenjian Shao, Yanming Liu
作者提出路径对齐解压蒸馏(PADD)框架,旨在将无显式路由的稠密教师模型知识蒸馏至混合专家(MoE)学生模型。该方法通过教师神经元聚类初始化专家功能,并结合在线自适应蒸馏与路径细化策略优化,在固定计算预算下实现高效的知识迁移与路由学习。
论文信息摘要
论文要解决什么
在固定计算预算下扩展大模型容量面临挑战,稠密模型存在推理瓶颈,而从头训练 MoE 成本高昂。从稠密教师蒸馏至 MoE 学生面临路由器冷启动、路径断裂及容量差距等难题,导致路由策略难以学习且专家功能趋同。
论文方法概览
- Backbone: Dense Teacher to MoE Student
- 关键模块: Teacher Neuron Clustering, Online Adaptive Distillation, PR-GRPO, Reward-Augmented Load Balancing
- 损失函数: Distillation Loss + Policy Optimization Loss + Load Balancing Loss
读后要点
个人理解,欢迎指正
实验表明 PADD 能在相同推理成本下使 MoE 学生匹配或超越稠密教师性能。教师神经元聚类有效解决了专家同质化问题,PR-GRPO 显著提升了路由训练的稳定性。
局限与疑问
实验主要集中在数学推理基准测试,在其他任务领域的泛化性待验证。神经元聚类过程可能增加初始化阶段的计算开销。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.10369v1。
PADD: 路径对齐解压蒸馏引导 MoE 学生学习的深度解读
论文基本信息
- 论文标题:PADD: Path-Aligned Decompression Distillation for Non-Router Teacher to Guide MoE Student Learning
- 论文 ID:2606.10369v1
- 作者:Xinyue Peng, Yi Qian, Jiaojiao Lin, Wenjian Shao, Yanming Liu
- 机构:Intel Corporation, Zhejiang University
- 会议/期刊:ICML 2026 (Proceedings of the 43rd International Conference on Machine Learning)
研究背景与动机
随着大型语言模型(LLMs)规模的不断扩大,在固定计算预算下扩展模型容量变得日益困难。稠密模型(Dense Models)在扩展到数百亿或万亿参数时,面临训练吞吐量、推理延迟和内存带宽的瓶颈。混合专家模型(Mixture-of-Experts, MoE)架构通过将参数解耦为稀疏激活的专家子网络,实现了容量与推理 FLOPs 的解耦,理论上可以“解压”纠缠的稠密表示为结构化的专家模块。
然而,作者指出当前存在以下挑战:
- 训练成本高:大多数高性能模型仍是稠密的,从头训练 MoE 成本昂贵。
- 结构不匹配:现有的 MoE 到 MoE 蒸馏缺乏通用性,因为专家分解和路由策略不兼容。
- 稠密到 MoE 的困难:稠密教师模型缺乏显式的路由器(Router)。若直接进行稀疏升级(Sparse Upcycling),新路由器缺乏来自稠密教师激活的监督,必须从头学习,导致“路由器冷启动”(Router Cold Start)问题。
- 路径断裂与梯度不稳定:传统蒸馏仅对齐输出,无法传递内部处理偏好;离散的路由跳跃会破坏思维链(Chain-of-Thought)的连续性,导致“路径断裂”(Path Rupture)并 destabilize 梯度。
- 专家同质化:经典的 MoE 负载均衡仅控制激活频率,忽略了专家质量,导致专家功能趋同。
为了解决上述问题,作者提出了一种名为 PADD(Path-Aligned Decompression Distillation)的框架,旨在将无路由器的稠密教师模型的知识蒸馏到 MoE 学生模型中,同时学习高质量的路由策略。
PADD 框架概述
论文提出的 PADD 框架将知识蒸馏组织为两个阶段共四个步骤。该框架旨在从稠密教师中恢复可学习的路径结构,并在固定推理成本下稳定专家专业化。
如图 1 所示,PADD 的整体架构分为:
- 初始化阶段(Stage I):通过教师神经元聚类和学生专家预热,构建学生专家的功能多样性。
- 训练阶段(Stages II–IV):在单一训练管道中整合在线自适应蒸馏、路径细化策略优化和奖励增强负载均衡。
核心方法详解
阶段 I:基于神经元聚类的专家初始化与预热对齐
为了解决路由器冷启动和专家同质化问题,PADD 在初始化阶段利用稠密教师 FFN 层的神经元激活模式来初始化学生专家。
-
激活统计与聚类: 作者提取稠密教师 FFN 中第一线性层()的神经元权重向量。尽管稠密模型没有显式路由,但其 FFN 神经元在相似输入下会共同激活,揭示了隐式的模块化结构。作者对教师神经元进行基数约束的 K-Means 聚类,将神经元划分为 个簇,每个簇对应学生模型的一个专家。 随后,计算每个簇在数据集上的激活分布,作为学生专家学习的目标分布。这一步骤仅进行统计,不训练学生模型。
-
专家预热(Expert Warmup): 利用聚类得到的质心初始化学生路由器权重。随后在冻结路由器的情况下,使用独立数据集对学生进行专家预热。这确保了所有专家在早期都能接收到均衡的训练信号,形成与教师隐式结构对齐的初始功能差异。
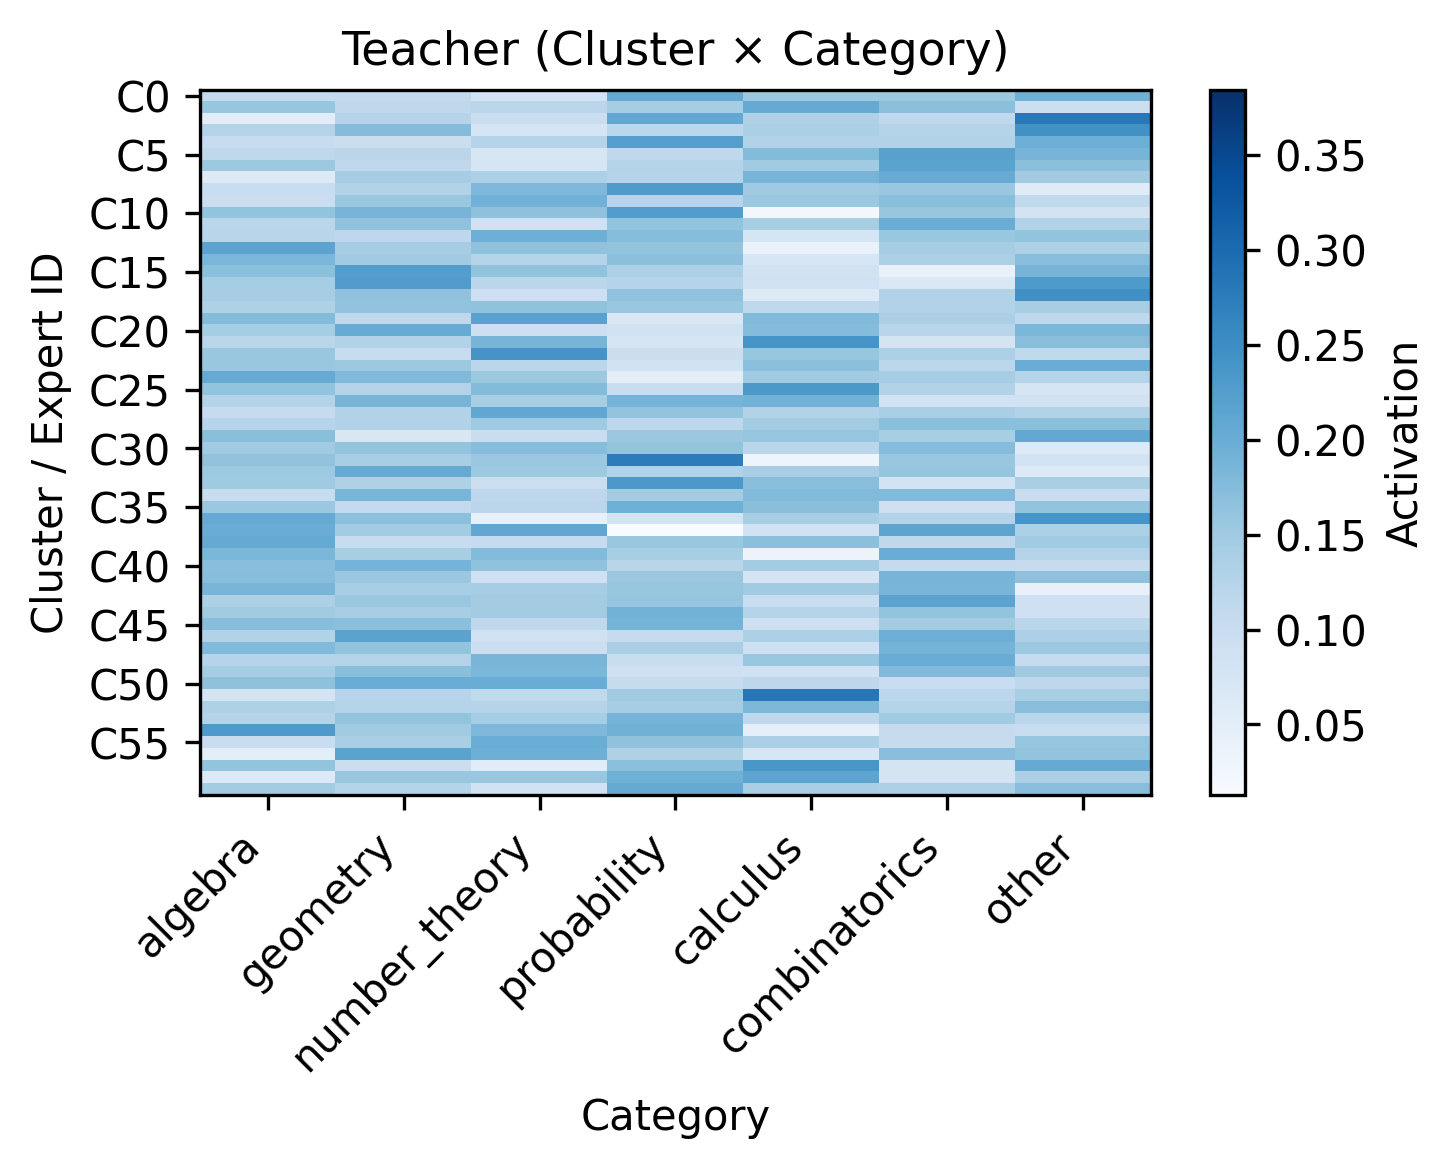
论文通过可视化展示了专家专业化结构的蒸馏效果。如图 3 所示,作者展示了在 Qwen 模型上专家专业化结构的蒸馏情况,热力图反映了教师模型神经元激活强度与 MoE 学生专家激活之间的对应关系,验证了初始化阶段成功捕捉到了教师的隐式结构。
阶段 II-IV:在线自适应蒸馏与策略优化
在初始化完成后,进入训练阶段,该阶段整合了多种机制以优化路由和知识吸收。
-
在线自适应蒸馏(Online Adaptive Distillation): 传统的离线蒸馏无法指导 MoE 学生学习路由决策。PADD 提出在线自适应机制,沿着学生实际的路由路径提供平滑且可吸收的语义监督。这有助于弥合稠密教师与 MoE 学生之间的容量差距,防止细粒度 logits 无法被吸收。
-
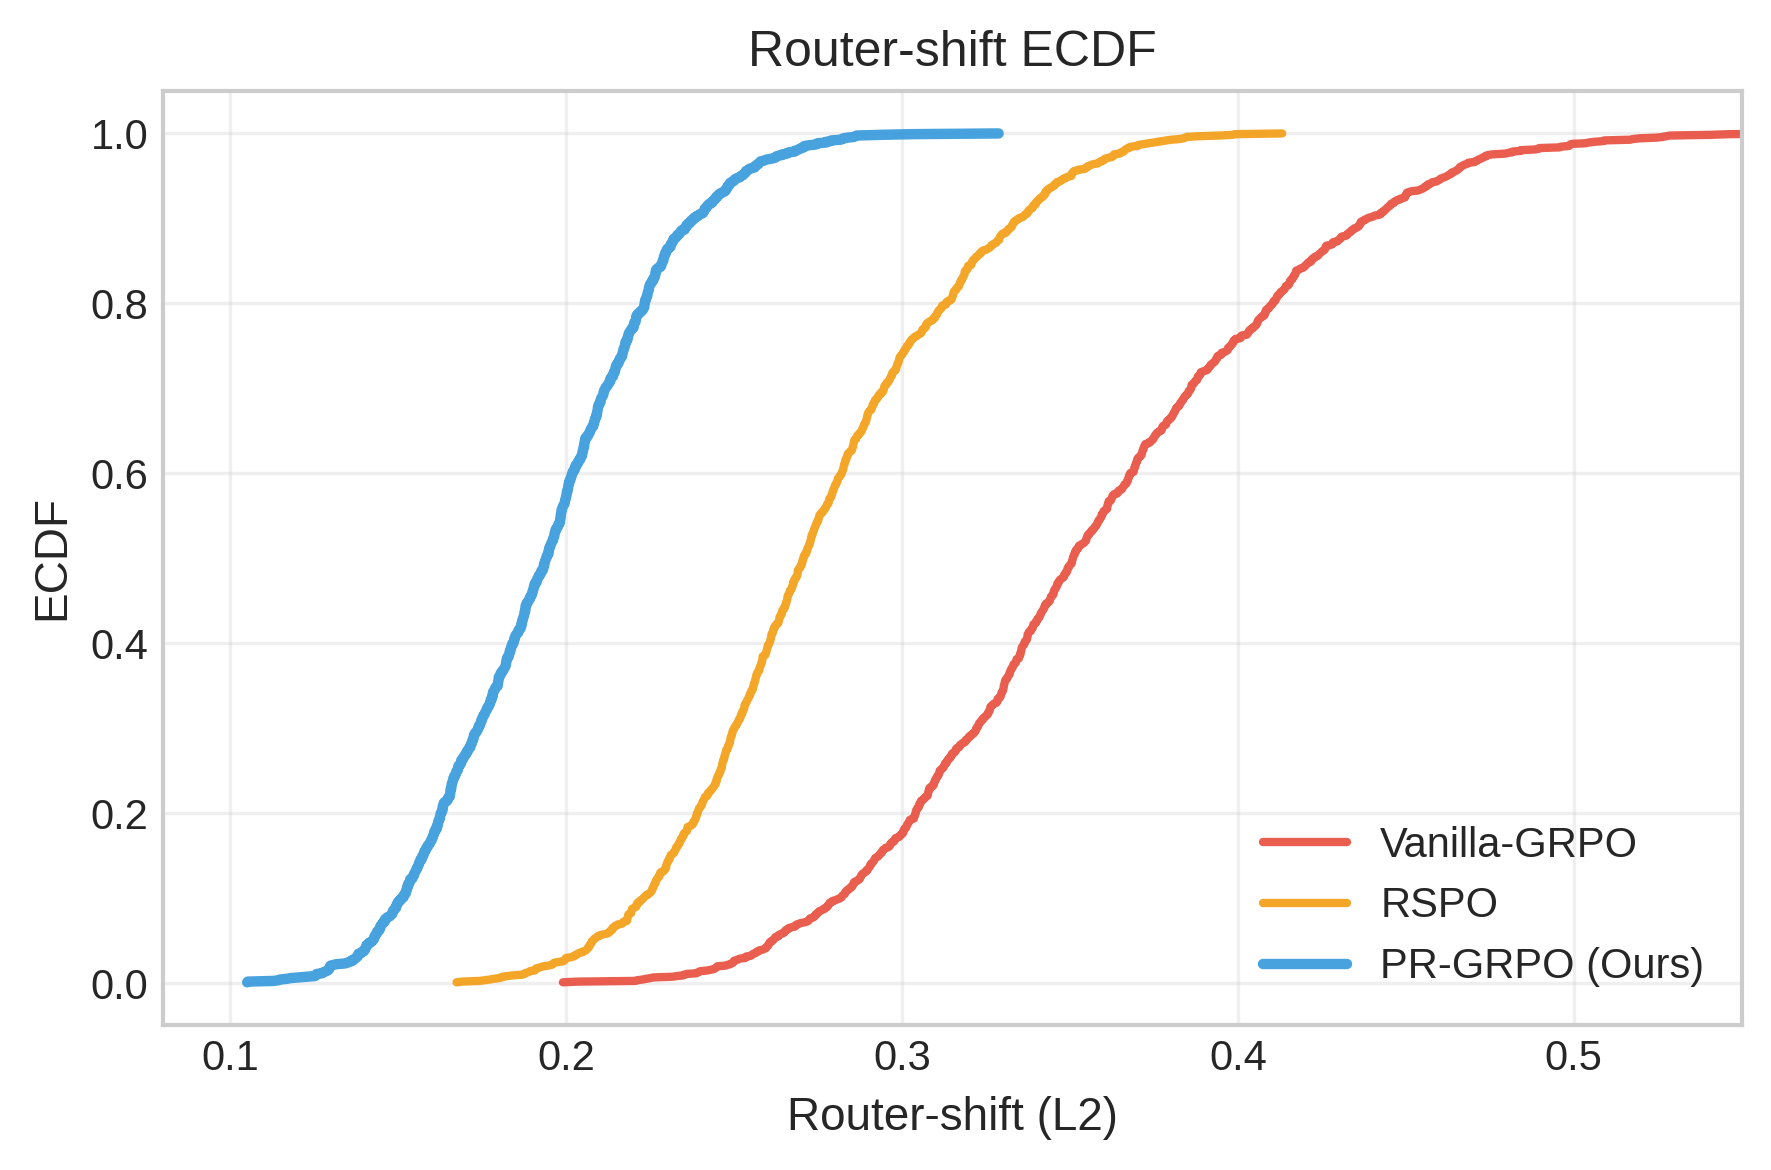
路径细化组相对策略优化(PR-GRPO): 为了处理离散路由跳跃导致的梯度不稳定问题,作者提出了 PR-GRPO。该方法利用路由偏移(Routing Shifts)来抑制不稳定性,显著提高了 MoE 强化学习的稳定性。 如图 5 所示,作者展示了路由器偏移(Router-shift)的累积分布函数(ECDF)。结果显示,PR-GRPO 使得分布向左偏移且尾部更轻,这与正文中提到的均值稳定性一致,表明该方法有效减少了极端的路由变化,增强了训练稳定性。
- 奖励增强负载均衡(Reward-Augmented Load Balancing): 传统的负载均衡仅关注激活频率,容易导致专家同质化。PADD 提出的负载均衡机制联合建模了专家激活频率和性能质量。通过增加高质量专家的激活概率,该方法缓解了传统负载均衡诱导的“专家同质化”现象,增强了 MoE 专家之间的长期分工协作。
实验结果与分析
作者在数学推理基准测试上进行了实验,评估 PADD 框架的有效性。实验结果表明:
- 性能增益:在相同的推理成本下,PADD 相比强基线方法取得了实质性的性能提升。
- 超越教师:MoE 学生模型能够匹配甚至超越其稠密教师模型的性能,证明了从稠密到 MoE 蒸馏的有效性。
- 路由稳定性:实验展示了有效的教师到学生知识蒸馏以及稳定的路由行为,验证了 PR-GRPO 和负载均衡机制的作用。
总结
本文提出的 PADD 框架为稠密模型到 MoE 模型的知识蒸馏提供了一个统一的解决方案。通过四个阶段的系统性设计,PADD 解决了路由器冷启动、容量差距、路径断裂和专家同质化等核心挑战。
作者的主要贡献在于:
- 提出了包含初始化和训练两个阶段的四阶段蒸馏框架。
- 利用教师神经元聚类构建学生专家初始化,从源头缓解冷启动问题。
- 提出了在线自适应蒸馏和 PR-GRPO 算法,提升了 MoE 强化学习的稳定性。
- 设计了奖励增强负载均衡,优化了专家分工。
该研究为在固定计算预算下利用稠密教师模型指导 MoE 学生学习提供了新的思路,展示了 MoE 架构在继承稠密模型知识方面的巨大潜力。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。