
The Confident Liar: Diagnosing Multi-Agent Debate with Log-Probabilities and LLM-as-Judge
作者:Ali Keramati, Justin Cheok, Jacob Horne, Mark Warschauer
作者研究了多智能体辩论中 token 级 log-probability 分布、LLM-as-judge 评分与最终任务准确率三者之间的关系。论文采用双智能体(构建者与审计者)辩论架构,结合 LLM 法官对推理过程进行细粒度评分。旨在通过内部置信度信号诊断外部评估的推理质量及任务正确性。
论文信息摘要
论文要解决什么
现有评估多智能体辩论系统时通常仅关注最终答案正确性,忽略了中间推理过程的质量、连贯性与可靠性。作者试图解决如何量化内部置信度信号与外部推理质量评估之间的一致性,以及如何利用这些信号诊断推理失败模式的问题。
论文方法概览
- Backbone: LLM (用于智能体与法官)
- 关键模块: 双智能体辩论架构 (Constructor & Auditor), LLM-as-Judge 评分模块
- 损失函数: N/A (诊断性研究,使用 AUROC 与相关性分析)
读后要点
个人理解,欢迎指正
实验揭示了辩论过程中存在一致的四阶段置信度轨迹。发现显著的角色不对称性:构建者(Constructor)的置信度与判定推理质量的一致性约为审计者(Auditor)的两倍。基于置信度的关键推理失败检测对构建者更可靠(AUROC 0.804 vs 0.634)。
局限与疑问
研究主要基于特定领域(如评分标准领域)的实验,跨领域泛化性有待进一步验证。LLM-as-judge 评估本身可能存在主观性偏差。内部置信度信号在不同模型家族间的表现差异未完全探索。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.10296v1。
arXiv 阅读笔记 | The Confident Liar: Diagnosing Multi-Agent Debate with Log-Probabilities and LLM-as-Judge
1. 研究背景与动机
多智能体辩论系统(Multi-agent debate systems)近年来在提升大型语言模型(LLM)的推理能力、鲁棒性和一致性方面展现出巨大潜力。然而,论文指出当前这类系统的评估存在一个根本性的挑战:大多数设置仅使用最终答案是否正确作为评估信号。这种二元信号无法捕捉辩论过程中产生的中间推理的质量、连贯性或可靠性。
作者认为,一个智能体可能通过有缺陷的推理得出正确答案,也可能产生深思熟虑的论证却导致结论略微错误。仅评估端点会丢弃辩论旨在激发的丰富中间轨迹。随着多智能体管道复杂性的增加,基于准确率的指标可能无法检测到新兴的失败模式,而这些模式在智能体推理的结构中是可检测的。
为了解决这一问题,论文提出研究多智能体辩论中三个信号之间的关系:
- 推理 token 的 token 级 log-probability 分布(内部置信度信号)。
- 分配给这些 token 的 LLM-as-judge 评分标准分数(外部评估的推理质量)。
- 最终任务准确率。
2. 核心框架与评估信号
论文构建了一个系统性的调查框架,旨在跨多个领域(基于评分标准的评分、数学推理、事实性问答)研究上述三个信号的三角关系。
2.1 双智能体辩论架构
作者提出的框架包含一个双智能体辩论架构,由两个角色组成:
- Constructor(构建者):负责生成论证或解决方案。
- Auditor(审计者):负责审查和评估构建者的输出。
2.2 LLM-as-Judge 评估机制
该框架结合了一个 LLM-as-judge 模块,用于对每个智能体的推理进行评分。评分标准包括:
- 指令遵循(Instruction following)。
- 论证质量(Justification quality)。
- 证据 grounding(Evidence grounding)。
- 关键失败标记(Critical-failure flag)。
这种方法旨在评估智能体的论证是否在逻辑上 grounded、是否考虑了反证,以及是否实质性地参与了任务,这些维度是最终准确率无法捕捉的。
2.3 置信度估计
论文利用 token 级的 log-probabilities 进行置信度估计。直觉上,如果智能体遵循更连贯且证据充分的推理路径,模型应为其生成的 token 分配更高的概率质量,从而产生更集中的 logprob 轨迹。相反,不确定或矛盾的推理可能表现为高熵或尖峰概率分布。
3. 实验发现与关键洞察
论文在基于评分标准的领域(rubric-scoring domain)进行了实验,揭示了关于置信度轨迹和角色不对称性的重要发现。
3.1 置信度轨迹的四阶段模式
实验结果显示,辩论过程中存在一致的四个阶段置信度轨迹。作者通过可视化展示了 token 级平均置信度随辩论轮次的变化。
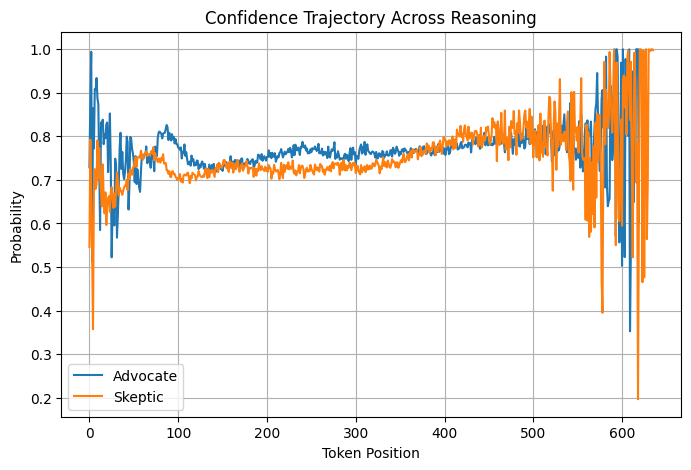
上图(Figure 2)展示了不同辩论阶段中 token 级平均置信度的轨迹。这一可视化帮助研究者理解智能体在辩论不同阶段的内部确定性如何演变。
3.2 角色不对称性(Role Asymmetry)
论文发现了一个显著的角色不对称现象:
- 置信度与推理质量的一致性:置信度与判定的推理质量的一致性,对于 Constructor 而言大约是 Auditor 的两倍。
- 关键失败检测的可靠性:基于置信度的关键推理失败检测对于 Constructor 更为可靠。具体数据表明,Constructor 的 AUROC 为 0.804,而 Auditor 仅为 0.634。
这一发现表明,内部置信度信号在不同角色中的诊断价值存在差异,不能简单地将单一置信度阈值应用于所有辩论参与者。
3.3 跨信号相关性
论文进一步探讨了 logprob 分布、LLM-as-judge 推理分数和任务准确率之间的系统性相关性。研究发现这种相关性会随任务类型、模型家族或辩论配置的变化而变化。这种发散性(divergence)可以被用来诊断多智能体辩论系统中的失败模式。
4. 研究问题(Research Questions)
为了指导这一跨领域调查,论文提出了三个核心研究问题:
-
RQ 1: 辩论中的 Logprob 动态
- RQ 1.1: Token 级 log-probability 分布如何在辩论轮次间演变?表达更高置信度推理的智能体是否会产生更高质量的论证?
- RQ 1.2: 基于 log-probability 的特征能否独立于中间推理内容预测最终任务准确率?
-
RQ 2: 辩论推理的 LLM-as-Judge 评估
- RQ 2.1: 应如何设计评分标准以评估多智能体辩论中的中间推理 token?LLM 法官在不同模型和协议间的一致性如何?
- RQ 2.2: 中间推理的 LLM-as-judge 分数在多大程度上与不同任务的最终答案正确性相关?
-
RQ 3: 跨信号相关性与诊断
- RQ 3.1: logprob 分布、LLM-as-judge 推理分数和任务准确率之间是否存在系统性相关性?
- RQ 3.2: 内部置信度信号与外部推理质量评估之间的发散能否被利用来诊断多智能体辩论系统中的失败模式?
5. 总结与展望
本文《The Confident Liar》通过结合内部生成信号(log-probabilities)和外部评估信号(LLM-as-judge),为多智能体辩论系统提供了一种新的诊断视角。作者认为,仅关注最终答案正确性会忽略中间推理质量,而通过量化内部置信度与外部评分之间的关系,可以更细致地理解智能体的行为。
论文的主要贡献在于揭示了置信度信号在不同辩论角色中的不对称性,并提出了利用这种不对称性来检测关键推理失败的可能性。未来的工作将基于这些发现,进一步扩展跨领域的调查,以优化多智能体系统的设计,使其不仅追求答案的正确性,更追求推理过程的可信度与质量。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。