
Correct Looks Better: Pairwise Comparisons Reveal Accuracy Rankings
作者:Mina Remeli, Moritz Hardt
作者通过将五个已知基准测试转化为自由形式生成评估,验证了基于成对比较(如 Elo 排名)的模型排序与基于地面真值的准确率排序高度一致。研究发现即使评估者能力较弱,成对比较排名仍能准确反映模型性能,且风格与偏见对整体排名影响有限。
论文信息摘要
论文要解决什么
验证在存在地面真值的情况下,基于成对比较的评估排名是否真正反映了模型的准确性,而非仅奖励表面风格或受评估者偏见影响。
论文方法概览
- Backbone: LLM Judge (如 gpt-oss-20b)
- 关键模块: 成对比较聚合算法 (Elo/Bradley-Terry)
- 损失函数: 无 (评估指标为 Spearman 相关系数等)
读后要点
个人理解,欢迎指正
实验表明成对比较排名与准确率排名的 Spearman 相关系数高于 0.9。在评估者较弱时,成对比较优于直接评估。在非判别性对(双对或双错)中,答案后的重复(echo)是驱动偏好的因果因素。
局限与疑问
仅验证了五个基准测试,结论的普适性待进一步验证。评估者模型的选择可能影响结果。回声效应虽对排名影响小,但仍需关注其对单次判断的干扰。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.09409v1。
论文阅读笔记:Correct Looks Better: Pairwise Comparisons Reveal Accuracy Rankings
研究背景与动机
随着生成式人工智能模型的快速发展,评估模型性能的方法也经历了显著演变。目前,结合 Elo 或 Bradley-Terry 等聚合算法的**成对比较(Pairwise Comparisons)**已成为评估生成模型的核心工具。这种方法在 Chatbot Arena 等开放设置中尤为流行,因为它易于收集数据,且能在难以进行绝对测量的情况下自然产生相对排名。
然而,学术界对成对比较的有效性存在持续担忧。批评者认为,这种方法可能奖励表面的风格线索(如长度、格式),或者反映评估者(Judge)的个人偏见,导致“看起来更好”的答案被选中,而非“实际上更正确”的答案。特别是在缺乏地面真值(Ground Truth)或评估者能力弱于待评估模型的情况下,这些担忧尤为突出。
基于此,论文作者 Mina Remeli 和 Moritz Hardt 提出了一个基本但尚未得到充分回答的问题:当地面真值可用时,基于成对偏好的排名是否真的反映了准确性?
实验设置与方法
为了直接测试这一问题,作者将五个具有地面真值的知名基准测试(MMLU Pro, GPQA Diamond, Simple QA, GSM8K, BBH)转换为自由形式的生成评估协议。
论文提出了一种通用的评估流程(文中 Figure 2 展示了该流程,此处以文字描述):
- 标准评估设置:通常基准测试要求模型遵循特定结构(如选择题)。作者通过移除选项等方式将其转化为自由形式生成任务。
- 准确性排名:基于地面真值计算模型的准确率。
- 成对比较排名:使用 LLM 作为评估者(如 gpt-oss-20b)收集成对比较数据,并通过 Elo 或 Bradley-Terry 算法聚合得分。
作者旨在比较这两种排名方式的一致性,特别是在评估者能力较弱(Evaluation Frontier)的场景下。
核心发现:成对比较与准确性的对齐
论文的核心发现是,基于偏好的排名与基于准确性的排名之间存在惊人的高度一致性。
在五个基准测试中,作者观察到偏好排名与地面真值准确性排名之间具有极高的秩相关性(Spearman’s ρ > 0.9)和线性相关性(R² > 0.87)。这意味着,即使没有直接访问地面真值,仅通过成对比较也能恢复出与直接评估几乎相同的模型排序。
为了更直观地展示这种对齐情况,论文提供了详细的可视化分析。如下所示,左侧展示了基于准确性的模型排名,右侧展示了基于 Bradley-Terry 分数的排名,两者高度吻合:
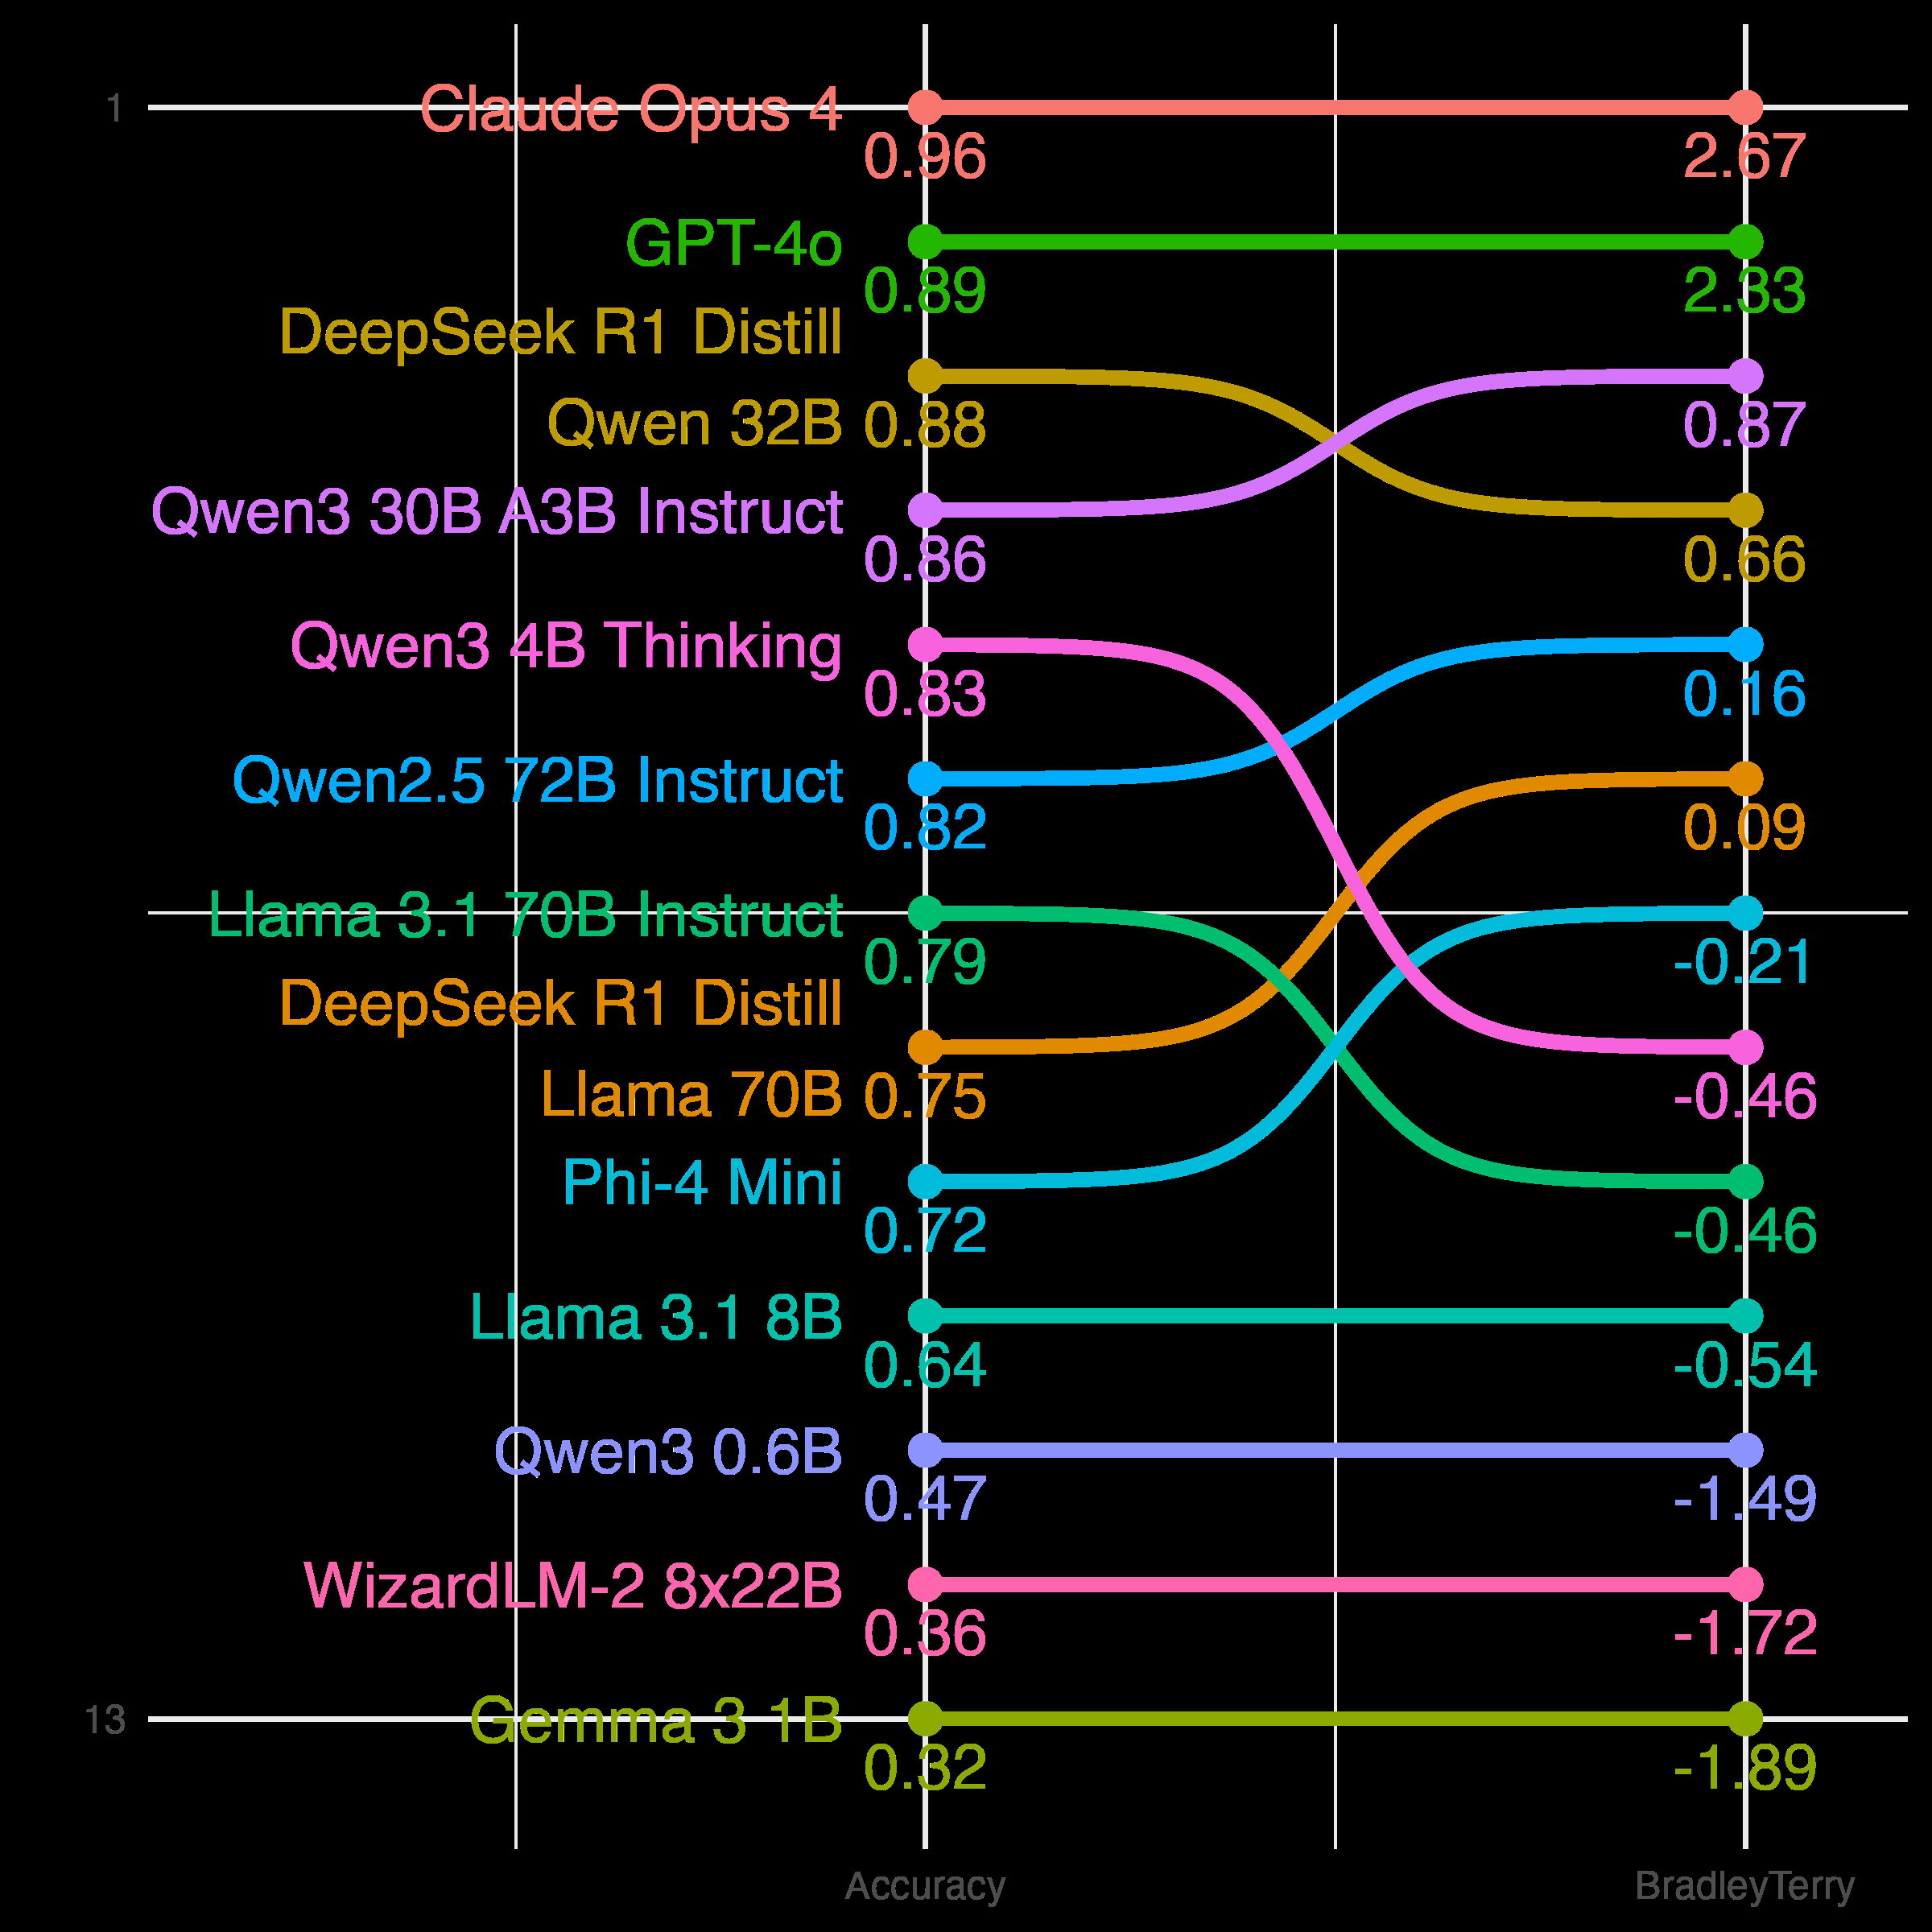
这一结果表明,至少在所测试的任务中,成对比较能够有效地捕捉到模型的真实能力差异,而不仅仅是表面特征。
弱评估者场景下的优势
论文特别关注了“评估前沿”场景,即评估者模型本身无法可靠解决任务,甚至弱于候选模型的情况。在这种极端条件下,直接询问评估者答案是否正确往往会导致排名严重偏离地面真值。
相比之下,即使评估者较弱,基于成对偏好的排名仍然与准确性排名保持良好的对齐。论文通过实验数据指出,在 SimpleQA 等任务上,直接使用弱评估者判断正确性会导致排名距离加倍,而成对比较则能维持较好的排序效果。
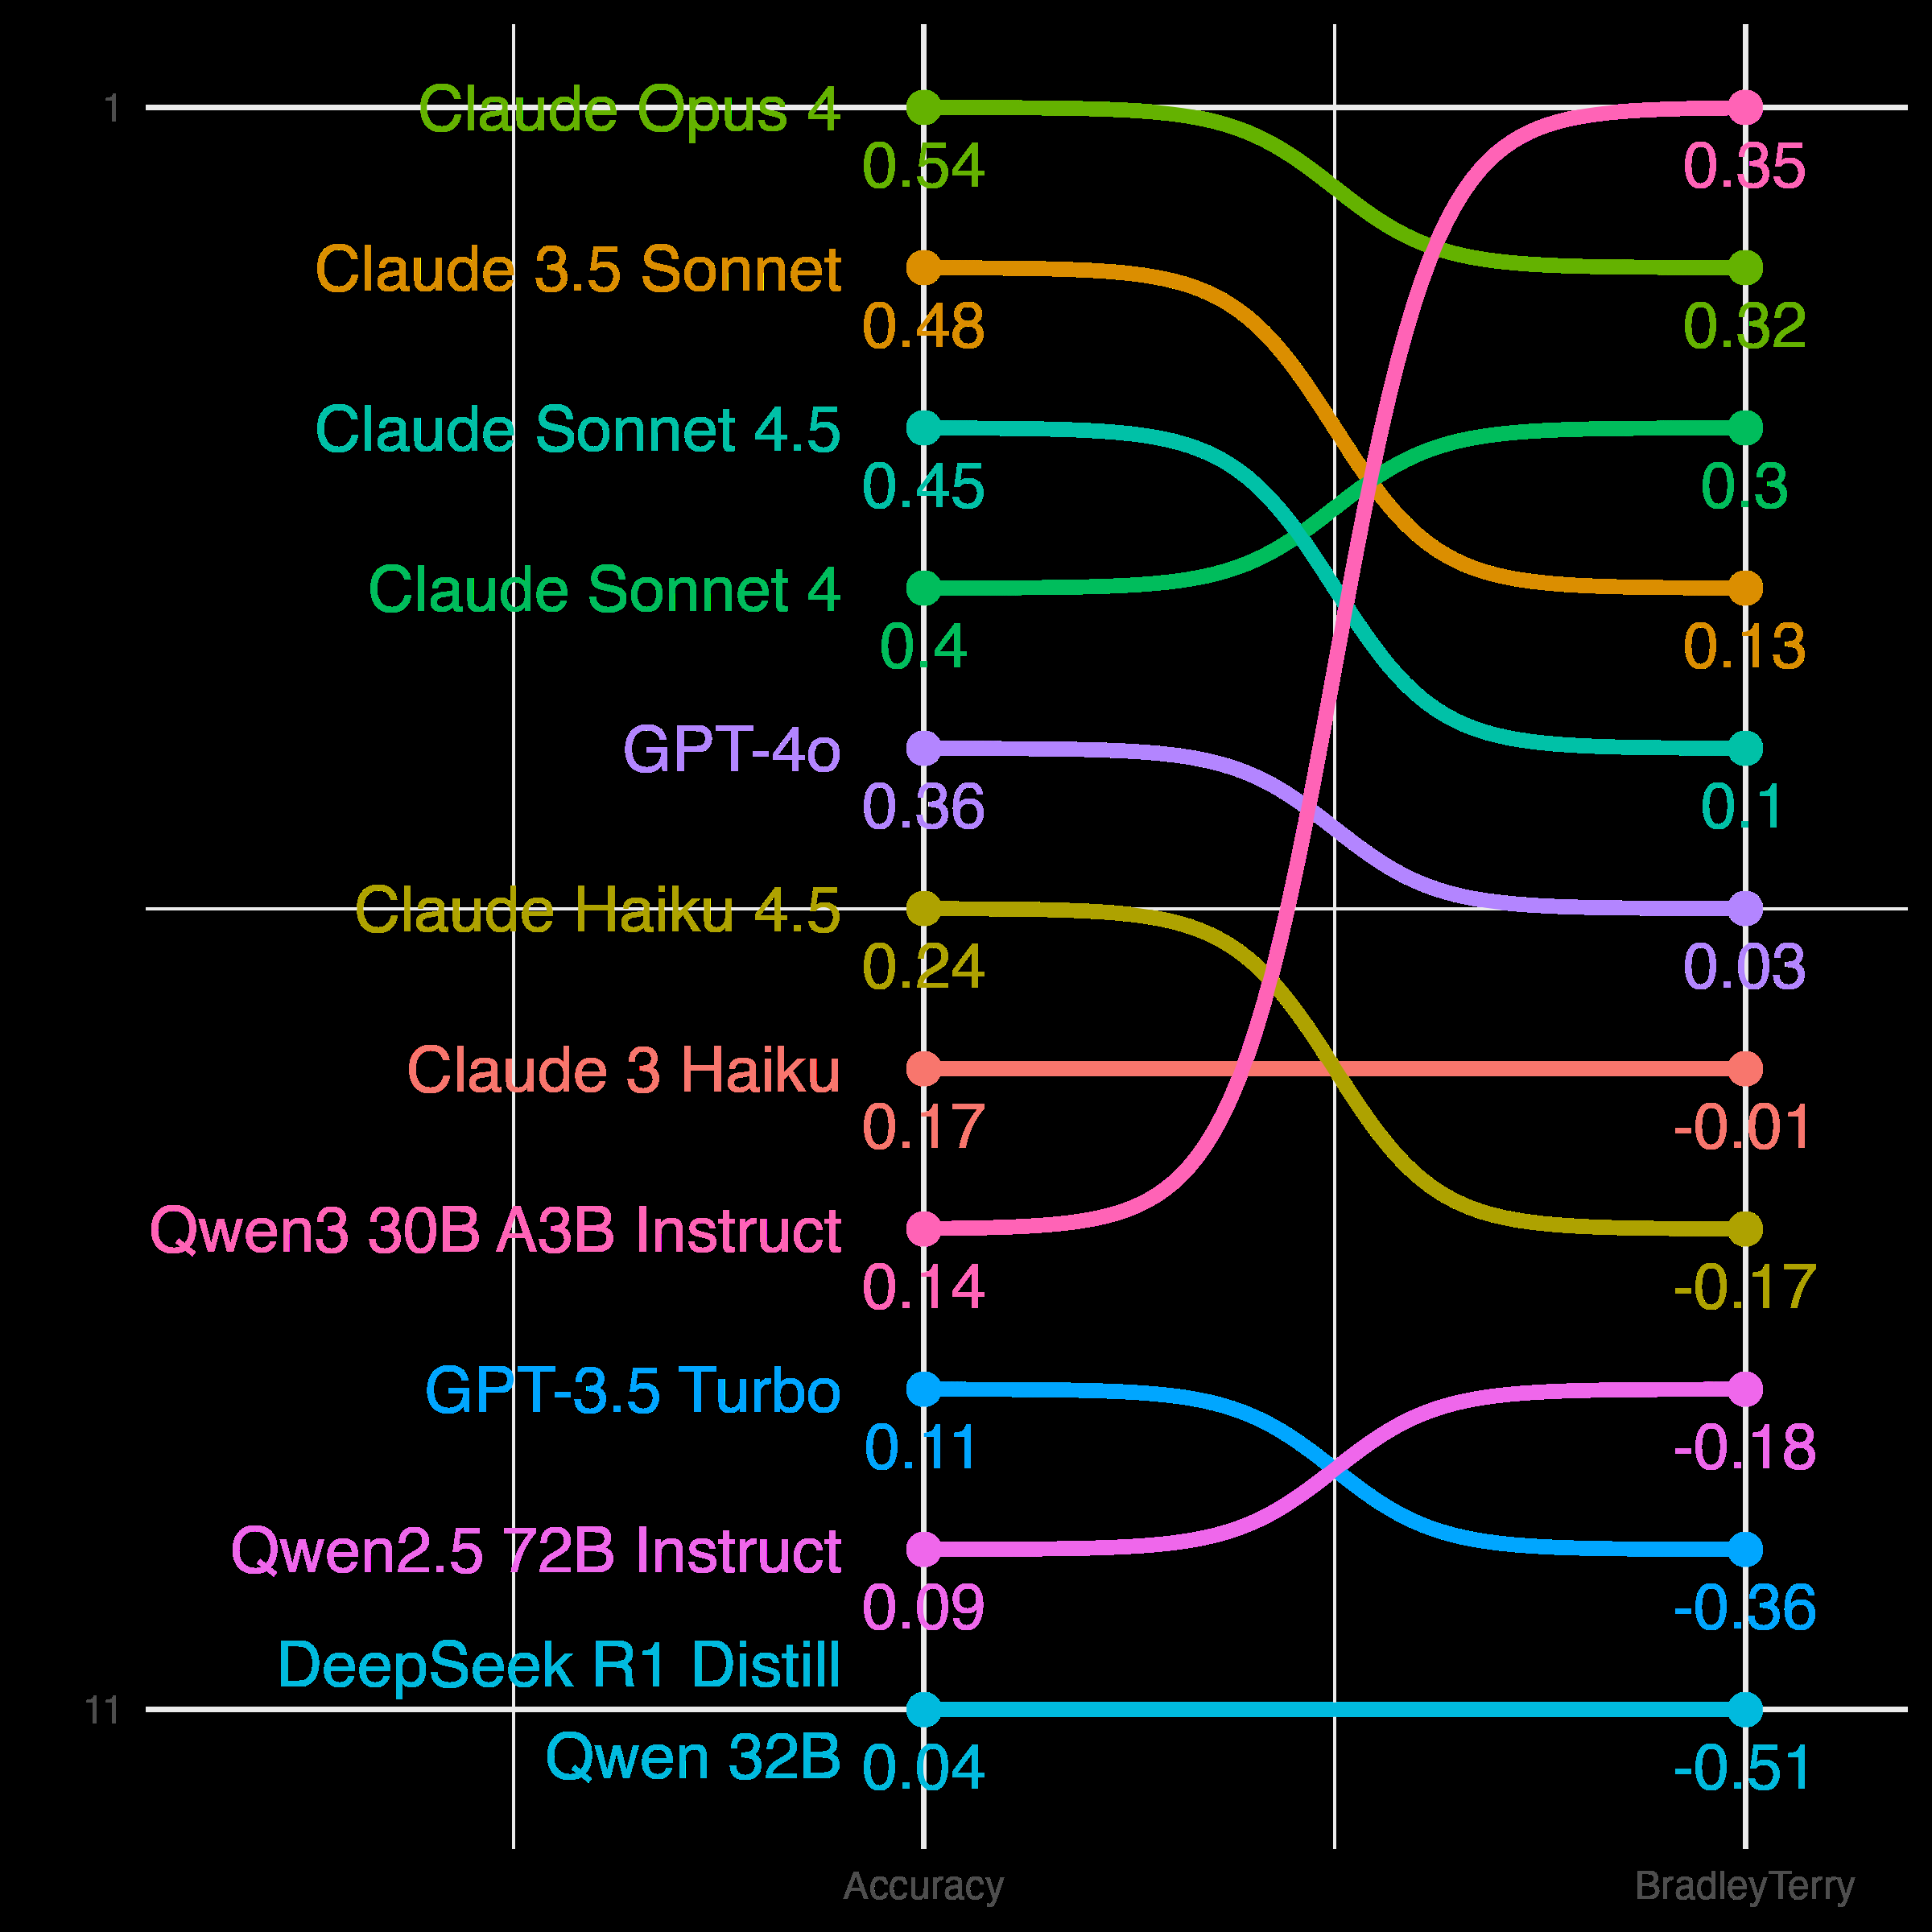
这一发现具有反直觉的含义:我们可以在不知道模型准确性的情况下,通过成对比较来对模型进行准确性排名。这为在缺乏强评估者或地面真值稀缺的场景下评估模型提供了强有力的理论支持。
偏差与风格的影响分析
尽管成对比较表现优异,但作者并未忽视关于风格(Style)和评估者偏见(Judge Bias)的担忧。文献中常提到的两个主要偏见来源是风格偏好和自我偏好(Self-preference)。
论文指出,尽管近 60% 的成对比较发生在“非判别性对”(Non-discriminative pairs)上——即两个候选答案都正确或都不正确——但风格和偏见对最终排名的影响非常有限。作者发现,修正这些偏见对排名的影响微乎其微。
在非判别性对中,作者识别出了一个因果驱动因素:回声(Echo)。即模型在最终答案后的重复行为。研究发现,在两个答案正确性相同的情况下,包含“回声”(重复最终答案)的回答更容易获得评估者的偏好。这表明虽然表面线索会影响单次判断,但在聚合为排名时,这种影响并未破坏整体的准确性排序。
总结与启示
这篇论文通过严谨的对照实验,为成对比较评估方法的有效性提供了强有力的证据。主要结论如下:
- 排名一致性:成对比较排名与地面真值准确性排名高度一致(Spearman 相关系数 > 0.9)。
- 弱评估者鲁棒性:在评估者能力不足时,成对比较优于直接评估,能更好地反映真实能力。
- 偏见影响有限:风格和评估者偏见对整体排名的影响较小,尽管它们可能影响单次判断。
- 回声效应:在非判别性对中,答案后的重复是驱动偏好的关键因素。
作者认为,这些发现缓解了关于成对比较仅奖励表面风格的担忧。虽然风格和偏见确实会阻碍绝对测量,但它们对相对排名的影响远小于预期。这一结论对于依赖成对比较进行模型评估的社区(如 Chatbot Arena)具有重要的指导意义,表明当前的评估范式在反映模型真实性能方面是可靠的。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。