ForceForget: Reinforcement Concept Removal for Enhancing Safety in Text-to-Image Models
作者:Dong Han, Yong Li
作者提出 ForceForget 框架,利用强化学习优化概念擦除奖励(CER),在消除不安全内容的同时保持模型对安全语义的解释能力。通过引入 Safe Adapter 模块投影部分文本嵌入,在交叉注意力层实现高效的概念调节,避免过度擦除良性概念。
论文信息摘要
论文要解决什么
现有的文本到图像(T2I)概念擦除方法倾向于过度移除不安全概念,同时抑制有害提示中包含的良性概念,从而负面影响模型效用。此外,现有方法在图像到图像(I2I)场景及对抗攻击下的鲁棒性不足。
论文方法概览
- Backbone: Stable Diffusion (SD v1.4)
- 关键模块: Safe Adapter (投影部分文本嵌入至交叉注意力层)
- 损失函数: Concept Erasing Reward (CER) 优化 (基于强化学习)
读后要点
个人理解,欢迎指正
实验表明该方法在缓解不安全内容生成的同时,能更好地保留良性图像的高保真度,优于现有 SOTA 概念擦除方法。在对抗红队工具攻击时表现出更强的鲁棒性,且在 I2I 场景下具有更好的迁移效果。
局限与疑问
论文未明确列出具体使用的基准数据集名称,仅提及“不同数据集”和“公共数据集”。强化学习训练过程的计算成本及收敛稳定性有待进一步验证。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.14351v1。
论文基本信息
- 论文标题:ForceForget: Reinforcement Concept Removal for Enhancing Safety in Text-to-Image Models
- 论文 ID:2606.14351v1
- 作者:Dong Han, Yong Li
- 发表会议:ICML 2026 (Proceedings of the 43rd International Conference on Machine Learning)
- 研究领域:生成式 AI 安全、文本到图像(T2I)模型、概念移除、强化学习
研究背景与动机
随着生成式人工智能的快速发展,文本到图像(T2I)模型(如 Stable Diffusion, MidJourney, DALL·E 2)已具备生成多样化内容的能力。然而,这些模型仍可能生成不安全的内容,引发了学术界和工业界对内容安全的关注。
论文指出,现有的缓解不安全内容生成的方法存在显著局限性:
- 数据集过滤:移除训练数据中的有害物质可能会意外影响下游性能。
- 后处理过滤:基于预定义不安全概念的过滤器容易被逆向工程绕过。
- 微调与训练-free 方法:现有的概念移除方法(如 ESD, SLD, SafeGen 等)倾向于过度移除不安全概念,同时抑制了有害提示中包含的良性概念(例如,移除“裸露”概念时可能连带抑制了“人”这一良性概念),从而负面影响模型的实用性(Utility)。
- I2I 场景不足:现有的 T2I 概念移除方法在图像到图像(I2I)任务中效果不佳,无法有效应对 I2I 场景下的隐私和安全风险。
为了解决上述问题,作者提出了一种新的框架,旨在消除不安全内容的同时,保持模型对安全语义含义的解释能力。
核心方法:ForceForget
作者提出了名为 ForceForget 的概念移除框架。该方法将概念移除重构为强化学习(RL)中的奖励优化问题。
1. 强化学习框架与奖励优化
受利用 RL 调整扩散模型以适应模糊目标(如图像压缩性、美学质量)成功的启发,ForceForget 利用动态奖励更新来移除不安全内容。论文设计了特定的安全奖励和对齐奖励(Safety and Alignment Reward),通过优化概念移除奖励(Concept Erasing Reward, CER)来指导模型学习。
2. Safe Adapter 模块
为了避免内容过度擦除,作者在扩散模型的交叉注意力层(cross-attention layers)中引入了 Safe Adapter。该模块用于投影部分文本嵌入(partial text embedding),从而实现对概念的高效调节。通过这种方式,模型可以更精准地控制特定概念的生成,而不影响其他良性语义。
3. 整体流程
论文展示了 ForceForget 的整体流程。如图 2 所示,给定提示中的目标移除概念,模型会持续生成图像样本,并通过设计的奖励机制进行优化。
实验结果与分析
作者在多个数据集上进行了广泛实验,验证了 ForceForget 在缓解不安全内容生成、保持良性图像高保真度以及鲁棒性方面的有效性。
1. 安全性与实用性的平衡
现有方法往往在移除不安全概念时损害模型生成人类导向内容的能力。ForceForget 通过 RL 优化,在移除不安全内容的同时,更好地保留了良性概念。
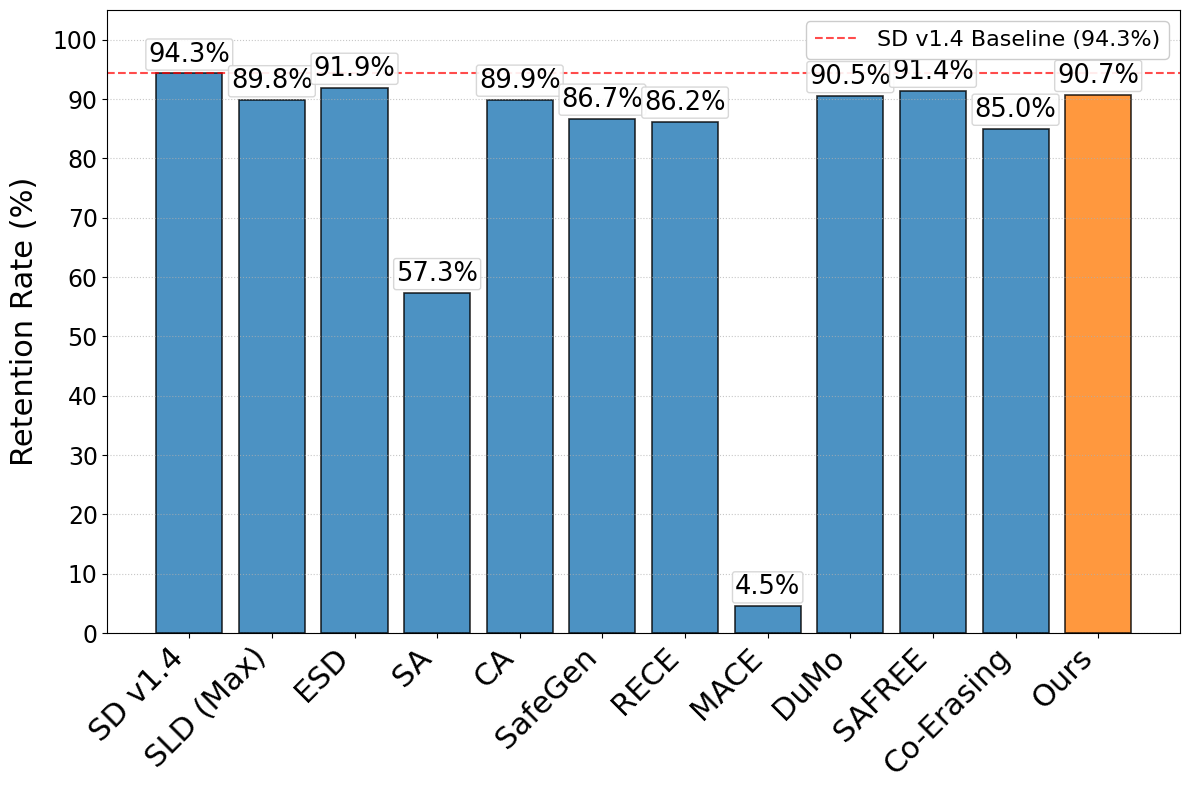
- 名人生成保留率:如图 3 所示,ForceForget 在移除不安全概念后,仍能保持较高的名人生成保留率,表明其在处理涉及“人”的提示时,未过度抑制良性特征。
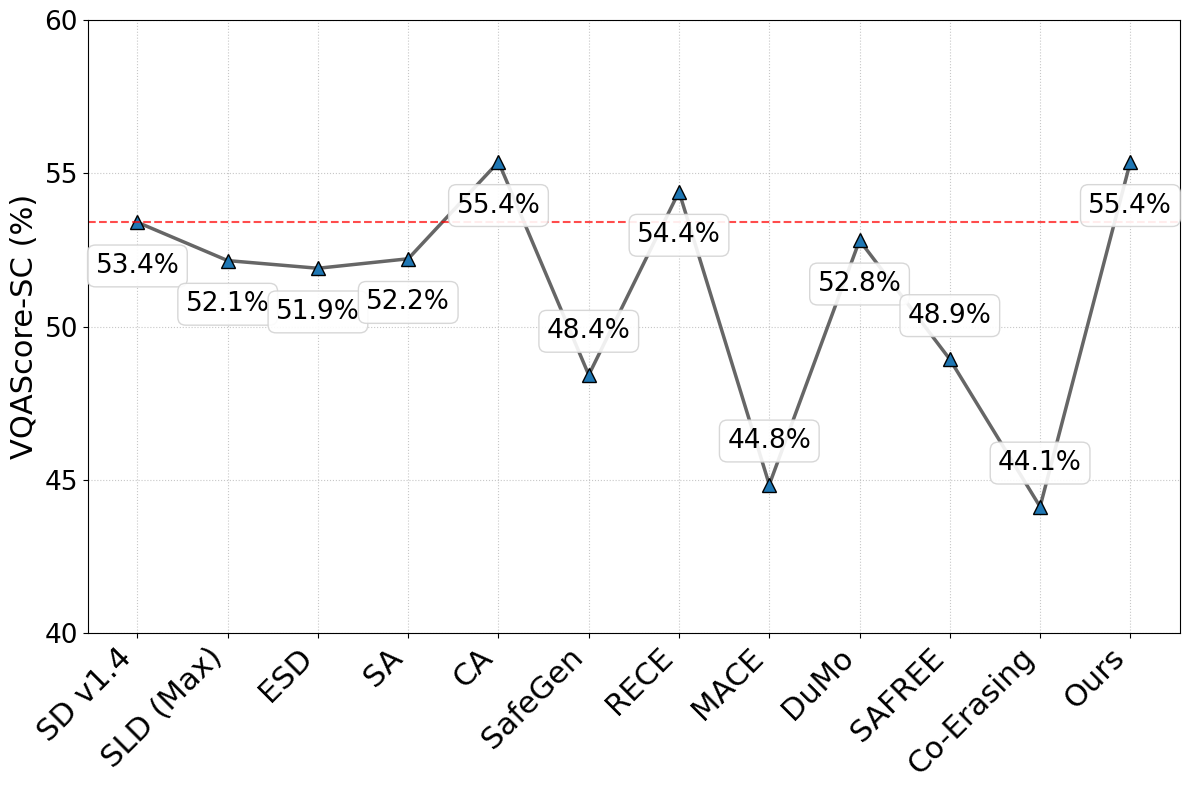
- 安全内容评分:图 4 展示了 VQAScore-SC 指标,表明该方法在保持安全内容质量方面优于现有最先进(SOTA)方法。
2. 鲁棒性与对抗攻击
论文评估了该方法对抗红队工具(red-teaming tools)攻击的鲁棒性。实验表明,ForceForget 在面对旨在绕过安全机制的对抗性提示时,表现优于对比方法。
3. 图像到图像(I2I)场景的迁移性
针对 I2I 任务中现有概念移除方法效果不佳的问题,作者展示了 ForceForget 在该场景下的优越性。
- I2I 裸露移除:如图 6 所示,在 I2I 设置下,ForceForget 能够有效“净化”不需要的输入概念,移除裸露内容,同时保持图像的整体结构。
4. 通用概念移除的扩展
除了安全性,作者还将该方法扩展到了通用概念的移除,例如艺术风格和特定物体。
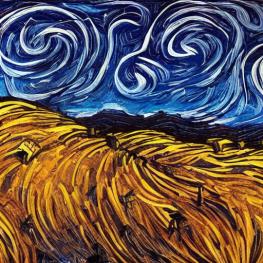
- 艺术风格移除:如图 5 所示,该方法可以移除特定的艺术风格(如梵高风格),同时保留其他风格特征。
- 功能概览:图 1 总结了 ForceForget 的多项能力,包括消除不安全内容、保护艺术作品版权、移除特定物体以及在 I2I 设置中净化输入概念。
总结与展望
论文认为,ForceForget 是首个尝试通过强化学习微调 T2I 扩散模型来消除色情内容生成的方法。其主要贡献包括:
- 指出了当前 SOTA 概念移除方法存在过度擦除和损害模型实用性的问题。
- 提出了结合 RL 奖励优化和 Safe Adapter 的 ForceForget 框架。
- 验证了该方法在安全性、实用性、鲁棒性以及 I2I 场景迁移性上的优势。
- 展示了该方法在移除通用概念(如艺术风格、物体)上的泛化能力。
该研究为生成式 AI 的安全对齐提供了新的思路,特别是在平衡内容安全与模型生成能力方面取得了进展。作者同时也声明,论文中涉及的内容讨论可能包含对某些读者具有冒犯性的性暗示内容,但所有使用的图像均为合成或来自公共数据集。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。