One Layer's Trash is Another Layer's Treasure: Adaptive Layer-wise Visual Token Selection in LVLMs
作者:Yongru Chen, Kai Zhang, Zeliang Zong, Yuchen Lu, Wenming Tan
作者提出自适应层级视觉 Token 选择(ALVTS)框架,利用轻量级选择器动态识别重要 Token 参与计算,次要 Token 跳过当前层并在后续层重新整合。该方法基于重要性一致性约束的低秩近似,无需模型重新训练即可模拟全注意力机制。
论文信息摘要
论文要解决什么
解决大型视觉语言模型因视觉 Token 冗长导致的计算负担,以及现有剪枝方法因单层静态剪枝导致后续层信息丢失的问题。
论文方法概览
- Backbone: LLaVA-1.5 / LLaVA-NeXT / Qwen2.5-VL
- 关键模块: 轻量级 Token 选择器 (ALVTS)
- 损失函数: 无 (推理阶段优化,无需训练)
读后要点
个人理解,欢迎指正
论文实验表明不同网络层对视觉区域的关注点存在显著差异,动态层间选择比静态剪枝更能保留关键信息,在 89% 压缩率下保留了 96.7% 的原始准确率。
局限与疑问
选择器模块本身可能引入额外的计算开销,且方法主要验证于特定 LVLM 架构,对其他架构的泛化性有待进一步验证。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.14277v1。
arXiv 论文阅读笔记:One Layer’s Trash is Another Layer’s Treasure
论文基本信息
- 论文标题:One Layer’s Trash is Another Layer’s Treasure: Adaptive Layer-wise Visual Token Selection in LVLMs
- 论文 ID:2606.14277v1
- 作者:Yongru Chen, Kai Zhang, Zeliang Zong, Yuchen Lu, Wenming Tan, Ye Ren, Jilin Hu
- 机构:海康威视研究院、北京大学、华东师范大学
- 核心主题:大型视觉 - 语言模型(LVLM)中的视觉 Token 压缩与推理加速
研究背景与动机
大型视觉 - 语言模型(LVLMs)在多模态任务中取得了显著成功,但在实际部署中面临巨大的计算负担。论文指出,这一负担主要源于处理图像时产生的冗长视觉 Token。例如,LLaVA-NeXT 在处理 672 × 672 的图像时可能生成多达 2880 个 Token,而文本输入通常少于 100 个 Token。这种不平衡导致计算负载主要由视觉模态主导,限制了模型在资源受限环境中的部署。
现有的视觉 Token 剪枝方法(如 FastV)虽然通过估计 Token 重要性来减少计算量,但存在一个根本性缺陷:一旦 Token 在特定层被剪枝,它们对所有后续层变得不可访问。这种不可逆的信息丢失可能导致模型在深层网络中丢失关键视觉信息,从而损害生成质量。
核心发现:层间注意力异质性
为了解释上述问题,作者通过实证研究观察了不同层级的视觉区域关注点。论文认为,不同的网络层级表现出不同的视觉区域聚焦,这意味着跨层级的最优 Token 子集是变化的。
作者以 FastV 算法为例进行了可视化分析,展示了不同层级对同一图像的关注差异。如图 1 所示,在处理一座桥梁的图片时:
- 第 2 层主要关注下方的桥梁结构。
- 第 10 层捕捉到桥梁名称的标牌。
- 第 20 层则集中在塔楼结构上。
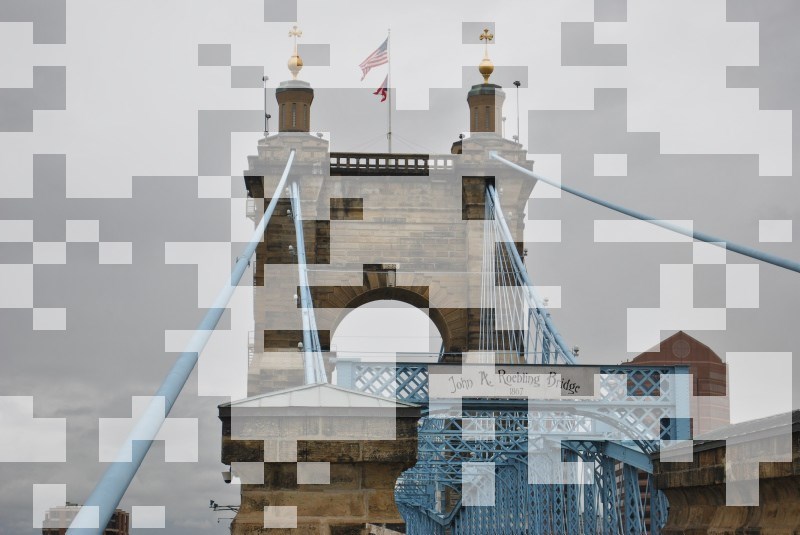
图 1 清晰地展示了 FastV 算法中层级化的视觉 Token 注意力模式。彩色区域表示重要 Token,灰色区域表示不重要 Token。这种跨层级的异质性表明,如果在单一层级进行静态剪枝,可能会丢弃在后续层级中至关重要的指令相关区域,导致预测错误。只有整合多个层级的重要视觉信息,模型才能生成准确的响应。
方法详解:ALVTS 框架
基于上述观察,作者提出了**自适应层级视觉 Token 选择(Adaptive Layer-wise Visual Token Selection, ALVTS)**框架。该方法打破了传统的静态 Token 剪枝范式,允许每个层级独立进行动态 Token 选择。
ALVTS 的核心机制包含以下几个部分:
- 轻量级 Token 选择器:在视觉 Token 进入解码器层之前,先经过选择器处理。选择器计算每个 Token 的重要性分数。
- 动态路由与跳过:
- 高分(重要)Token 参与当前层的计算。
- 低分(不重要)Token 直接跳过该层,避免不必要的操作。
- 无缝重集成:在解码器层输出后,处理过的 Token 与跳过的 Token 无缝合并,恢复完整的 Token 序列供下一层使用。
图 2 展示了 ALVTS 的整体架构。在每个 LLM 解码器层,轻量级 Token 选择器利用全注意力机制的低秩近似来计算重要性分数。重要 Token 参与计算,而次要 Token 跳过该层。两路 Token 在下一层之前重新整合,实现了跨模型的自适应压缩。
论文指出,该 Token 选择模块基于重要性一致性约束的低秩近似(importance consistency constrained low-rank approximation)。这一设计使得选择器能够紧密模拟全注意力机制的 Token 选择行为,有效捕捉其基本模式,且无需对模型进行重新训练,便于实际部署。
实验结果与对比
作者在 LLaVA-1.5、LLaVA-NeXT 和 Qwen2.5-VL 等主流 LVLM 架构上进行了广泛实验,以验证 ALVTS 的有效性。
定量结果
实验结果表明,ALVTS 在效率和准确性之间取得了良好的平衡:
- 压缩率:实现了 89% 的视觉 Token 压缩。
- 准确率保留:保留了原始模型 96.7% 的性能。
- 推理速度:实现了 1.6 倍的推理加速。
定性对比
为了直观展示不同方法的效果,论文对比了 FastV 和 ALVTS 的剪枝情况。如图 5 所示,灰色掩码表示被剪枝(跳过)的区域。
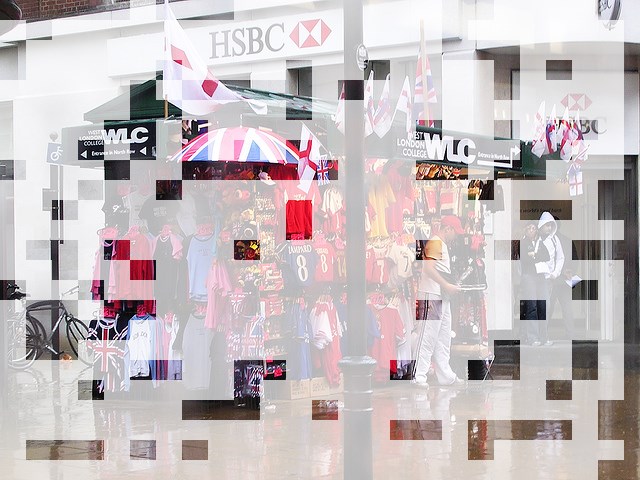
图 5 展示了 FastV 与 ALVTS 的案例对比。原始图像旁展示了其剪枝版本。可以看出,ALVTS 能够更灵活地保留不同层级所需的关键视觉信息,而 FastV 由于静态剪枝策略,可能在某些层级丢失了后续需要的细节。
总结与贡献
论文主要贡献总结如下:
- 揭示现有局限:指出了现有 Token 剪枝策略的根本缺陷,即特定层剪枝会导致后续层不可访问,造成不可逆的信息丢失。
- 提出 ALVTS 框架:引入了自适应层级视觉 Token 选择,而非使用全局固定的 Token 子集。这种方法消除了冗余计算,同时通过模型全程保留必要的视觉语义。
- 高效选择器设计:开发了一种高效的低秩 Token 选择器,在不需重新训练模型的情况下保持了与全注意力机制的高保真度。
- 全面评估:跨多种 LVLM 和基准测试的综合评估证明,ALVTS 实现了优越的效率 - 准确性权衡。
通过“一层的垃圾可能是另一层的宝藏”这一核心洞察,ALVTS 为 LVLM 的高效推理提供了一种新的解决方案,有效缓解了视觉 Token 带来的计算瓶颈。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。