Multi-Agent Reinforcement Learning from Delayed Marketplace Feedback for Objective-Weight Adaptation in Three-Sided Dispatch
作者:Haochen Wu, Yi Hou, Shiguang Xie
作者提出一种部署在 DoorDash 的强化学习系统,利用延迟市场反馈自适应调整调度目标权重。不同于替换组合分配优化器,商店级策略选择离散乘数以调整配送质量与批量效率之间的权衡。
论文信息摘要
论文要解决什么
在三边市场配送中,决策需平衡批量效率与配送速度,且面临延迟、噪声及耦合的反馈信号。静态启发式权重难以适应局部时变条件,导致效率或质量受损。
论文方法概览
- Backbone: 离线 Double DQN
- 关键模块: 商店级策略代理(选择目标权重乘数)
- 损失函数: Double Q-learning 目标 + 保守正则化项(CQL)
读后要点
个人理解,欢迎指正
论文实验表明,离线训练的策略在生产切换实验中增加了批量配送并降低了骑手时间成本,同时未损害客户配送质量。验证了利用真实系统世界反馈安全适应决策策略的可行性。
局限与疑问
依赖特定平台的历史日志数据,离线训练存在分布外价值高估风险(虽通过正则化缓解),方法通用性需在其他物流场景验证。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.13604v1。
arXiv 阅读笔记:Multi-Agent Reinforcement Learning from Delayed Marketplace Feedback for Objective-Weight Adaptation in Three-Sided Dispatch
1. 论文概览
本文介绍了一个部署在 DoorDash 大规模食品配送市场中的强化学习(RL)系统。该系统利用延迟的市场反馈信号,自适应地调整调度目标权重。作者提出了一种不同于直接替换组合分配优化器的方法:通过一个学习到的商店级策略(store-level policy),选择一个离散乘数来调整优化器在“配送质量”与“批量效率”之间的权衡。
论文的核心贡献在于展示了如何利用真实经济和物流系统中的世界反馈(world feedback),在保持生产可行性和操作安全的前提下,安全地在线适应决策策略。通过生产环境的切换实验(switchback experiment),离线训练的策略在提高批量配送率和降低骑手侧时间成本的同时,未损害面向客户的配送质量。
2. 核心问题与动机
在食品配送的三边市场(顾客、商家、骑手)中,调度是一个嵌入在复杂环境中的序贯决策问题。每一次决策都会影响顾客配送质量、商家拥堵程度、骑手可用性、批量机会以及成本效益。
主要挑战:
- 延迟反馈: 决策的效果不是立即评估的,而是通过延迟的操作结果(如配送速度、骑手利用率、商家拥堵)来评估。
- 多目标权衡: 批量配送(batching)可以提高骑手效率,但快速执行可以减少延迟并改善客户体验。生产环境中,这种权衡通常由静态启发式权重控制,这些权重通常是全局调整且手动更新的,在面对局部、时变的条件时显得脆弱。
- 耦合反馈: 调度决策共同影响客户质量、商家拥堵和骑手利用率,反馈是耦合的。
解决方案思路: 作者没有试图用 RL 直接替换现有的组合分配优化器,而是让 RL 代理控制一个狭窄的目标权重接口。每个调度周期,商店级 RL 代理观察本地市场状态,选择一个应用于优化器目标的离散乘数。这种受限的动作空间保留了现有的优化和操作保障措施,同时实现了本地适应。
3. 方法设计
3.1 系统架构
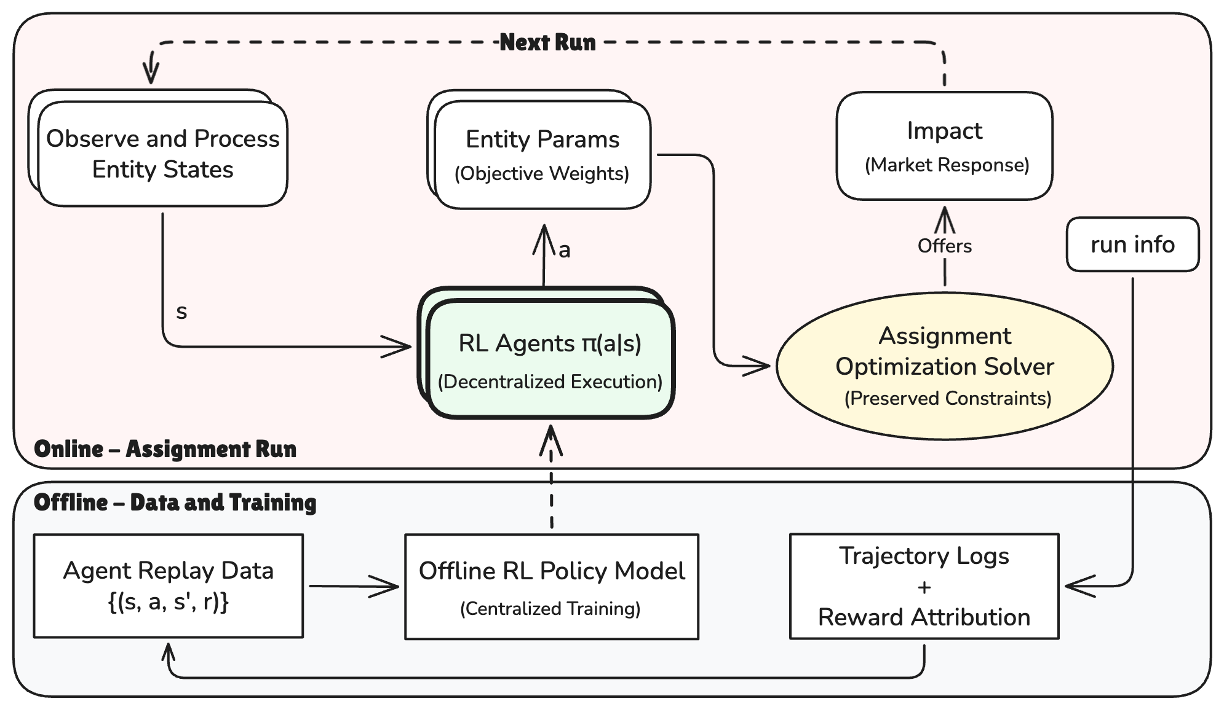
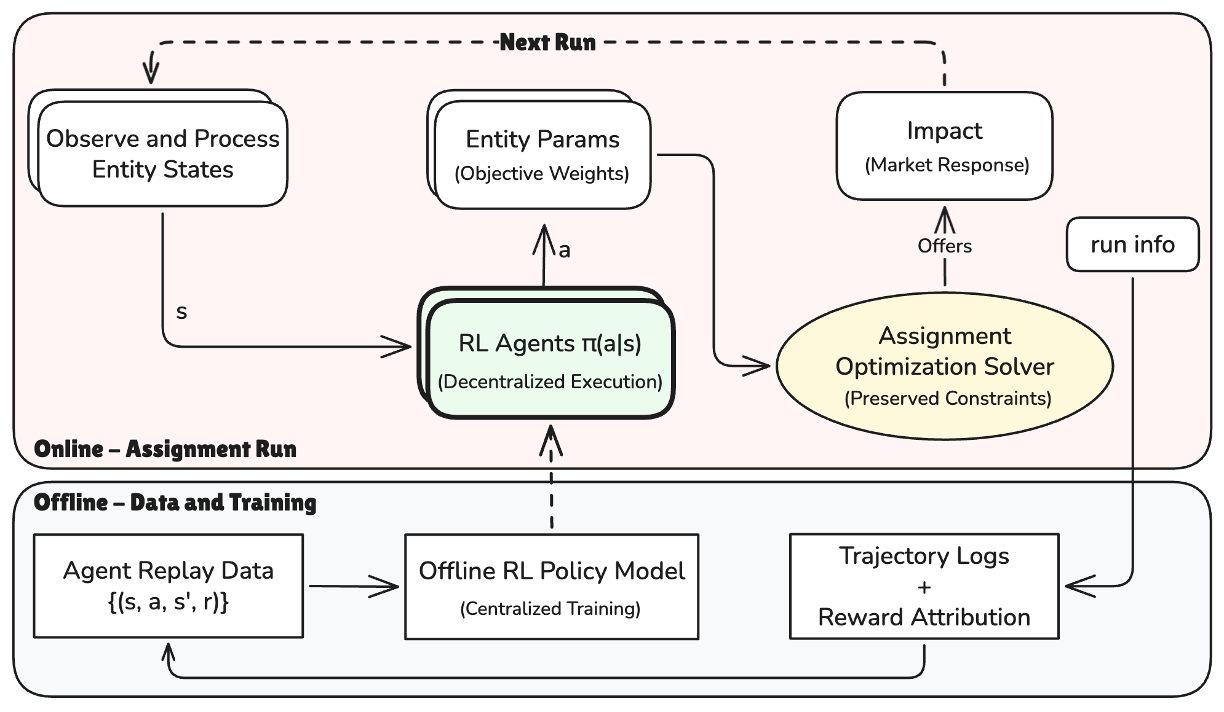
论文提出的系统包含两个嵌套的决策层。内层是优化器(optimizer),负责将订单、骑手、约束和目标权重映射为骑手 - 订单分配。外层是目标权重适应代理(OWA-RL),它从市场结果中学习,并在优化前选择商店级目标权重乘数。
如图 1 所示,展示了生产调度的代理目标权重适应循环。在线服务期间,策略代理观察本地状态并选择一个目标权重乘数,该乘数参数化了分配优化器。优化器仍然负责可行的骑手 - 订单分配决策。在离线学习期间,日志记录的运行与延迟的市场结果相结合,构建用于策略训练和部署的转换数据元组。
3.2 问题形式化
作者将外层适应问题形式化为一个集中式离线训练的分散式多智能体马尔可夫决策过程(MDP)。
- 动作(Action): 动作空间 。这是一个对基准 ASAP 权重的离散乘数。商店 选择 ,产生适应后的权重 。
- 较低的权重使批量或更高效的路线在优化中更具吸引力。
- 较高的权重强调更快的订单完成,可能导致优化器将附近的订单分配给不同的骑手而不是批量处理。
- 中性动作 恢复静态生产基线。
- 状态(State): 商店级状态 ,每个分配运行刷新一次。
- :未完成的配送数量。
- :中位骑手等待时间。
- :本地化供应压力特征。为了暴露被区域供应信号掩盖的商店级变化,作者通过有效骑手供应对区域特征进行重新缩放。
- 奖励(Reward): 奖励从延迟的配送结果计算,并聚合到区域级别,以捕捉附近商店和骑手之间的网络效应。
3.3 奖励设计与延迟归因
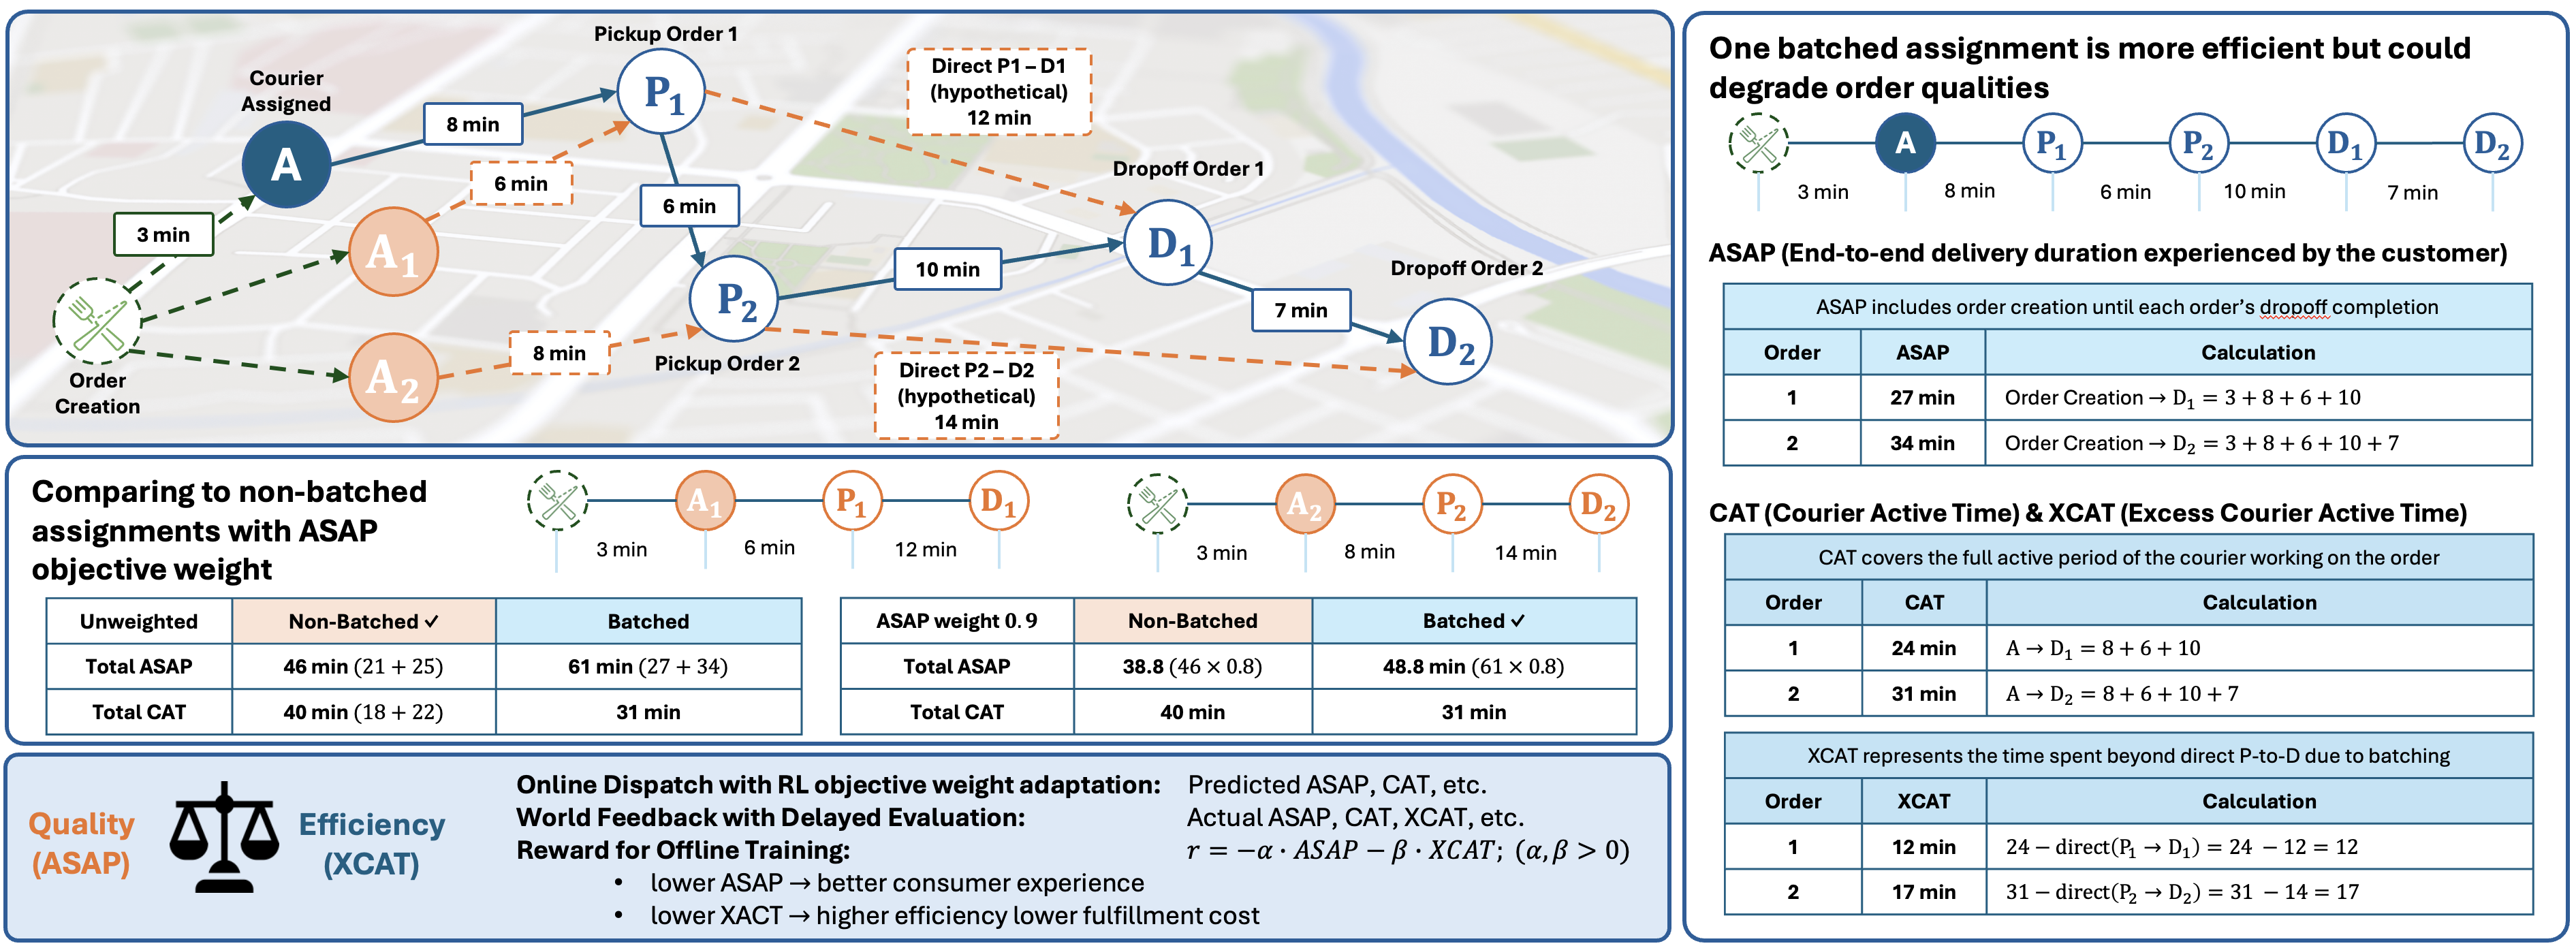
奖励构建依赖于物流时间组件。如图 2 所示,ASAP 衡量面向客户的配送持续时间,XCAT 衡量超出直接路线的多余骑手活动时间(CAT)。
具体定义如下:
- (配送完成时间 - 订单创建时间)
- (配送完成时间 - 骑手接受时间)
- (多余骑手时间 - 单独服务的直接取送时间)
区域奖励 定义为该区域在决策周期 归因的配送集合的平均负加权和: 其中 ASAP 捕捉客户侧延迟,XCAT 捕捉骑手侧的额外努力,区域聚合捕捉网络效应。
3.4 离线训练算法
策略 是共享的商店级策略。商店独立使用本地状态执行政策,而训练池跨商店汇集经验,并使用区域奖励捕捉跨商店网络效应。
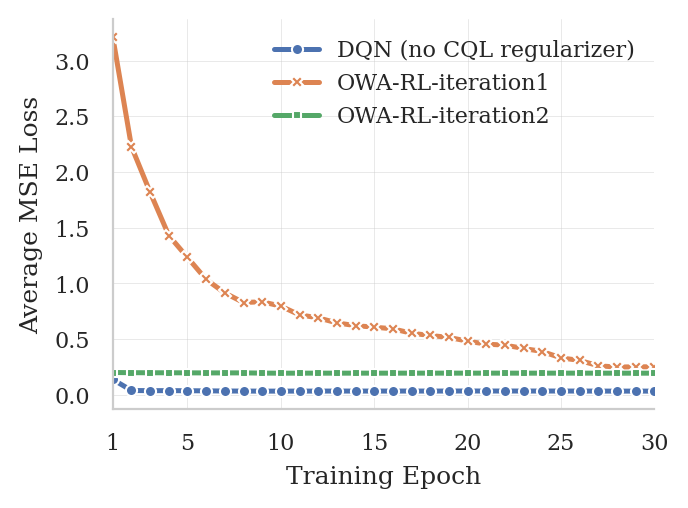
作者使用离线 Double DQN 目标训练离散动作价值函数 。为了减少分布外(out-of-distribution)价值的高估,作者添加了一个离散保守 Q 学习(Conservative Q-Learning, CQL)正则化项。
最终训练目标为: 其中 Double DQN 减少最大化偏差,保守惩罚阻止不受支持的动作获得高价值,从而提高部署前的离线训练稳定性。
4. 实验与结果
4.1 实验设置
作者在部署前使用离线奖励重加权诊断来测试学习到的策略是否对不同定义的市场反馈做出方向性响应。选择 以产生更平衡的动作分布,避免向激进批量或速度优先崩溃。
评估采用全局切换实验(global switchback experiment),将 OWA-RL 与 DoorDash 生产基线进行对比。随机化单元约为 4,000 个地理区域。
4.2 策略行为分析
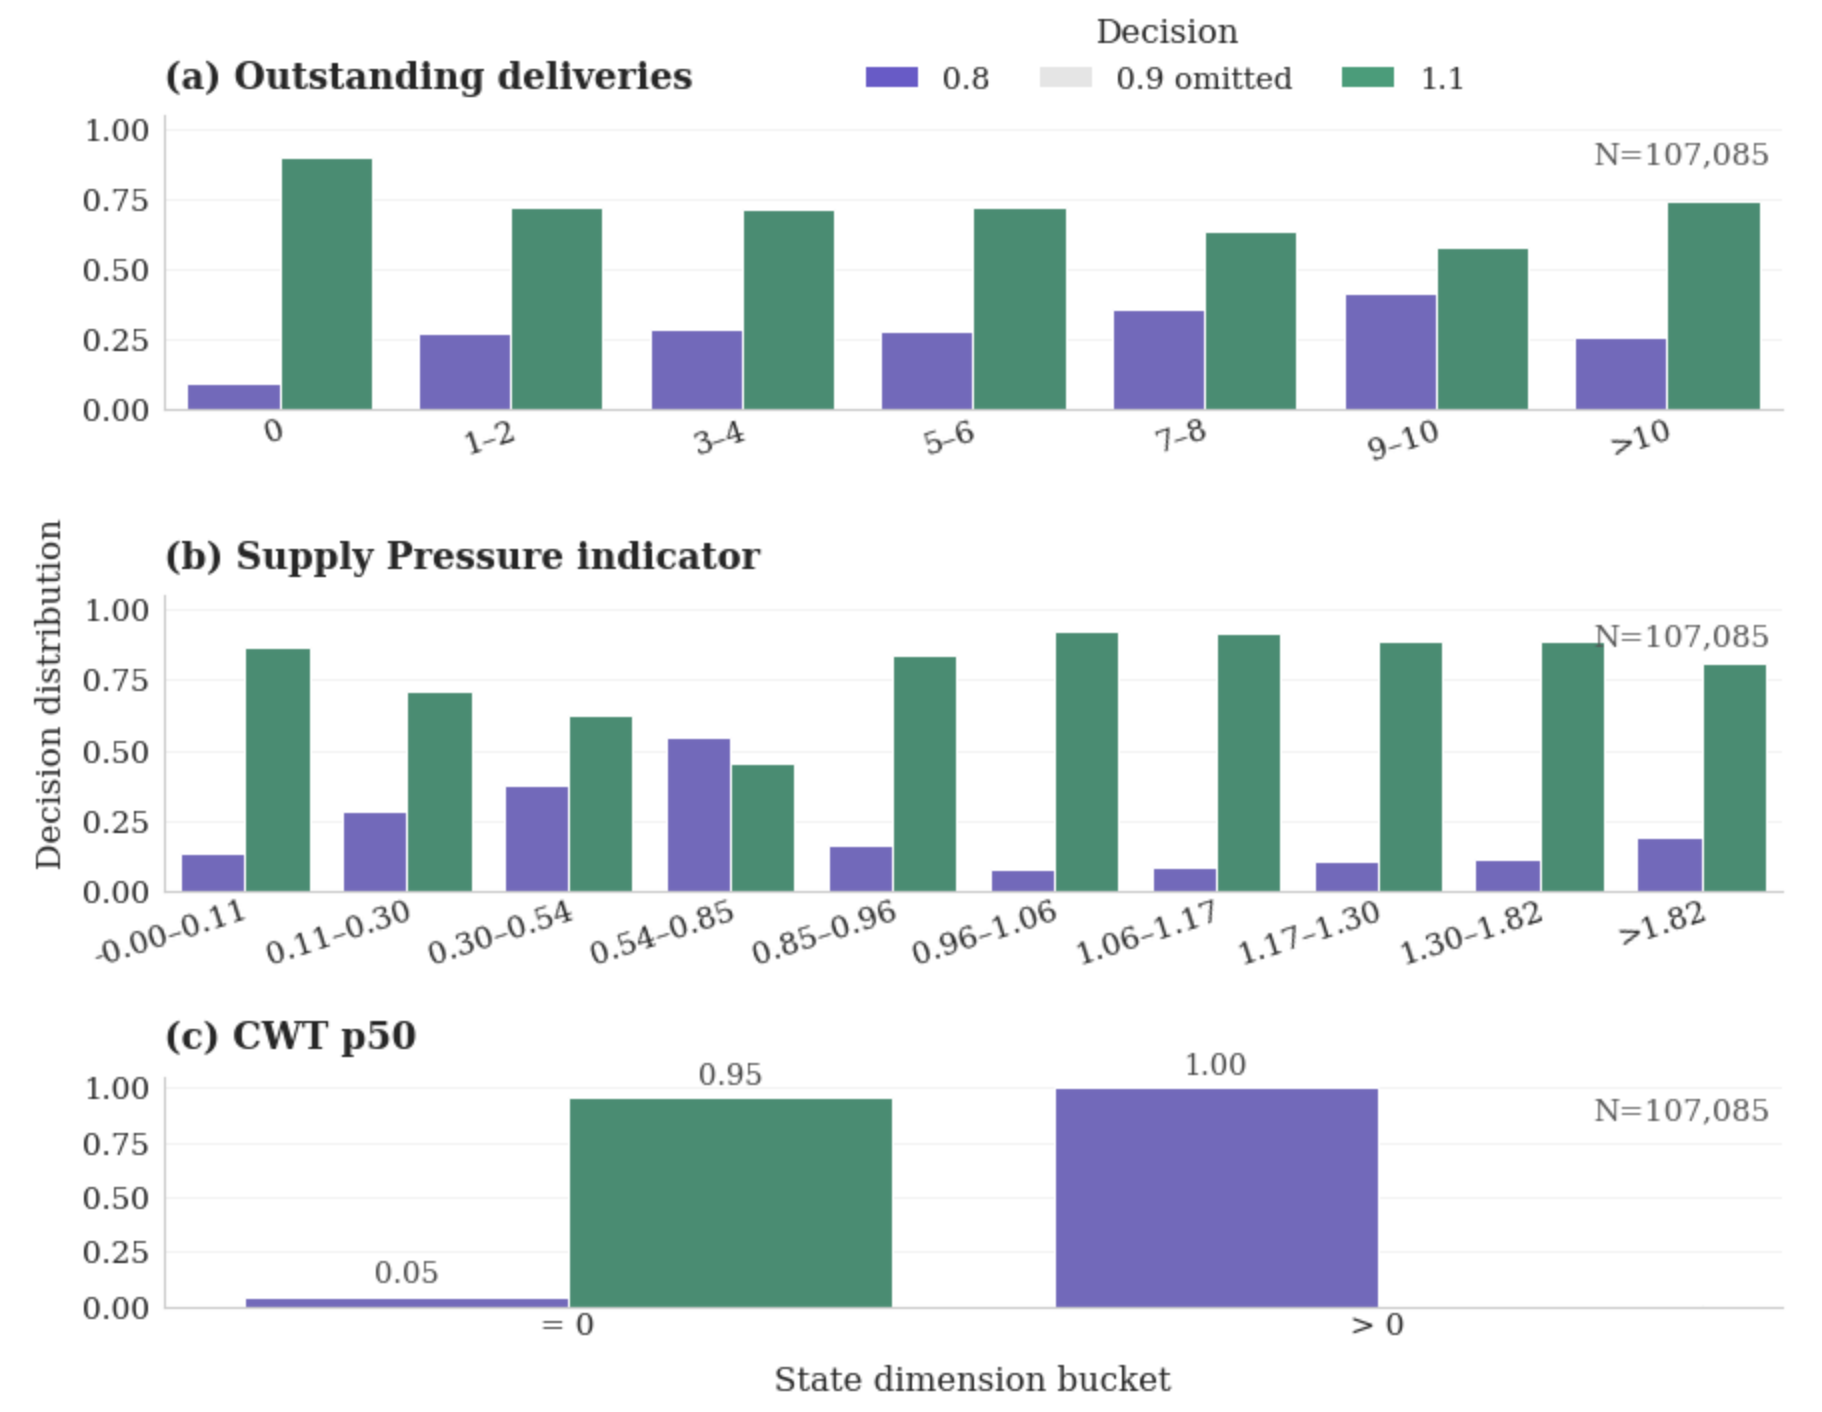
论文展示了策略在不同奖励权重设置下的预测动作分布。如图 5 所示,改变奖励权重会改变所选动作的分布,验证了策略对反馈信号的敏感性。
此外,图 3 展示了策略如何在不同条件下移动概率质量。这表明策略能够根据市场状态动态调整策略,而不是固定选择某个动作。
4.3 生产部署效果
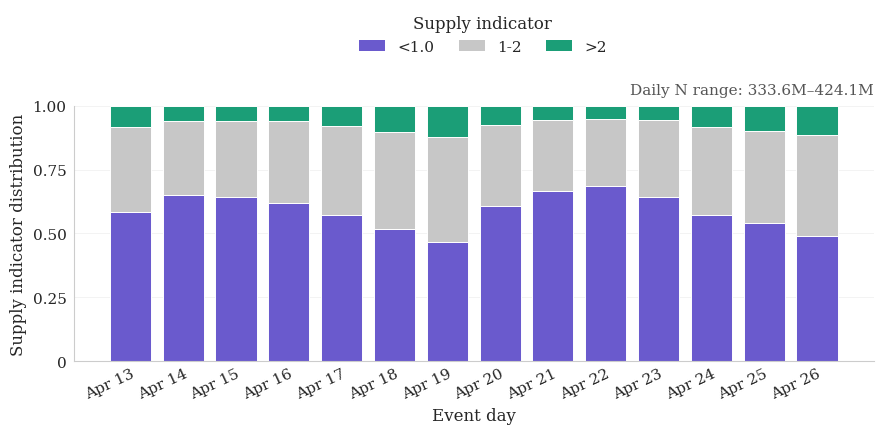
在生产环境中,系统每天进行数亿次推理,周期为 20 秒。图 6 展示了所选 ASAP 权重乘数的每日分布。结果显示,策略在实际运行中能够根据实时情况选择不同于基线(1.0)的乘数,从而动态调整调度行为。
主要结果:
- 批量增加: 离线训练的策略增加了批量配送(batching)。
- 成本降低: 减少了骑手侧的时间成本(courier-side time costs)。
- 质量保持: 未损害面向客户的配送质量(customer-facing delivery quality)。
5. 总结
本文提出了一种在真实三边市场环境中利用延迟反馈进行多智能体强化学习的方法。作者的主要贡献包括:
- 引入了一种 RL 架构,通过低维控制接口适应调度目标权重,而不是替换生产分配优化器。
- 将目标权重适应形式化为具有商店级分散执行和延迟区域奖励的离线多智能体决策问题。
- 提供了生产切换证据,证明该方法可以在不降低客户体验的前提下提高运营效率。
这项工作展示了如何安全地利用来自活跃经济和物流系统的世界反馈来在线适应决策策略,为工业界大规模部署强化学习提供了有价值的参考。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。