Functional Cache Grafting: Robust and Rapid Code-Policy Synthesis for Embodied Agents
作者:Saehun Chun, Wonje Choi, Sera Choi, Sanghyun Ahn, Honguk Woo
作者提出 FCGraft 框架,通过维护函数级验证代码骨架及其关联的 Transformer KV 缓存库,利用检索与嫁接机制合成新策略。该方法通过缓存缝合消除冗余预填充计算,并通过缓存修补局部适应任务参数,从而减少生成延迟并提升鲁棒性。
论文信息摘要
论文要解决什么
开放域具身环境中,基于 CodeLLM 的策略生成面临两大限制:一是长提示词导致的重复预填充计算引起解码延迟,二是全生成式解码易产生 API 不匹配、缺少安全保护及控制逻辑不稳定等问题。
论文方法概览
- Backbone: Code-writing Large Language Models (CodeLLMs)
- 关键模块: Functional Cache Grafting (FCGraft), 包含 Cache-Stitching 与 Cache-Patching
- 损失函数: N/A (基于现有模型推理优化)
读后要点
个人理解,欢迎指正
实验表明,函数级缓存嫁接相比提示级缓存方法(如 RAGCache)能显著提升任务成功率(高 18.31%)并加快策略合成速度(快 2.3 倍),证明了复用验证控制结构的有效性。
局限与疑问
缓存库的覆盖范围可能限制对全新任务的泛化能力,且 KV 缓存嫁接在极端动态环境下的长期稳定性有待进一步验证。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.13097v1。
论文阅读笔记:Functional Cache Grafting: Robust and Rapid Code-Policy Synthesis for Embodied Agents
1. 研究背景与问题定义
随着具身智能(Embodied Agents)的发展,利用大型语言模型(LLM)生成可执行代码策略(Code-as-Policies, CaP)已成为一种新兴范式。Code-writing LLMs(CodeLLMs)能够将自然语言目标和环境约束转化为结构化控制程序。然而,论文指出,在开放域具身环境中进行策略生成时,现有的 CaP 方法面临两个根本性限制:
- 延迟解码问题:由于长提示词(Long Prompts)导致的重复预填充(Prefill)计算,使得解码过程延迟,影响了时间关键场景下的响应速度。
- 鲁棒性不足:完全生成式解码(Fully Generative Decoding)容易产生 API 不匹配、缺少安全保护以及控制逻辑不稳定等问题,直接导致任务失败。
论文认为,现有的基于记忆的方法主要操作在文本层面,计算效率提升有限;而现有的 KV 缓存工作不支持函数级别的适应,难以应对开放域环境的动态变化。为了解决这些问题,作者提出了 FCGraft(Functional Cache Grafting)框架。
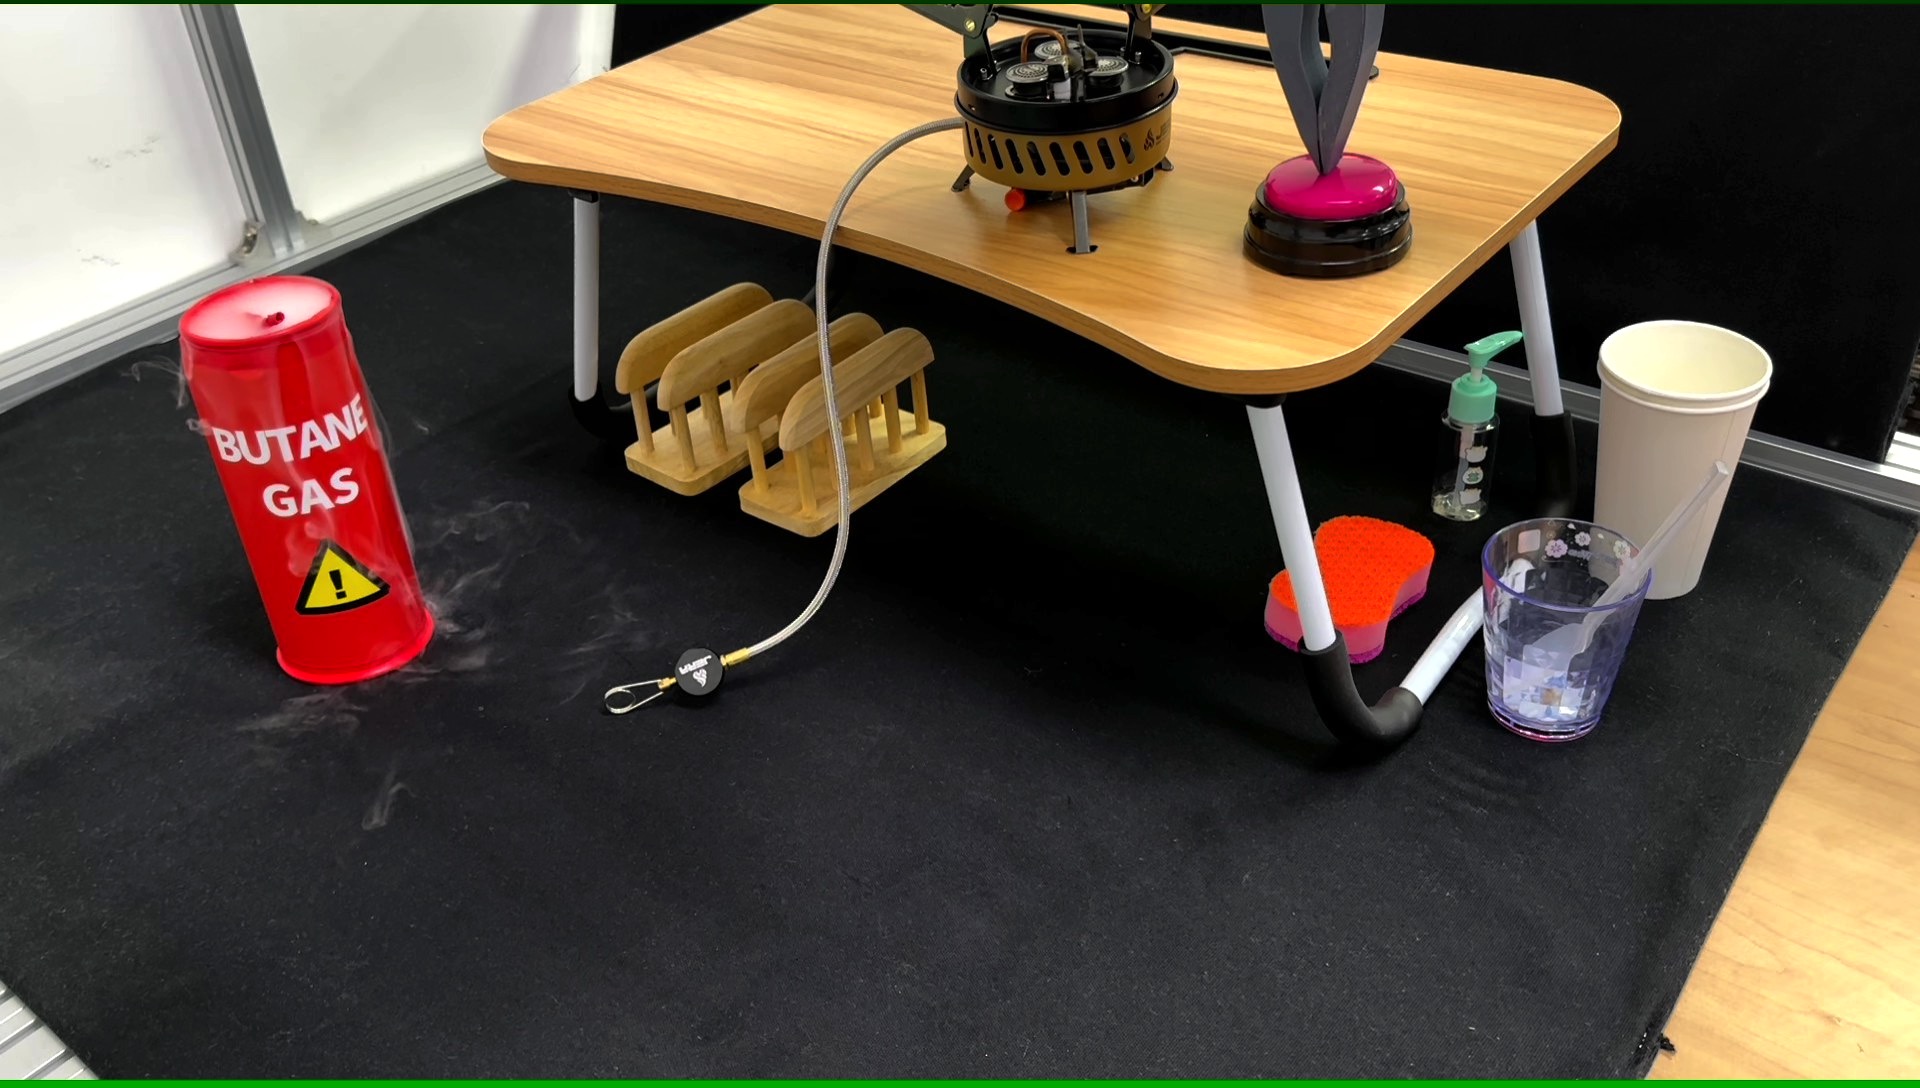
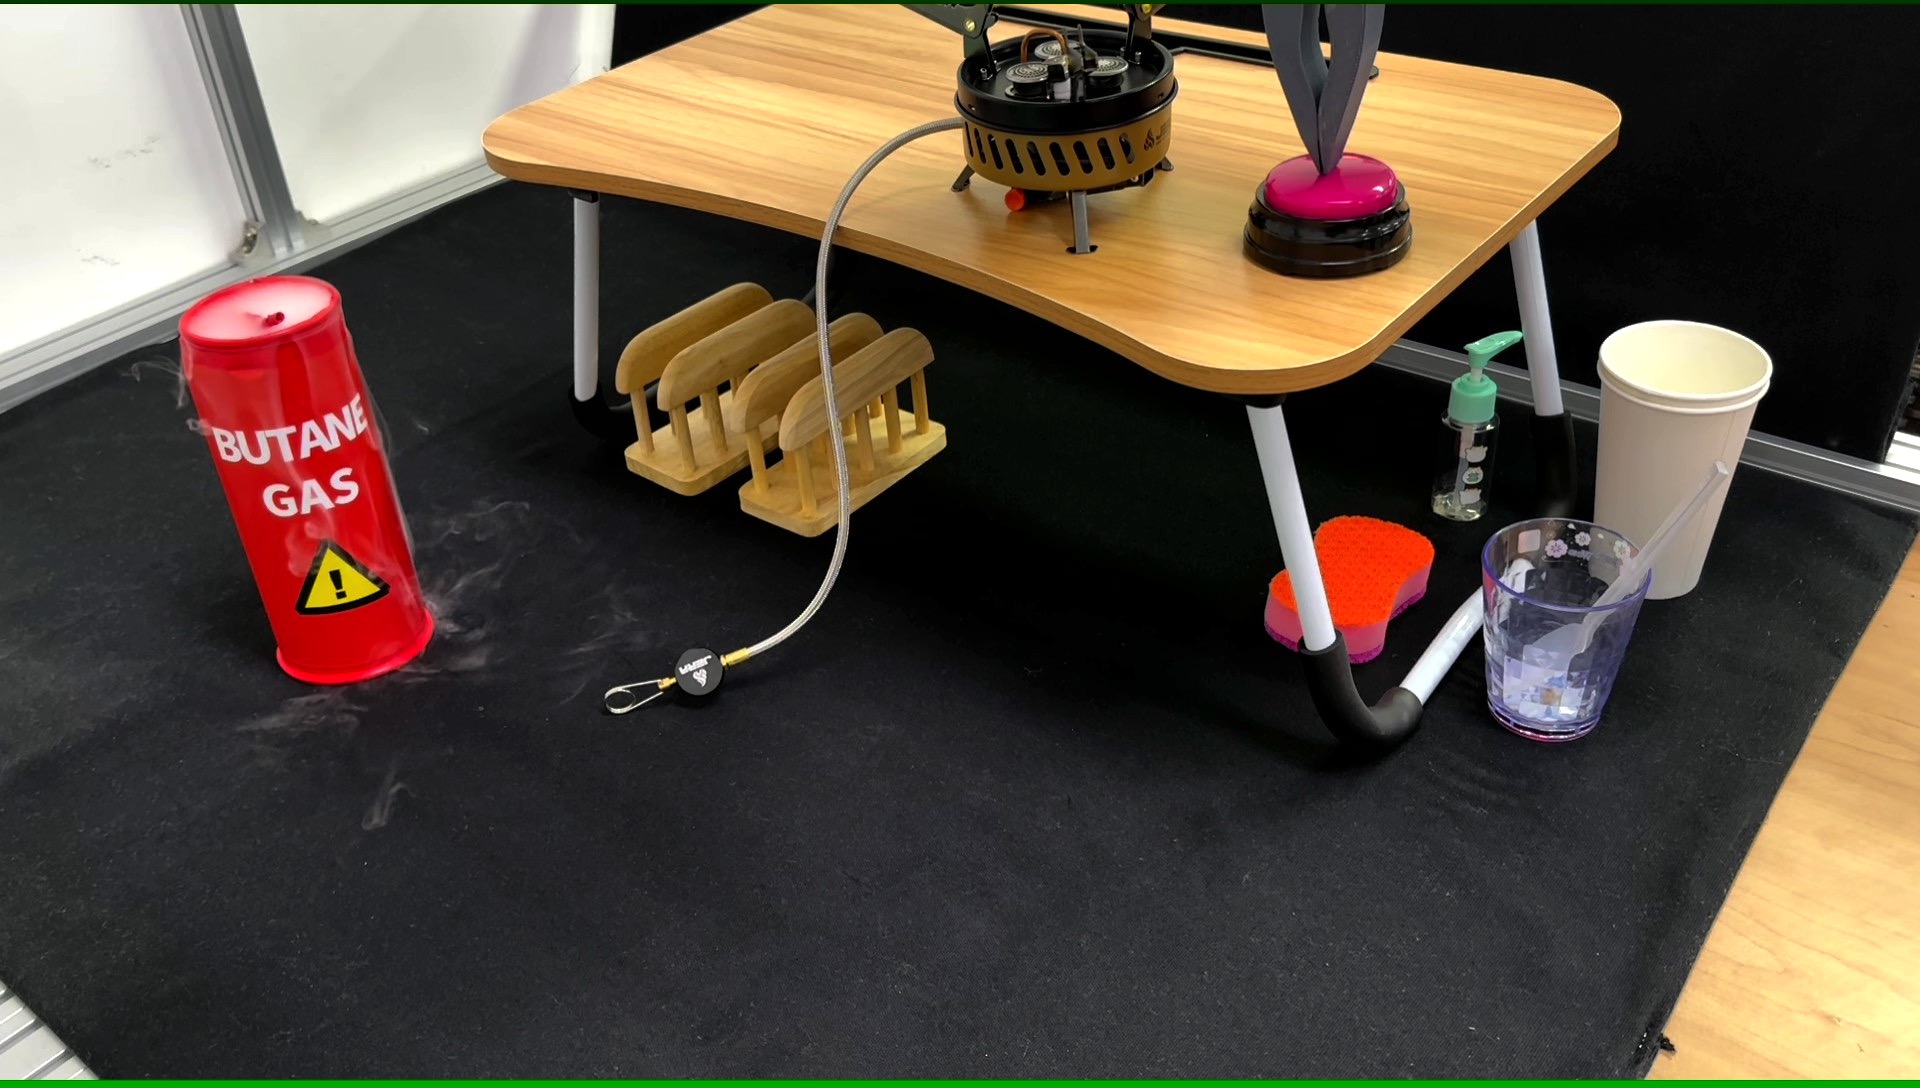
如图 1 所示,论文对比了传统 CaP 方法与 FCGraft 在开放域场景(如气体管理)中的表现。传统方法需要为每个指令从头生成完整控制代码,导致高延迟和低鲁棒性(例如延迟响应导致气体泄漏)。而 FCGraft 通过缓存嫁接(Cache Grafting)消除了冗余预填充,并重用了经过验证的控制结构,实现了快速且稳健的策略合成。
2. 核心方法:FCGraft 框架
作者提出的 FCGraft 框架旨在通过函数级别的 KV 缓存来增强基于 CodeLLM 的机器人编程。其核心思想是复用先前的构建模块,类似于机器人中的基于技能(Skill-based)范式,但侧重于通过复用和组合缓存的 KV 状态来实现高效的策略构建。
2.1 函数级 KV 缓存库
FCGraft 维护了一个包含函数级验证代码骨架及其关联的提示级 Transformer 键值(KV)缓存的库。当新任务提供时,系统检索相关函数并嫁接其 KV 缓存以合成新策略。该缓存采用双层结构:提供轻量级引用并保留完整实现。
2.2 缓存嫁接机制
基于检索到的函数缓存,FCGraft 执行缓存嫁接,主要包含两个相互依赖的阶段:
- 缓存缝合(Cache-Stitching):通过 KV 状态直接组合函数调用。这一步消除了冗余的预填充计算,并通过重用经过验证的控制结构和 API 调用模式来确保鲁棒性。
- 缓存修补(Cache-Patching):局部定位错误跨度并仅生成修正部分。与完全重新生成相比,这大大减少了解码时间,仅对满足任务特定参数和约束的必要代码区域进行局部适应。
图 2 展示了 FCGraft 的整体架构。顶部展示了端到端的机器人编程工作流,底部详细描述了函数级 KV 缓存的过程。该架构表明,FCGraft 利用原生 KV 缓存机制实现了函数级代码复用,形成了缓存嫁接代码策略合成的基础。
3. 实验设置与评估结果
为了验证 FCGraft 的有效性,作者在多样化的开放域场景下进行了评估,包括具身基准测试(ALFRED, TEACh, RLBench)以及真实世界的机器人操作任务。
3.1 实验环境与任务
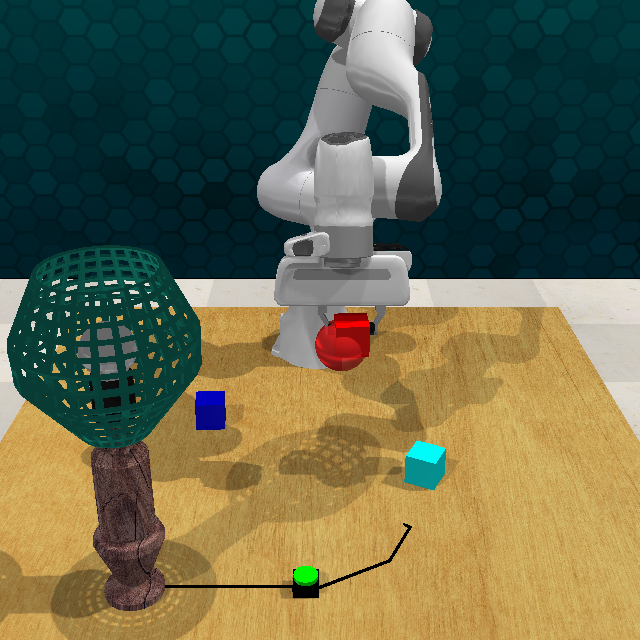
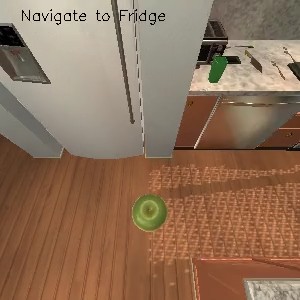
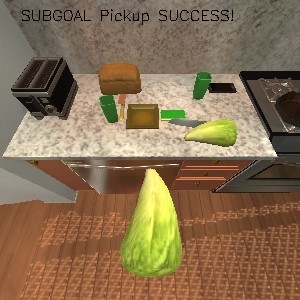
论文使用了多个基准环境来测试系统的泛化能力。图 4 展示了 RLBench 的环境示例集。此外,实验涵盖了四种场景类型(厨房、客厅、卧室、浴室),如图 5 所示,以及四种任务类型(切片、清洁、拿起、煮沸),如图 6 所示。
3.2 性能对比
实验结果表明,FCGraft 在鲁棒性和延迟之间取得了优于 RAGCache 的权衡。具体数据如下:
- 任务成功率:比 RAGCache 提高了 18.31%。
- 策略合成延迟:平均减少了 2.3 倍(即速度快 2.3 倍)。
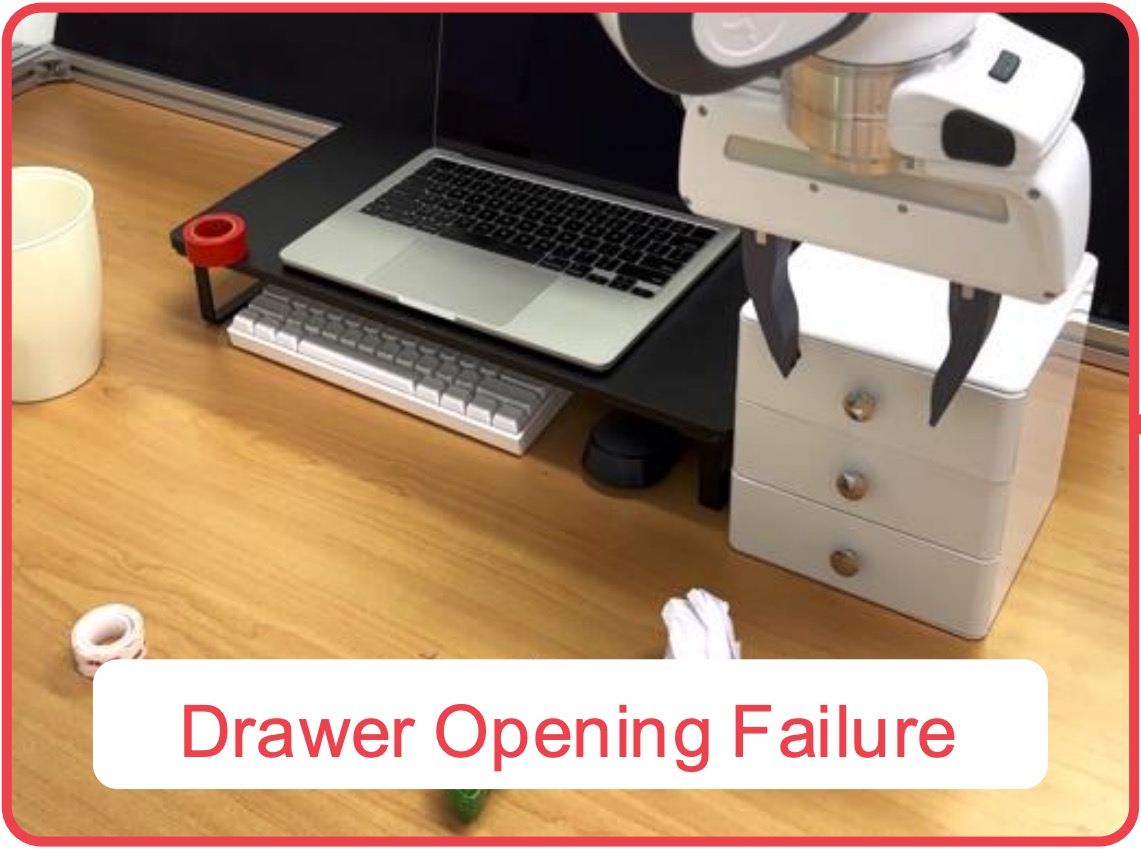
图 3 展示了 FCGraft 在真实世界机器人操作中的定性示例,进一步证明了其在实际部署中的有效性。通过消除冗余计算并重用验证过的控制结构,FCGraft 能够交付快速、可靠且一致的策略合成。
4. 总结与贡献
本文主要贡献总结如下:
- 提出了 FCGraft 框架:通过函数级 KV 缓存改进了基于 CodeLLM 的机器人编程,在减少冗余预填充的同时实现了开放域环境中的行为一致性。
- 引入了缓存缝合与修补机制:将两者作为相互依赖的机制,缝合用于消除结构错误和减少预填充,修补用于以最小解码量纠正局部错误。
- 验证了最佳权衡:展示了 FCGraft 在多样化开放域场景(包括真实世界机器人操作)中实现了鲁棒性与延迟的最佳权衡。
论文认为,确保稳健的代码生成同时最小化冗余计算对于实际 CaP 部署至关重要。FCGraft 通过复用验证过的代码骨架和 KV 缓存,为解决具身智能体在动态环境中的响应速度和可靠性问题提供了新的思路。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。