MLUBench: A Benchmark for Lifelong Unlearning Evaluation in MLLMs
作者:He Li, Haoang Chi, Qizhou Wang, Yunxin Mao, Zhiheng Zhang
作者提出了 MLUBench,这是一个包含 127 个实体和 9 个类别的大规模基准,用于评估多模态大模型(MLLM)的终身遗忘能力。同时提出了 LUMoE 方法,利用混合专家机制缓解连续遗忘导致的性能累积退化。
论文信息摘要
论文要解决什么
解决多模态大模型在面临随时间顺序到达的遗忘请求时,如何持续移除特定内容同时保持通用能力和多模态对齐的问题。
论文方法概览
- Backbone: MLLM
- 关键模块: LUMoE (Gate Module + Switchable LoRA Experts)
- 损失函数: 未明确详述
读后要点
个人理解,欢迎指正
实验表明现有遗忘方法在终身场景下存在严重的累积性能退化。多模态对齐是 MLLM 终身遗忘区别于单模态模型的关键约束,单一模态的遗忘可能破坏整体模型。
局限与疑问
论文未详细讨论 LUMoE 在极长遗忘序列下的专家模块扩展性,且基准构建依赖特定实体提取模板,泛化性待验证。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.12809v1。
MLUBench: 多模态大模型终身遗忘评估基准深度解读
1. 研究背景与问题定义
随着多模态大语言模型(MLLMs)在各类应用中展现出卓越的多模态推理能力,这些模型通常基于海量多模态数据训练而成,引发了关于数据隐私和版权的担忧。因此,机器遗忘(Machine Unlearning)——即从训练好的模型中移除特定数据——变得至关重要。
论文指出,在现实场景中,遗忘请求往往不是同时到达的,而是随时间顺序陆续提交。这种实际设置引出了**MLLM 终身遗忘(MLLM Lifelong Unlearning)**这一具有挑战性的问题。在此场景下,MLLM 必须持续遗忘多模态信息,同时保留其通用能力。
如图 1 所示,该过程要求模型在面对一系列顺序遗忘任务时,既要忘记指定知识集中的信息,又要保留其他信息。然而,现有的遗忘方法在面对这种连续操作时,往往会导致模型性能的累积性下降。
2. MLUBench 基准测试介绍
为了填补现有评估基准在规模和范围上的不足,作者提出了 MLUBench,这是一个专为评估 MLLM 终身遗忘而设计的大规模、多样化基准。
2.1 基准构成
MLUBench 包含以下核心要素:
- 实体规模:涵盖 127 个广泛认知的现实世界实体。
- 类别分布:跨越 9 个不同的类别,确保数据的多样性。
- 数据量:包含 5,105 张关联图像和 15,414 个视觉问答(VQA)对。
该基准将这些实体组织成一系列遗忘任务,为评估遗忘算法的长期性能提供了综合平台。图 2 展示了 MLUBench 的整体概览,清晰地呈现了实体类别与数据构成的关系。
2.2 数据构建
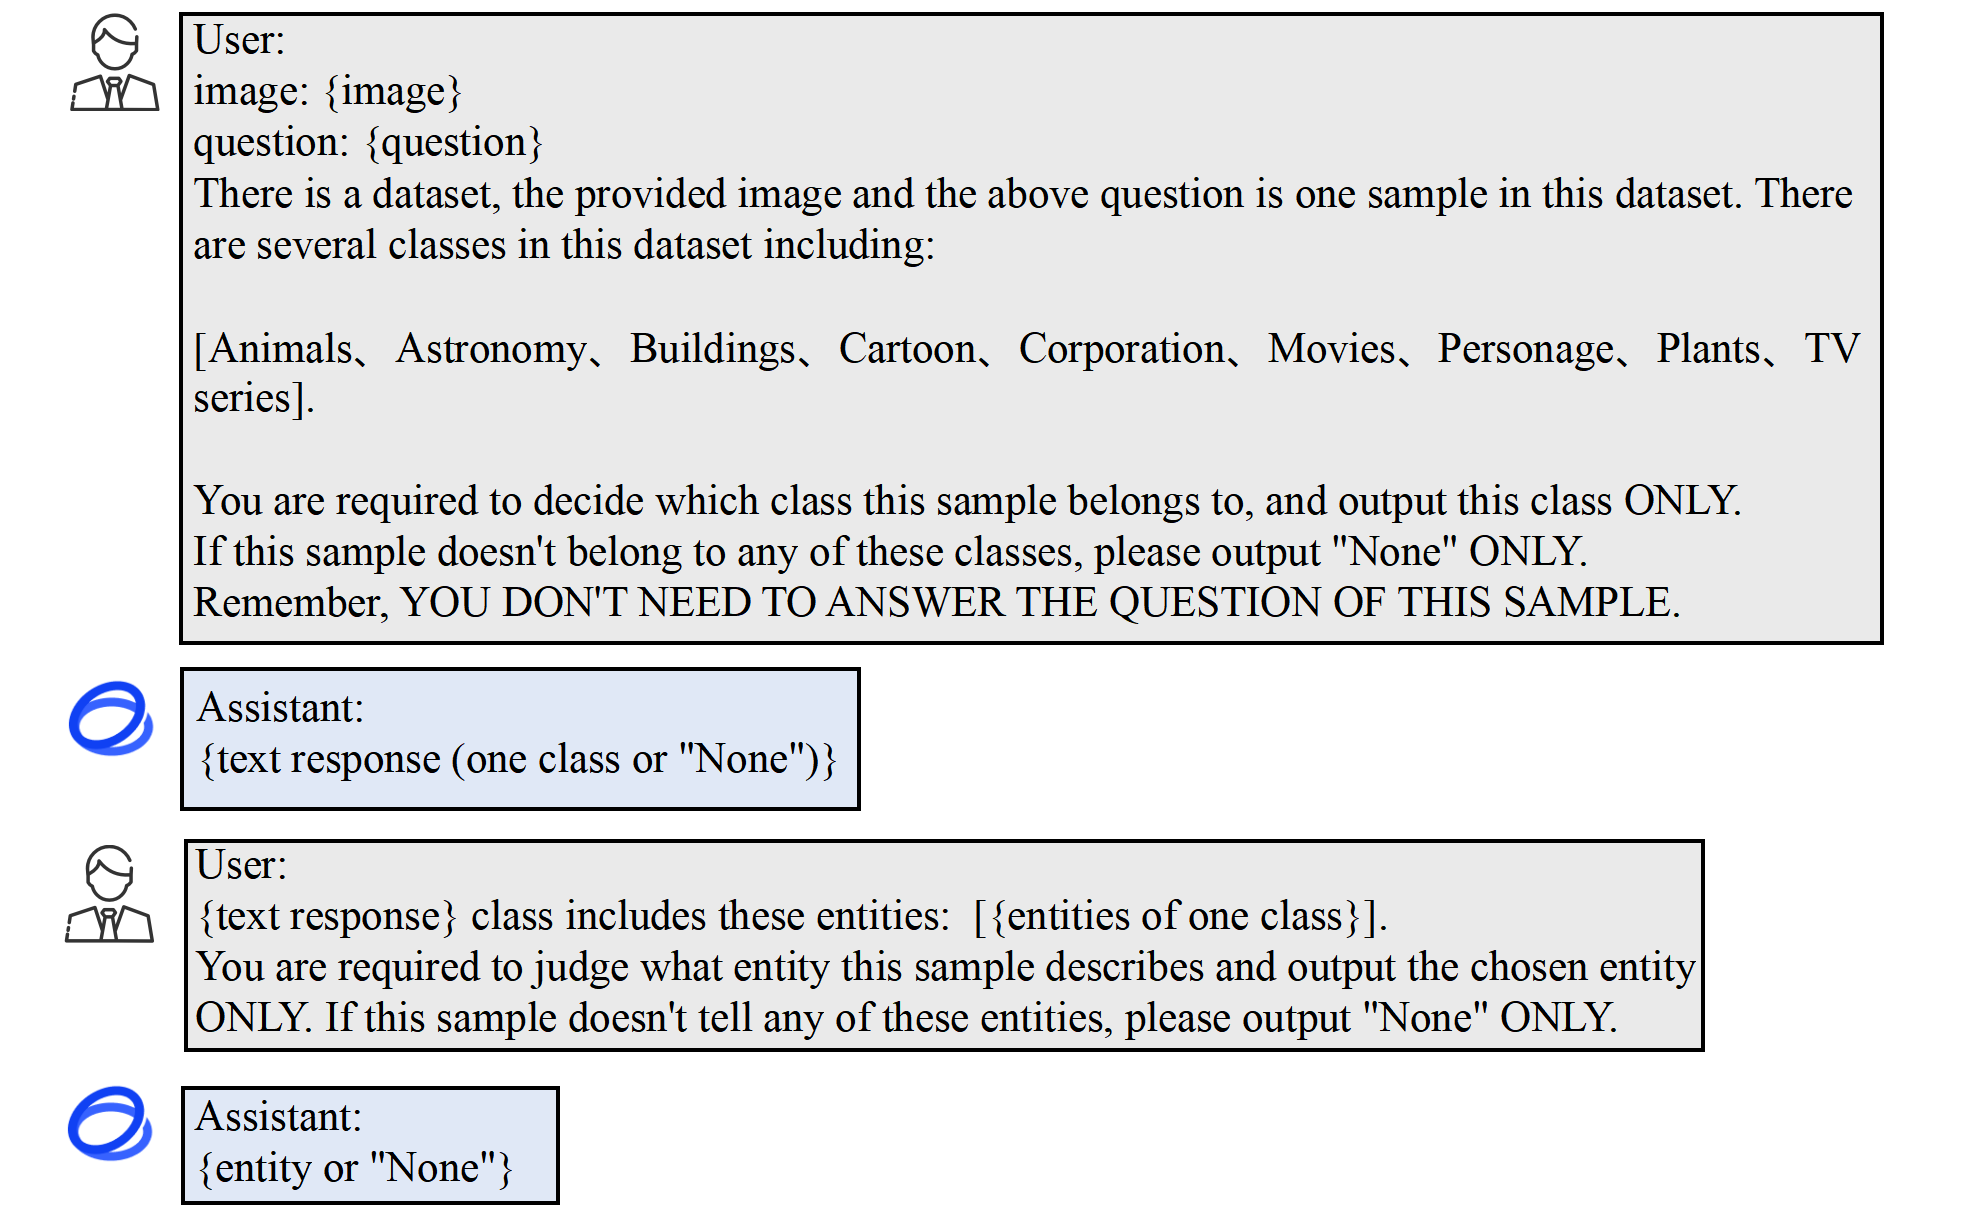
在构建基准的过程中,作者采用了特定的提示模板来提取实体信息。图 3 展示了用于实体提取的提示模板(Prompt template),这有助于确保基准中数据的准确性和一致性。
3. 核心发现与挑战
利用 MLUBench,作者对现有的遗忘方法进行了广泛评估,并揭示了两个关键发现:
3.1 严重的累积性能退化
论文认为,终身遗忘会导致遗忘质量和模型效用出现严重的累积性能下降。例如,GA 方法在第一个任务上的遗忘质量从 0.38 下降到后续遗忘操作后的 0.01。这表明现有的方法难以应对连续的遗忘请求。
3.2 多模态对齐的独特挑战
论文进一步指出,与单模态模型不同,MLLM 终身遗忘面临一个根本性的约束:必须保持多模态对齐。作者通过实验证明,即使遗忘操作仅应用于单一模态,也可能灾难性地破坏这种对齐,导致模型性能崩溃。这是 MLLM 终身遗忘区别于单模态遗忘的独特挑战。
4. 提出的方法:LUMoE
为了解决上述挑战,作者提出了一种名为 LUMoE(Lifelong Unlearning with Mixture-of-Experts)的有效方法。
4.1 方法原理
LUMoE 受到混合专家模型(MoE)的启发,其核心思想是不再持续改变 MLLM 的权重,而是采用可切换的低秩适配(LoRA)适配器作为特定遗忘任务的“专家”。
4.2 工作机制
该方法包含一个强大的门控模块(Gate Module),负责将输入引导至适当的适配器,从而有效地处理遗忘请求。这种设计旨在缓解现有基线方法面临的退化问题。
5. 总结
本文主要贡献总结如下:
- 问题定义:研究了 MLLM 终身遗忘这一实际且具有挑战性的问题,并指出保持多模态对齐是该问题的独特挑战。
- 基准构建:引入了 MLUBench,这是一个包含 127 个实体、9 个类别的大规模基准,用于评估 MLLM 终身遗忘。
- 实验与方法:通过实验揭示了现有方法的性能退化问题,并设计了 LUMoE 方法,为该领域的未来研究建立了强大的性能标准。
作者已将源代码和 MLUBench 数据集开源,以促进该领域的进一步研究。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。