Beyond Fully Random Masking: Attention-Guided Denoising and Optimization for Diffusion Language Models
作者:Jia Deng, Junyi Li, Wayne Xin Zhao, Jinpeng Wang, Hongyu Lu
作者提出 AGDO 框架,利用注意力结构指导扩散语言模型的去噪顺序,并在微调与强化学习中强调注意力关键 token,以对齐训练与推理动态。
论文信息摘要
论文要解决什么
现有扩散大语言模型后训练方法多依赖随机掩码策略,忽略了 token 间通过注意力形成的内在依赖,导致训练与推理动态不匹配。
论文方法概览
- Backbone: 扩散大语言模型 (如 Dream, LLaDA)
- 关键模块: 注意力引导去噪顺序、注意力关键 Token 加权
- 损失函数: 监督微调损失与强化学习损失 (含平均场近似)
读后要点
个人理解,欢迎指正
实验表明注意力分布具有稀疏性和时间一致性,关注已去噪上下文的 token 生成更稳定,对齐注意力依赖能显著提升推理性能。
局限与疑问
实证分析主要基于特定模型,注意力计算增加额外开销,方法在其他扩散架构上的泛化性待验证。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.12273v1。
Beyond Fully Random Masking: Attention-Guided Denoising and Optimization for Diffusion Language Models 阅读笔记
1. 论文概览
本文提出了一种名为 AGDO(Attention-Guided Denoising and Optimization)的框架,旨在解决扩散大语言模型(dLLMs)在后训练阶段中存在的掩码策略与内在 token 依赖不匹配的问题。作者指出,现有的 dLLMs 后训练方法主要依赖完全随机的掩码策略,忽略了 token 之间通过注意力机制形成的内在依赖关系。通过实证分析,论文发现与未掩码上下文注意力联系更强的 token 具有更高的生成稳定性,并在推理中起关键作用。基于此,AGDO 框架利用注意力结构指导去噪顺序,并在监督微调(SFT)和强化学习(RL)阶段强调注意力关键 token。实验表明,该方法在数学和代码基准测试中显著提升了推理性能,优于现有的 dLLMs 后训练方法。
2. 背景与动机
扩散大语言模型(dLLMs)通过并行解码为自回归(AR)模型提供了一种高效的替代方案。与从左到右顺序生成 token 的 AR 模型不同,dLLMs 迭代地去噪并并行解码 token,在推理阶段具有显著的效率优势。近期模型如 LLaDA 和 Dream 已证明其性能可与同等规模的 SOTA AR 模型相媲美。
然而,dLLMs 的有效后训练仍面临挑战。现有的全注意力 dLLMs 后训练方法(如 diff-GRPO 和 wd1)通常依赖于随机掩码 token 并优化掩码位置。虽然这种方法简单高效,但未能与 dLLMs 的实际推理动态对齐,导致训练与推理之间存在不匹配。尽管近期一些工作尝试引入不同的掩码策略(如块级 SFT 或遵循自然左到右生成顺序),但它们仍然强加了外部定义的解码顺序,忽略了全注意力 dLLMs 的一个关键属性:在双向注意力下,token 依赖关系并非严格由位置顺序决定,而是通过注意力交互动态涌现。
3. 注意力机制实证分析
为了更深入地理解这些内在依赖关系,作者对 dLLMs 中的注意力模式进行了实证分析。分析主要集中在语义依赖通常最明显的最后一层,并以 Dream-v0-Instruct-7B 模型为主要分析对象。
论文揭示了两个关键观察结果:
- 稀疏性与时间一致性:注意力分布在去噪步骤中表现出强烈的稀疏性和时间一致性,表明每个 token 始终依赖于一组较小且稳定的上下文 token。
- 生成稳定性:那些更强烈地关注已去噪 token 的 token,在生成过程中表现出显著更高的概率稳定性,这表明去噪顺序对于维持生成可靠性至关重要。
为了直观展示这些发现,论文提供了注意力动态的可视化分析。如下所示,图 1 展示了在 Dream-v0-Instruct-7B 上去噪过程中的注意力动态。
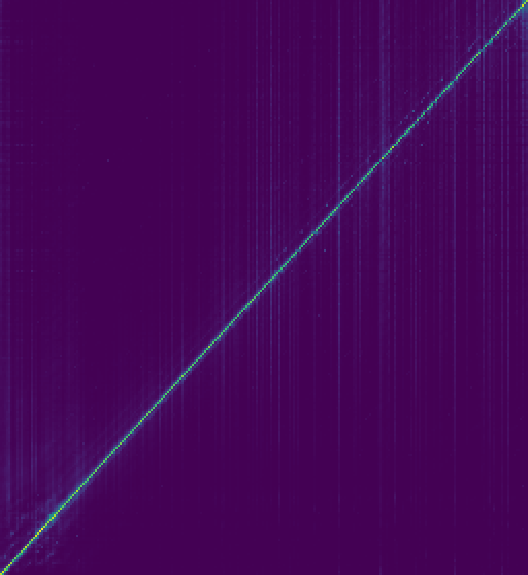
图 1 解读:
- 子图 (a) 至 (d):展示了在随机选择的去噪步骤中 token 之间的注意力分布。可以看出注意力矩阵并非均匀分布,而是呈现出特定的稀疏模式。
- 子图 (e) 至 (h):说明了随机选择的 token 在整个去噪过程中对其他 token 的注意力变化情况。
- 红色虚线:指示了对应 token 被去掩码(unmasked)的步骤。
这些发现暗示,有效的 dLLMs 训练策略应明确地将去噪轨迹与注意力诱导的 token 依赖关系对齐。
4. 方法:AGDO 框架
基于上述洞察,作者提出了 AGDO 框架,这是一个两阶段的后训练框架,旨在显式地将 dLLMs 的去噪轨迹与内在注意力结构对齐。
4.1 注意力引导的去噪顺序
AGDO 首先从有效的注意力分数中推导出注意力引导的去噪顺序,该顺序决定了训练期间 token 被去掩码的序列。通过确保 token 仅在有足够的注意力支持的上下文可用时才被去噪,该去噪顺序构成了 AGDO 的基础。这种方法避免了随机掩码带来的训练 - 推理不匹配,使训练过程更符合模型实际的注意力依赖机制。
4.2 监督微调与强化学习
在去噪顺序的基础上,AGDO 执行监督微调(AGDO-SFT)和强化学习(AGDO-RL)。
- 注意力关键 Token 强调:通过基于注意力的重新加权策略,进一步强调注意力枢纽(attention-hub)token。
- 策略优化:针对 dLLMs 无法像 AR 模型那样对 token 进行顺序分解的特点,论文采用了平均场近似(mean-field approximations)来计算策略优化所需的概率比和 KL 散度项,从而支持高效的单遍估计。
5. 实验与结论
论文在具有挑战性的数学和代码基准测试上进行了广泛的实验。结果显示,AGDO 显著提高了掩码 dLLMs 的推理能力,并持续优于现有的后训练方法。
主要贡献总结:
- 实证分析:揭示了 dLLMs 中注意力的稀疏性、时间一致性以及注意力强度与生成稳定性的关系。
- 方法创新:提出了 AGDO 框架,利用注意力结构指导去噪顺序,并在 SFT 和 RL 阶段优化关键 token。
- 性能提升:验证了将训练动态与内在注意力依赖对齐的重要性,证明了注意力引导去噪是 dLLMs 设计的一个原则性选择。
该工作强调了在 dLLMs 后训练中考虑 token 间内在依赖关系的重要性,为提升扩散语言模型的推理能力提供了新的方向。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。