Automated Creativity Evaluation of Language Models Across Open-Ended Tasks
作者:Min Sen Tan, Zachary Kit Chun Choy, Syed Ali Redha Alsagoff, Nadya Yuki Wangsajaya, Mohor Banerjee
作者提出了一种自动化、领域无关的框架,用于量化大模型在开放任务中的创造力。该框架将测量装置与任务分离,使用语义熵衡量发散性创造力,利用检索式多智能体框架评估收敛性创造力。
论文信息摘要
论文要解决什么
现有创造力评估指标通常与特定任务紧密耦合,嵌入领域假设,导致评估主观、资源密集且难以扩展。缺乏自动化、领域通用的评估标准。
论文方法概览
- Backbone: Large Language Models (LLMs)
- 关键模块: 语义熵 (Semantic Entropy) 与检索式多智能体法官框架
- 损失函数: 无 (评估框架,基于指标计算)
读后要点
个人理解,欢迎指正
实验表明该框架能可靠捕捉新颖性、多样性和任务完成度。模型规模、温度、时效性和推理能力显著影响创造力表现。语义熵与人类标注及基线多样性度量一致。
局限与疑问
评估依赖 LLM 作为法官,可能引入评估者偏见。多智能体框架虽提升效率但仍需计算资源。跨文化通用性有待进一步验证。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.11762v1。
论文阅读笔记:Automated Creativity Evaluation of Language Models Across Open-Ended Tasks
1. 论文概述
随着大型语言模型(LLMs)在语言理解、推理和生成方面取得显著进展,其创造潜力引发了广泛关注。然而,现有的创造力评估指标通常与特定任务紧密耦合,嵌入了领域假设,限制了评估的可扩展性和通用性。
为了解决这一差距,作者提出了一种自动化的、与领域无关的框架,用于量化 LLM 在开放式任务中的创造力。该框架的核心在于将测量装置与创造性任务本身分离,从而实现可扩展的、任务无关的评估。论文认为,创造力包含发散性思维(Divergent Thinking)和收敛性思维(Convergent Thinking)两个维度,并分别设计了相应的自动化评估方法。
2. 核心方法论
作者将创造力评估拆解为两个独立的部分:发散性创造力(衡量新颖性和多样性)和收敛性创造力(衡量任务完成度)。
2.1 发散性创造力评估:语义熵
发散性思维是指生成多样化、新颖和创新想法的能力。作者假设发散性创造力反映在模型在开放式任务中可以探索的合理语义方向的多样性上。为了量化这一属性,论文采用了语义熵(Semantic Entropy, SE)。
语义熵是一种基于采样的、无参考的指标,用于量化模型生成输出的变异性。与传统的基于不确定性的幻觉检测不同,作者将其重新解释为开放式生成中发散性创造力的操作化定义。
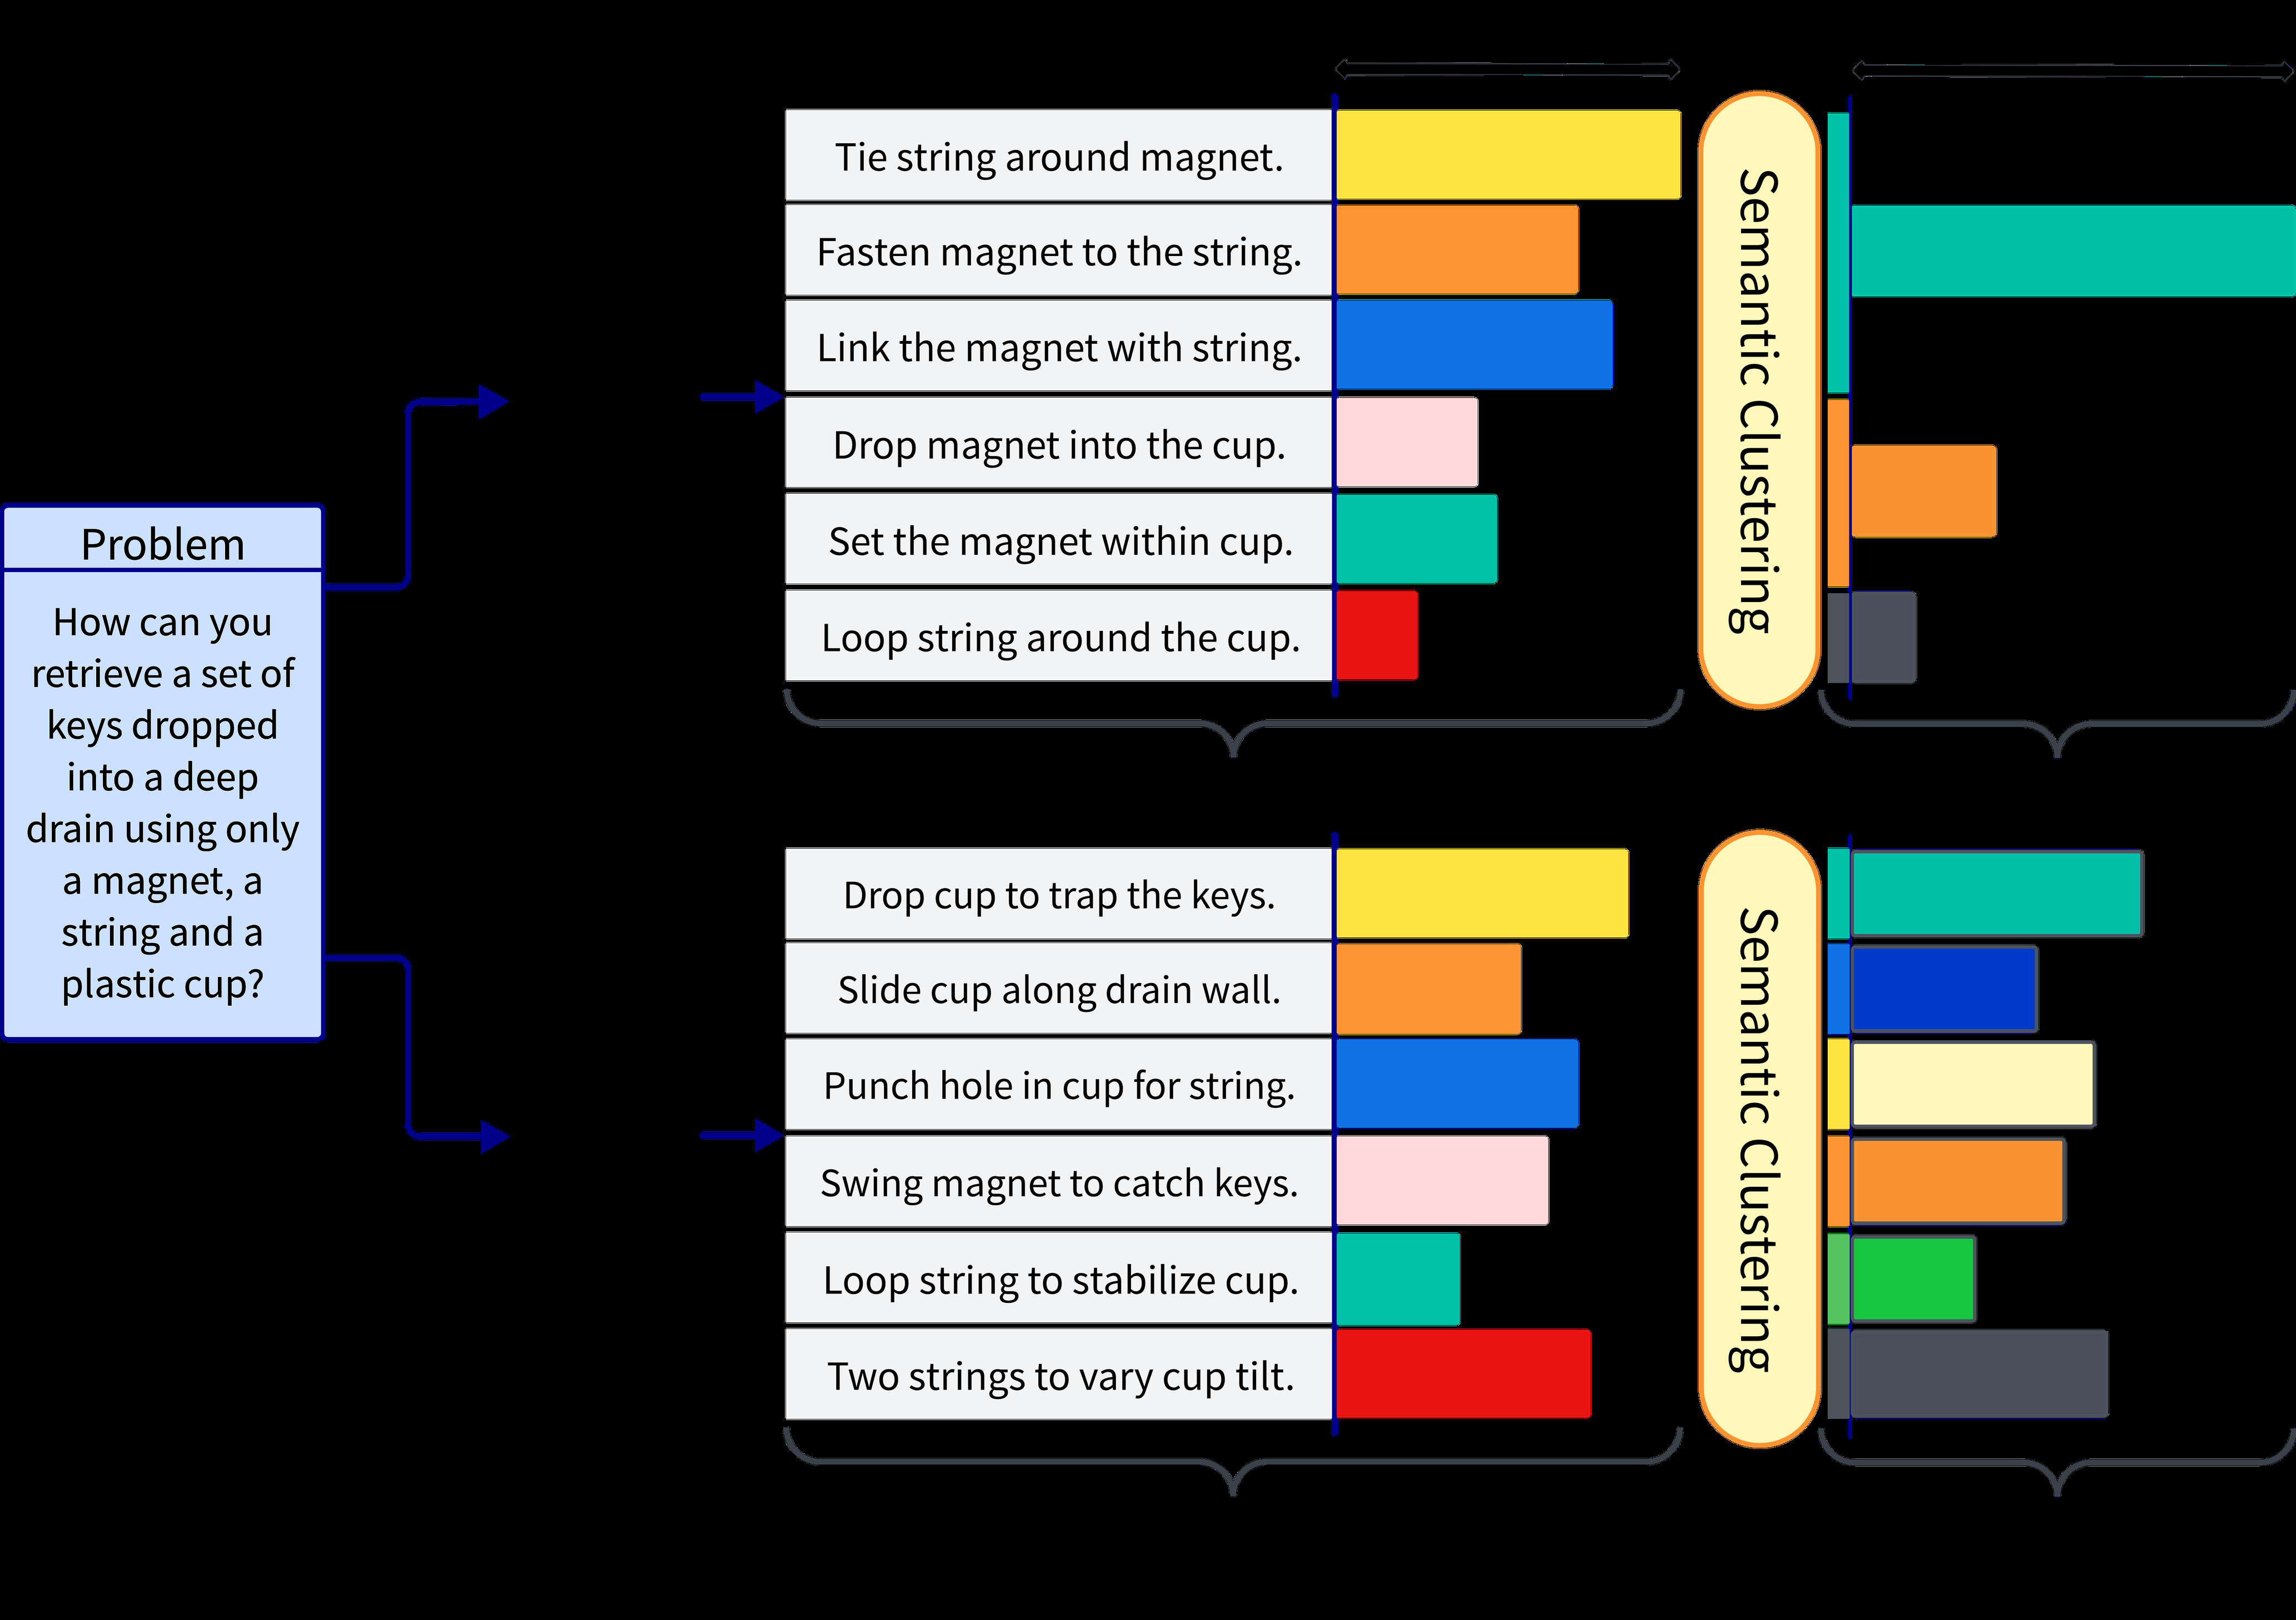
论文通过图 1 展示了语义熵的计算逻辑。模型生成的步骤按相似度聚类,熵在集群概率上计算。
如图所示,上图展示了一个创造力较低的模型,其产生的是表面层面的改写,导致语义熵较低;下图展示了一个创造力较高的模型,其产生的是真正不同的想法,导致语义熵较高。作者指出,该方法无需参考标准答案,且经过人类标注、LLM 新颖性判断和基线多样性度量的验证,能够忠实反映发散性创造力的核心标志。
2.2 收敛性创造力评估:检索式多智能体框架
收敛性思维涉及综合信息以产生针对特定目标和背景的解决方案。评估这一方面具有内在的主观性。为此,作者提出了一种自适应的、自主的多智能体 LLM 评估框架,其中智能体协作评估任务完成度的不同方面。
为了解决传统基于讨论的评估方法计算效率低的问题,作者引入了一种基于检索的讨论框架,简化了审查流程,使大规模基准测试更加可行。论文声称该方法在任务完成度的上下文敏感评估中,效率提高了 60% 以上。
图 2 展示了该检索式多智能体框架的架构。
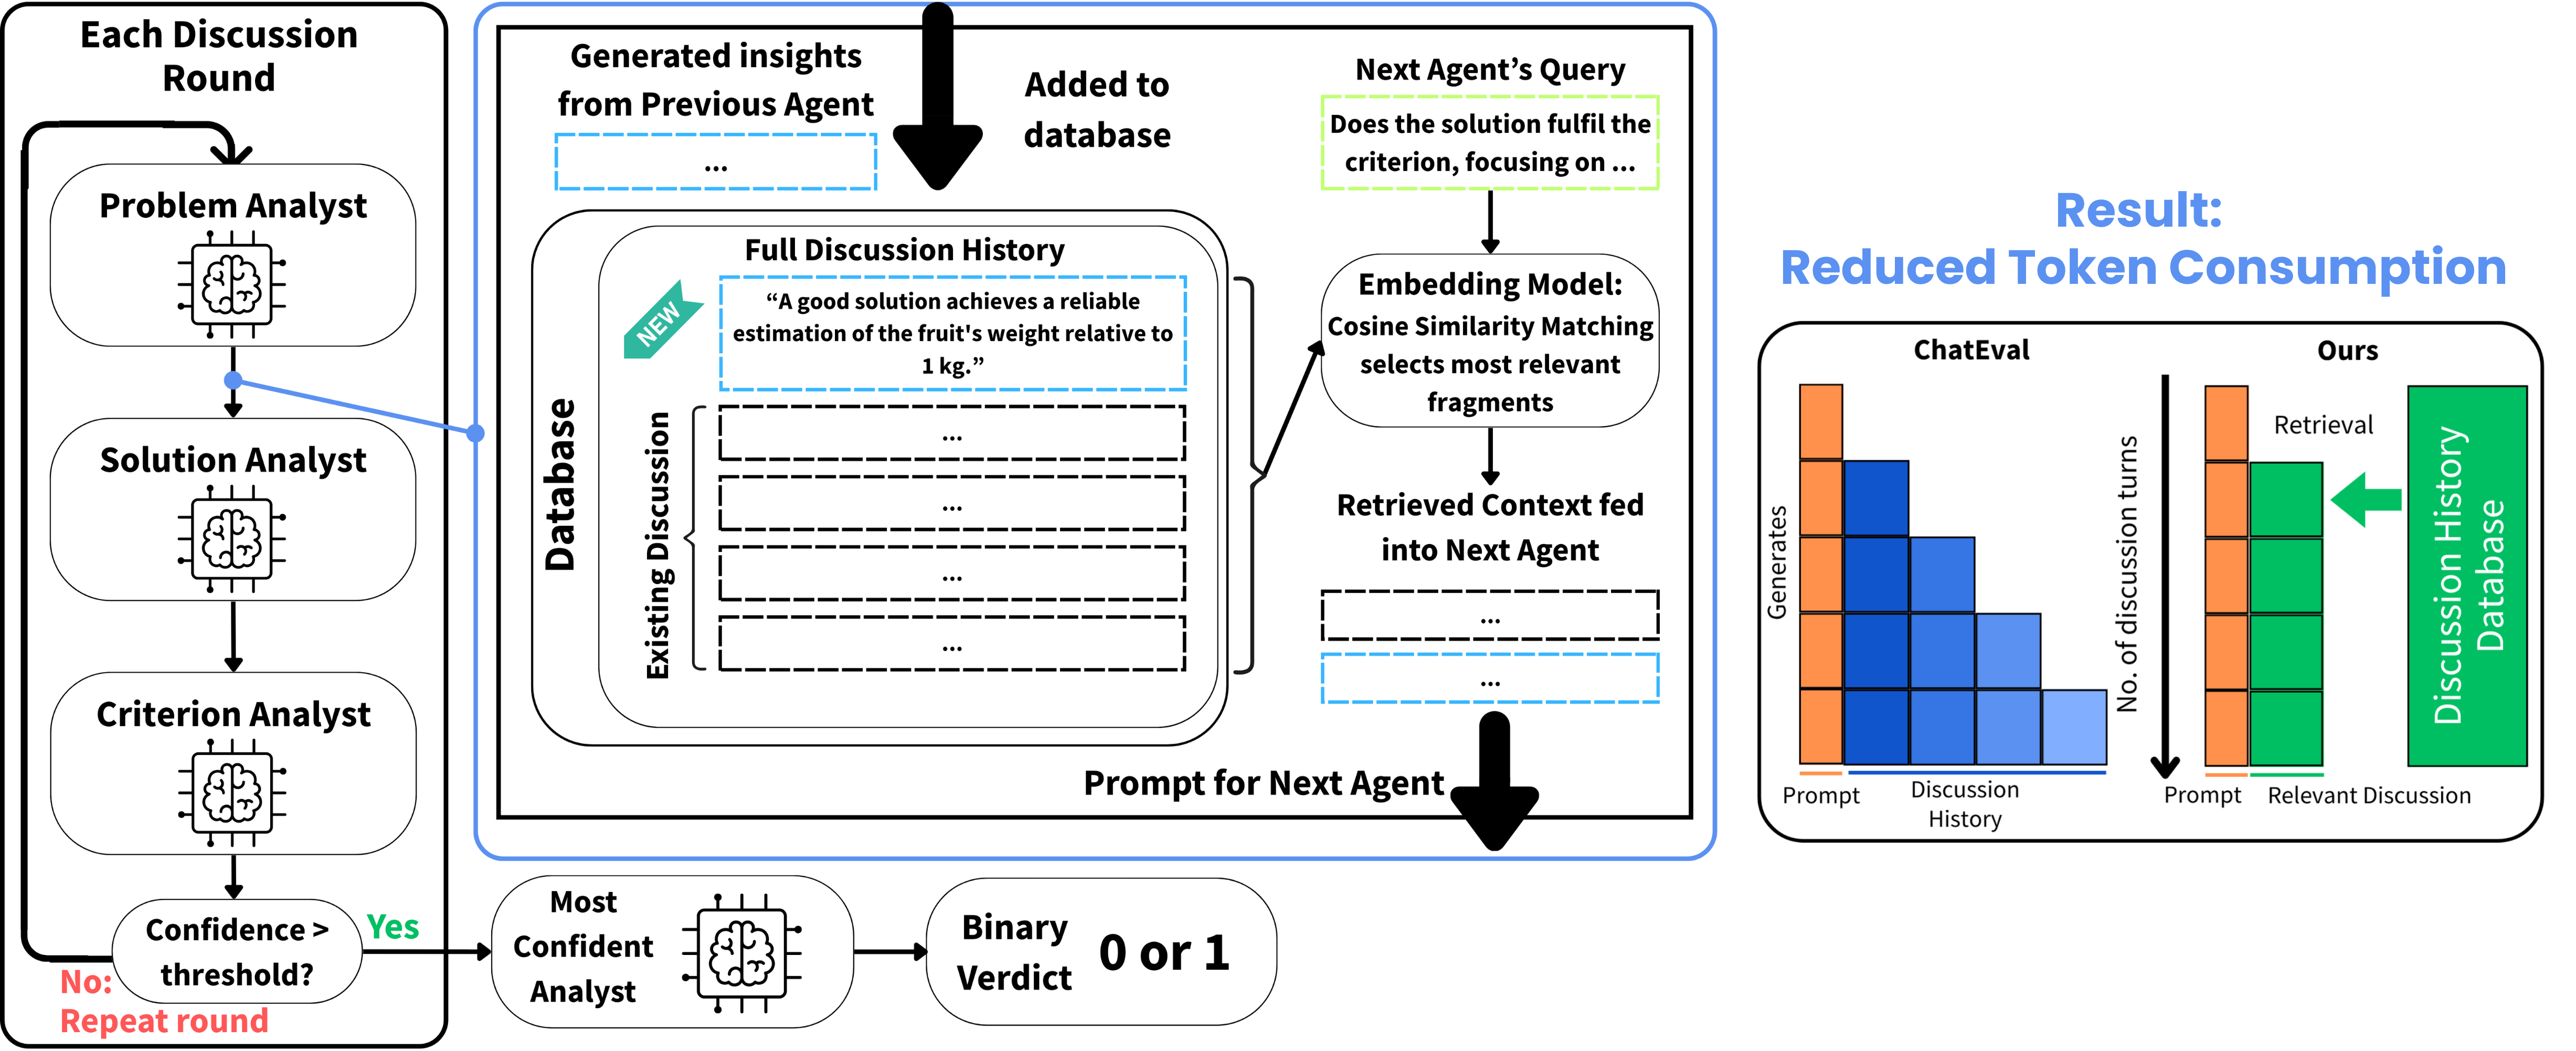
该框架包含三个专门的 LLM 智能体:问题智能体(Problem)、解决方案智能体(Solution)和评估智能体(Judge),它们通过检索机制进行协作,以高效地完成对模型输出的评估。
3. 实验设置与基准
为了证明框架的通用性和实用价值,作者在三个定性不同的创造力领域进行了验证:
- 问题解决(Problem-solving):使用 MacGyver 数据集。
- 研究构思(Research ideation):使用 HypoGen 数据集。
- 创造性写作(Creative writing):使用 BookMIA 数据集。
这三个领域捕捉了创造力的互补方面:约束下的功能推理、科学思想的逻辑综合以及叙事原创性。
图 3 展示了所有三个数据集的基准测试概览。
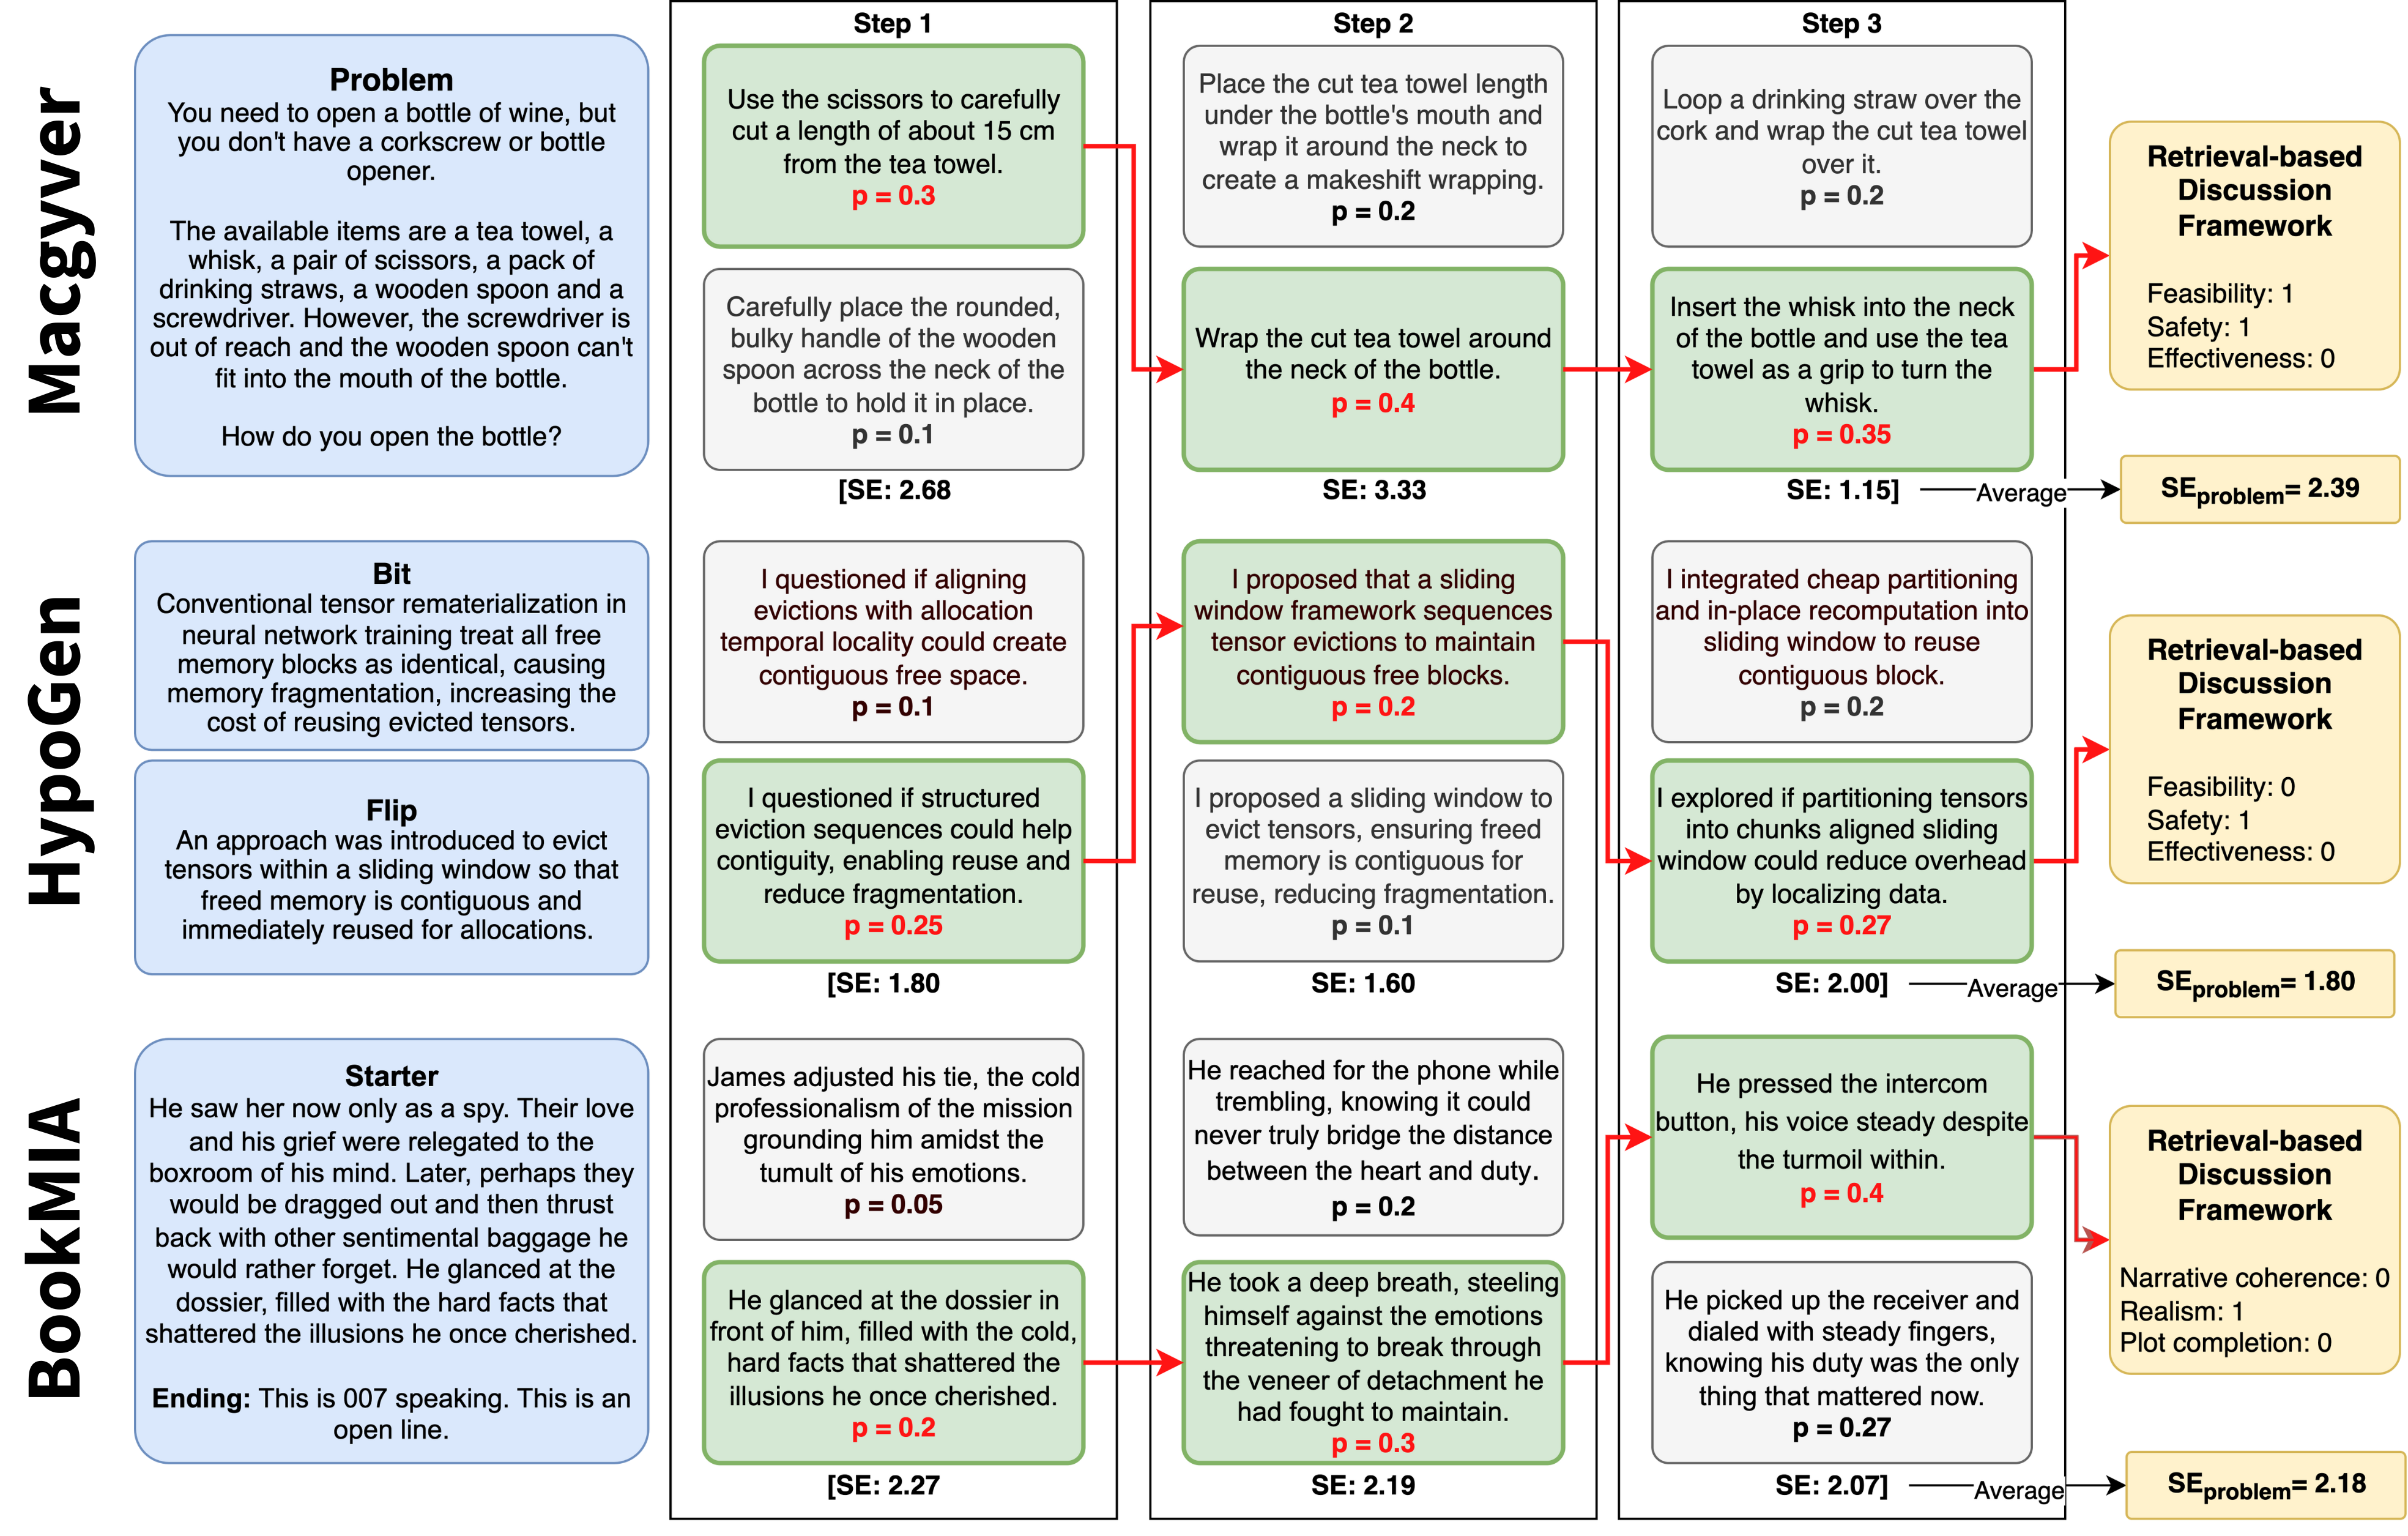
实验在每个领域应用了 300 个问题,并对多样化的 LLM 进行了基准测试。作者分析了模型大小、时间先后(recency)、温度(temperature)和推理增强如何影响创造力表现。
4. 结果与分析
实证结果表明,该框架能够可靠地捕捉创造力的关键方面,包括新颖性、多样性和任务完成度。
4.1 语义熵分析
作者深入分析了语义熵在不同步骤的表现。图 4 展示了语义熵分析结果,其中 (a) 部分显示了步骤级语义熵与每一步形成的语义集群数量之间的关系。
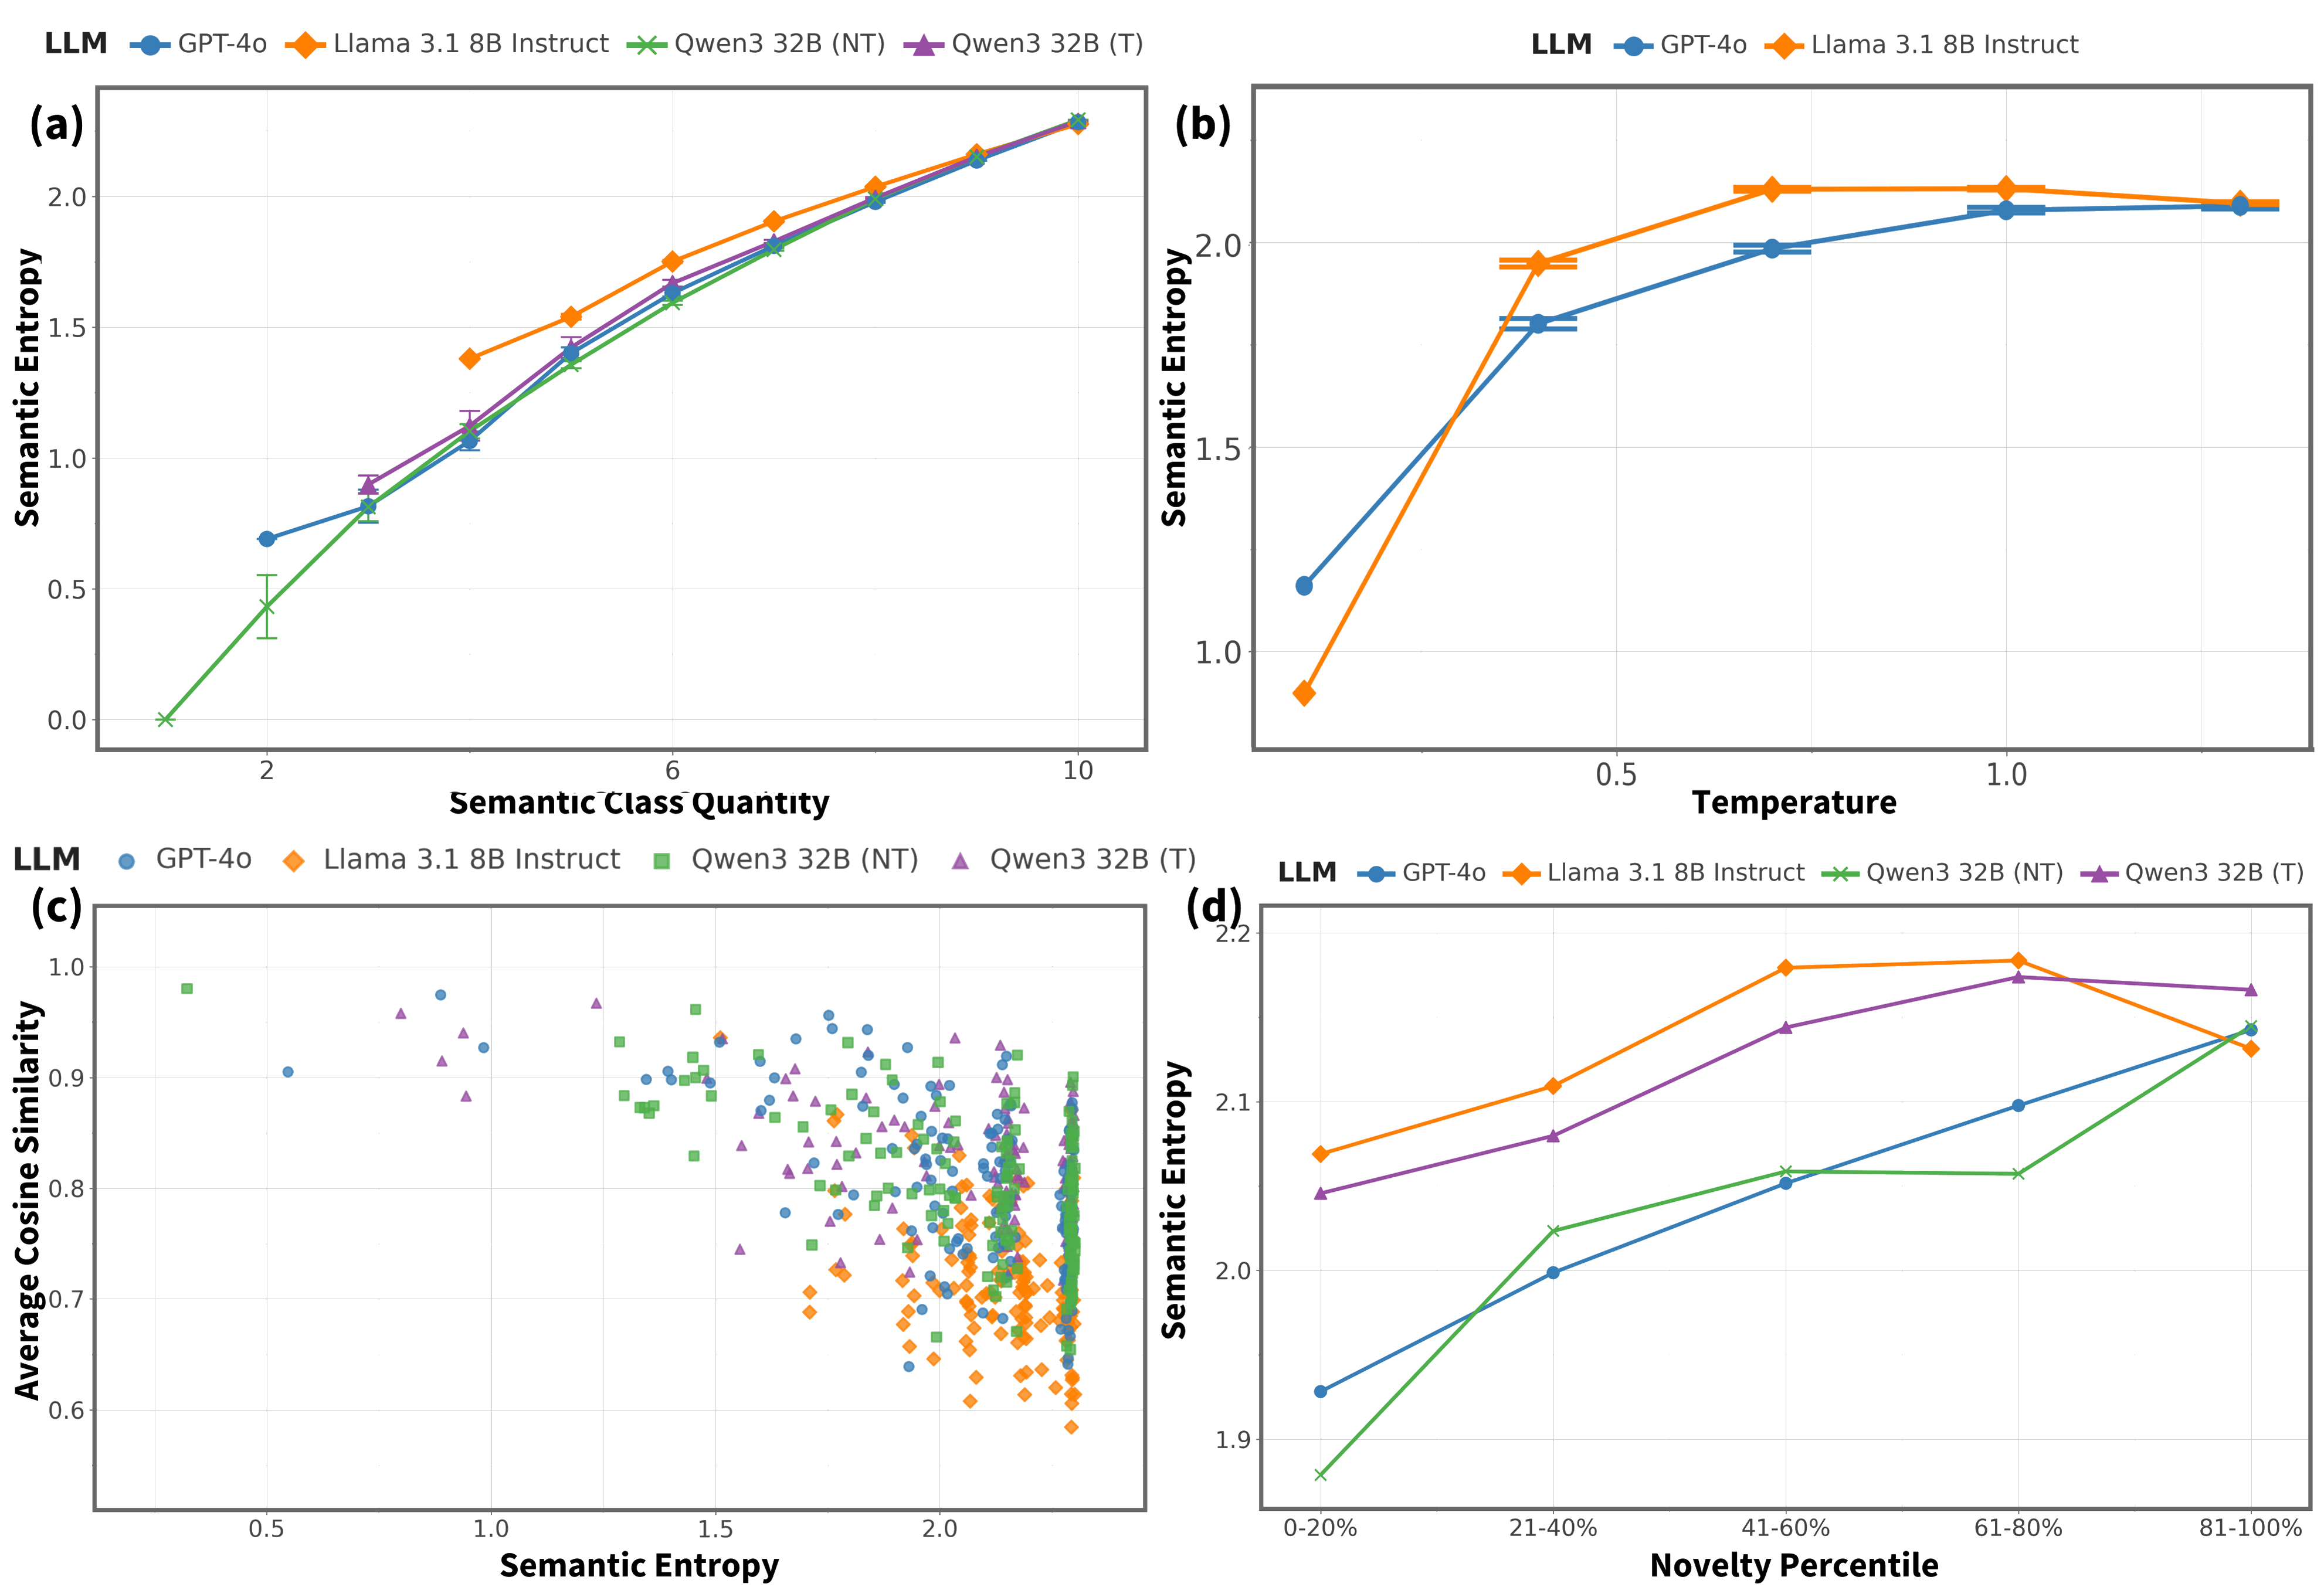
这一分析验证了语义熵作为发散性创造力指标的有效性,表明模型生成的语义集群数量与熵值之间存在相关性,反映了模型探索不同解决方案方向的能力。
4.2 模型属性的影响
论文进一步探讨了模型属性对创造力表现的影响。图 5 展示了各种参数的影响,包括左侧的模型大小、中间的模型时间先后(recency)以及右侧的推理能力。
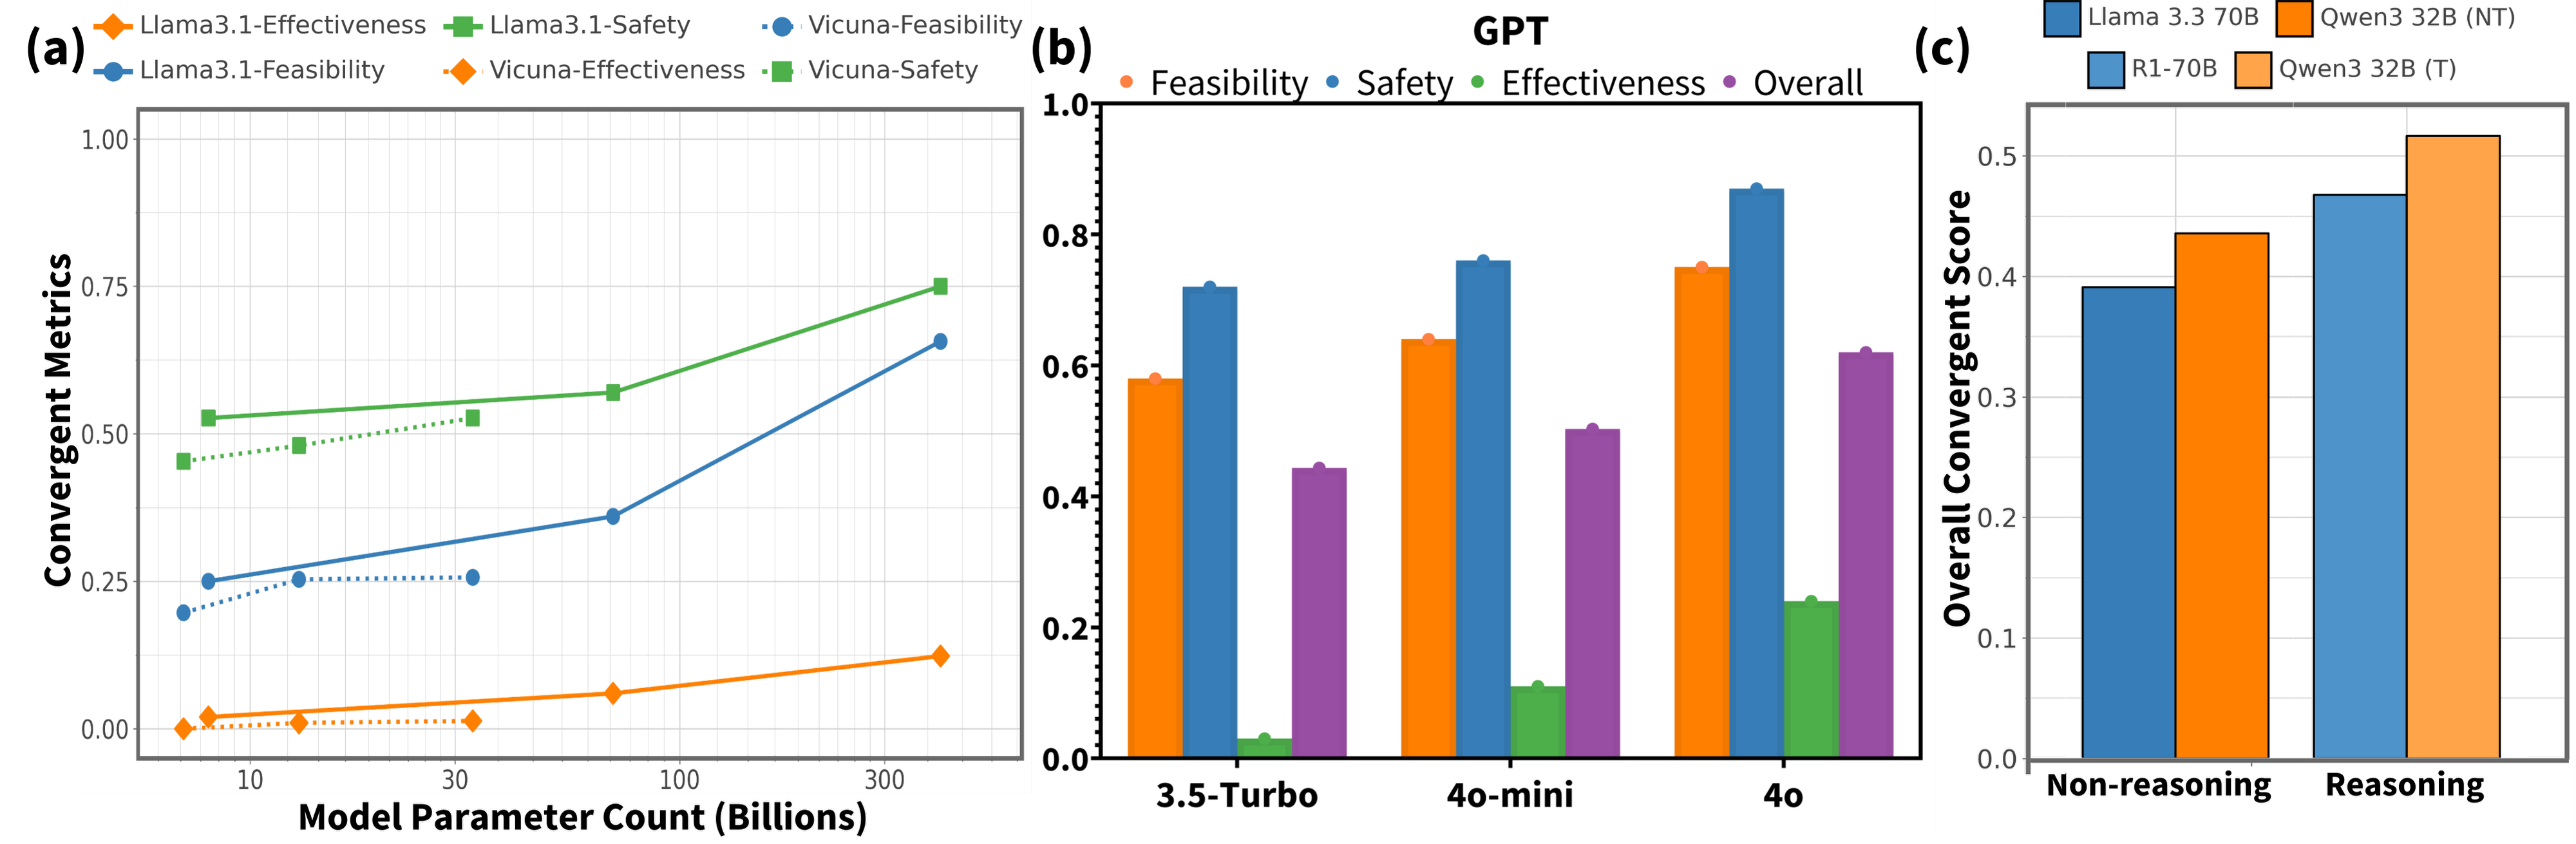
实验结果揭示了模型规模、训练数据的时效性、采样温度以及推理增强机制如何具体影响模型的创造性输出。这为理解 LLM 的创造力边界提供了实证依据。
4.3 指标对比
为了验证所提方法的有效性,作者将语义熵与不同的收敛性创造力指标进行了对比。图 6 展示了在 MacGyver 数据集上,语义熵与其他收敛性创造力指标(Y 轴)的比较。
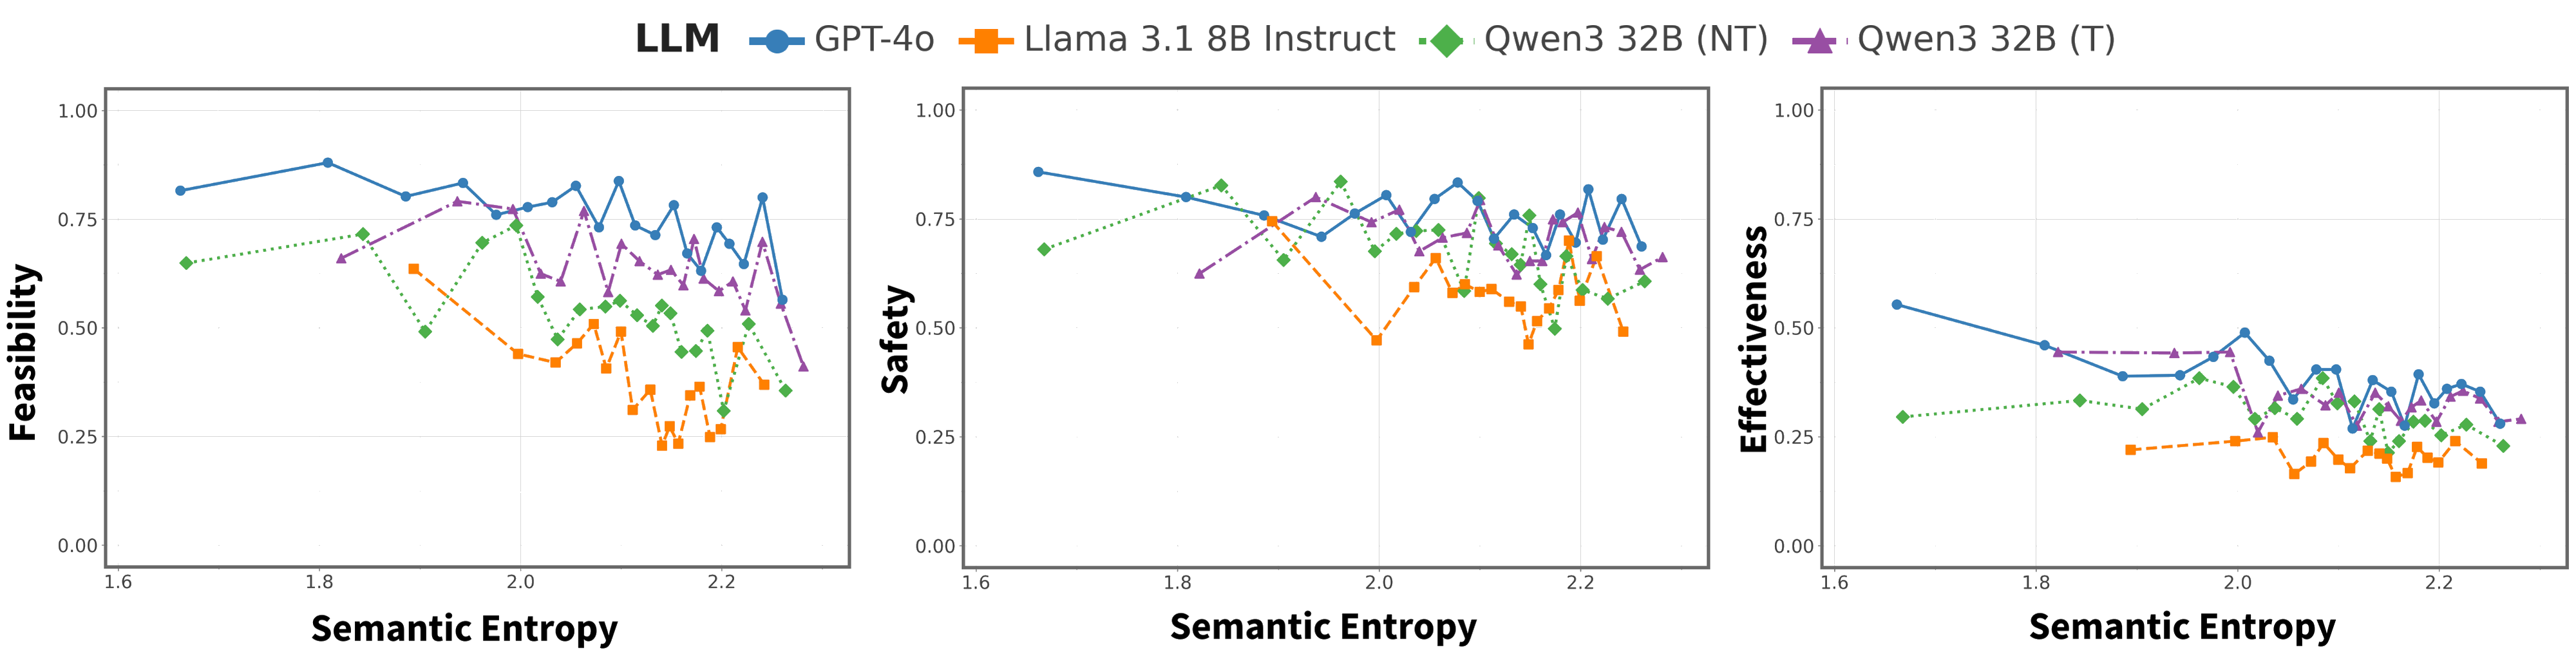
结果显示,该框架不仅能够在不同领域间泛化,还能系统性地分析模型特性对创造力性能的影响,建立了可复现且可推广的自动化 LLM 创造力评估标准。
5. 总结与展望
本文提出了一种完全自动化、领域通用的 LLM 创造力评估框架。主要贡献包括:
- 通过语义熵引入了无参考、自动化的发散性创造力评估。
- 开发了一种计算效率更高的多智能体 LLM 评估框架,用于评估收敛性创造力。
- 在 MacGyver、HypoGen 和 BookMIA 上进行了全面的实证基准测试。
作者认为,这项工作为可扩展的基准测试铺平了道路,将加速创造性 AI 的进步。未来的工作可能涉及进一步扩展评估领域,以及探索创造力评估与模型对齐之间的潜在联系。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。