Flexible Kernels for Protein Property Prediction
作者:Martin Jankowiak, Yerdos Ordabayev, Rudraksh Tuwani, Henry N. Ward, Hunter Nisonoff
作者提出了一类利用进化替换矩阵和局部线性性的序列核函数,结合高斯过程构建蛋白质属性预测模型。该方法在稀疏数据下表现出高效性,并能通过结构感知替换矩阵整合基础模型的结构信息。
论文信息摘要
论文要解决什么
从稀疏实验数据中准确预测蛋白质属性(如结合亲和力、热稳定性),同时满足数据高效、高质量不确定性估计及多任务学习的需求。
论文方法概览
- Backbone: Gaussian Processes (GPs)
- 关键模块: Locally Linear Correlation Kernels (LOCK), Evolutionary Substitution Matrices
- 损失函数: Negative Log Marginal Likelihood
读后要点
个人理解,欢迎指正
实验表明,基于序列的高斯过程模型在数据稀缺场景下常优于依赖大规模基础模型嵌入的方法。结构条件核在多任务学习中表现显著,能有效利用跨任务的结构信息。
局限与疑问
高斯过程的计算复杂度随样本量增加而上升;结构条件版本依赖基础模型提供的结构信息质量。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.11057v1。
论文阅读笔记:Flexible Kernels for Protein Property Prediction
论文 ID: 2606.11057v1
标题: Flexible Kernels for Protein Property Prediction
作者: Martin Jankowiak, Yerdos Ordabayev, Rudraksh Tuwani, Henry N. Ward, Hunter Nisonoff, James M. McFarland, Gevorg Grigoryan
机构: Generate Biomedicines, Somerville, MA, USA
1. 研究背景与动机
在蛋白质设计领域,准确预测蛋白质属性(如结合亲和力、热稳定性)是至关重要的工具。然而,从稀疏的实验数据中预测这些属性仍然是一个重大挑战。作者指出,尽管近期许多注意力集中在全原子生成模型上,但基于结构预测器(如 AlphaFold2)的高保真判别器的效用同样明显。
论文认为,整个“生成到判别”的连续体对于装备精良的蛋白质设计者来说都是必不可少的工具。基于此动机,作者致力于开发准确的蛋白质属性景观模型。作者特别关注满足以下三个标准的方法:
- 数据高效性(data-efficient);
- 高质量的不确定性估计(high-quality uncertainty estimates);
- 适合跨多个景观的多任务学习(well-suited to multi-task learning)。
作者通过理论论证和实证演示,提出带有适当构造核函数的高斯过程(Gaussian Processes, GPs)符合上述所有标准。
2. 方法基础:高斯过程与序列核
2.1 问题描述与高斯过程
论文将经验蛋白质属性景观定义为 个蛋白质序列 ,每个序列关联一个标量属性 。序列假设具有固定长度 和固定字母表大小 ,采用 one-hot 编码表示。目标是学习一个预测模型,能够预测任意序列 的属性 。
作者回顾了高斯过程(GPs)作为强大的非参数函数先验,通常在数据稀缺 regime 下表现良好。GP 由协方差函数或核函数 指定。对于标量回归,联合密度形式已知,边际似然可闭式计算并通过梯度方法最大化以拟合核超参数。后验预测分布为正态分布,提供了均值和方差估计。
2.2 基础序列核
论文介绍了两种定义在 one-hot 序列空间上的最简单核:
- 线性核(Linear Kernel):对应于贝叶斯线性回归,假设系数之间没有先验结构。例如,观察到突变 不会告知其他突变如 的效果。
- RBF 核(RBF Kernel):具有乘积结构,随着汉明距离增加呈指数衰减。在 one-hot 序列上下文中,RBF 核可视为协方差矩阵的乘积。
3. 核心方法:灵活蛋白序列核
作者提出了一类利用进化替换矩阵(evolutionary substitution matrices)和局部线性性(local linearity)的序列核。
3.1 替换矩阵与无限可分性
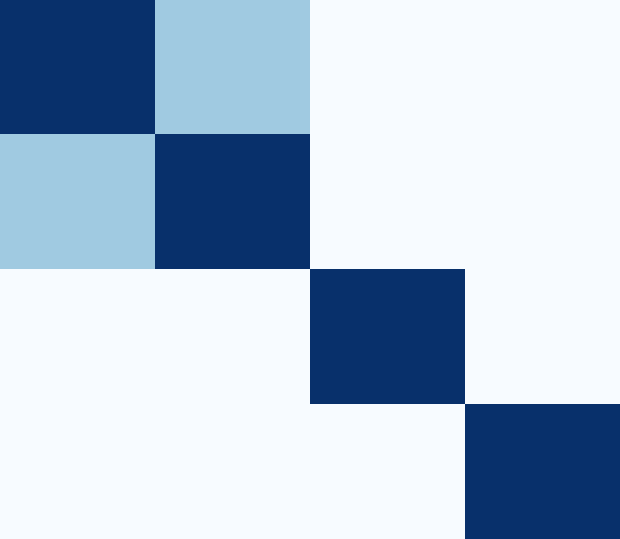
作者首先讨论了替换矩阵,这是量化进化过程中氨基酸替换可能性的经典生物信息学工具。为了方便,作者使用替换矩阵的相关矩阵形式。
论文指出一个有趣的观察:虽然许多替换矩阵(如大多数 PAM 矩阵)是半正定(PSD)的,但某些替换矩阵(特别是大多数 BLOSUM 族)具有无限可分性(infinitely divisible)。这意味着对这些矩阵进行元素级指数运算(Hadamard power)可以保持半正定性。
这一特性使得 BLOSUM 矩阵非常适合作为蛋白质序列核的组成部分。通过将可学习的指数作为 GP 核的超参数,提供了一种强大且简约的机制来调节核的协方差结构。大于 1 的幂会减弱非对角线相似性,而小于 1 的幂则会放大它们。因此,通过学习景观特定的指数,这些替换矩阵编码的生物物理相似性可以适应当前的景观。
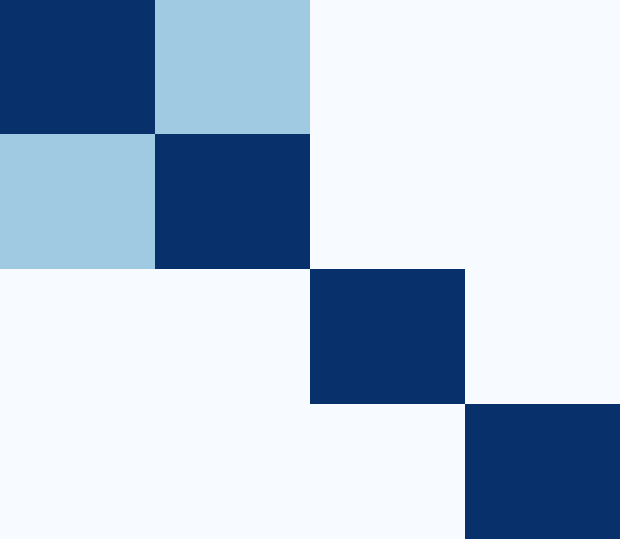 图 1:BLOSUM50 替换矩阵作为相关矩阵。右侧矩阵已提升至 0.03 次幂。
3.2 局部线性性
作者提出将局部线性性明确构建到建模方法中。长期以来人们认识到,在许多情况下,蛋白质属性相对于单个突变大致是可加的,且成对上位效应通常较小。
作者指出,任何形式为 的核(其中 是任意核, 是线性核)自然被视为描述局部线性函数类。如果 被选择使得系数 在序列空间中变化缓慢,则函数 在 附近是局部线性的。
3.3 LOCK:局部线性相关核
结合上述要素,作者提出了 LOCK (Locally Linear Correlation Kernels)。虽然文中具体公式在片段中未完全展示,但核心思想是将基于替换矩阵的相关核与线性核相结合,以捕捉蛋白质序列中的进化约束和局部线性效应。
3.4 结构条件核
作者进一步展示了这些核可以轻松地结合来自基础模型的结构信息。通过学习实际上是结构感知的替换矩阵(structure-aware substitution matrices),这些核能够利用基础模型(如 AlphaFold 等)提供的结构嵌入。
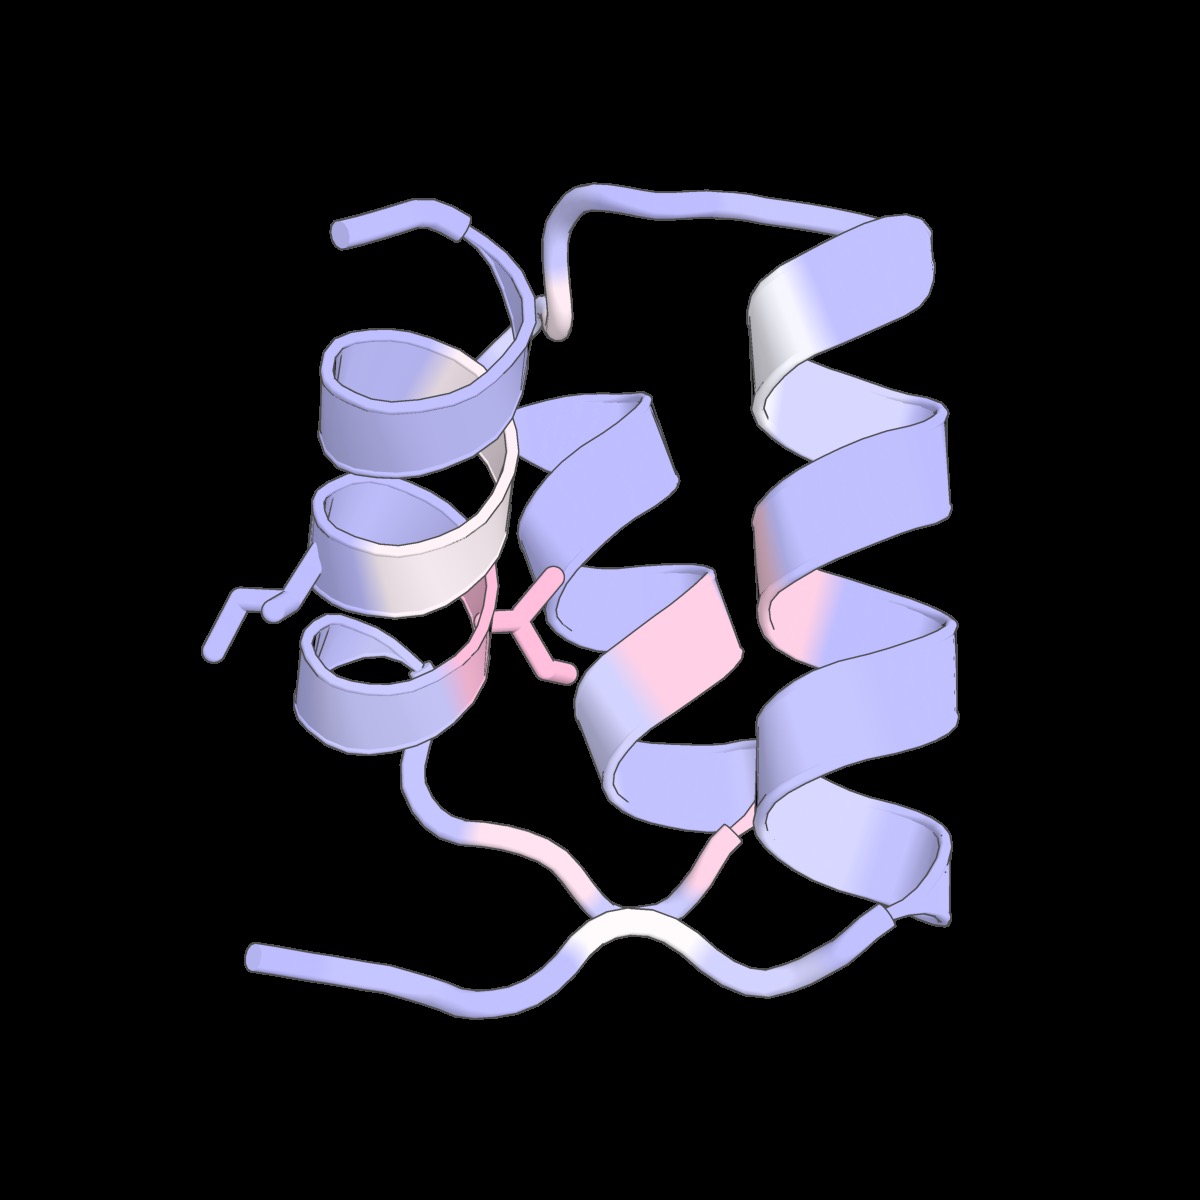 图 6:学习到的结构条件氨基酸相关性。
4. 实验结果与多任务学习
4.1 基准测试
作者进行了全面的基准测试,在三种不同 regime 下的 21 个数据集上评估了 30 多种蛋白质属性预测器。结果表明,基于序列的 GP 模型经常优于依赖数百万参数基础模型的更复杂(结构条件)预测器。
4.2 多任务学习
论文展示了结构条件核非常适合跨多个蛋白质属性景观的多任务学习。作者提出了一种简单但强大的训练多任务 GP 的配方,利用基础模型嵌入形成零样本结构条件核。
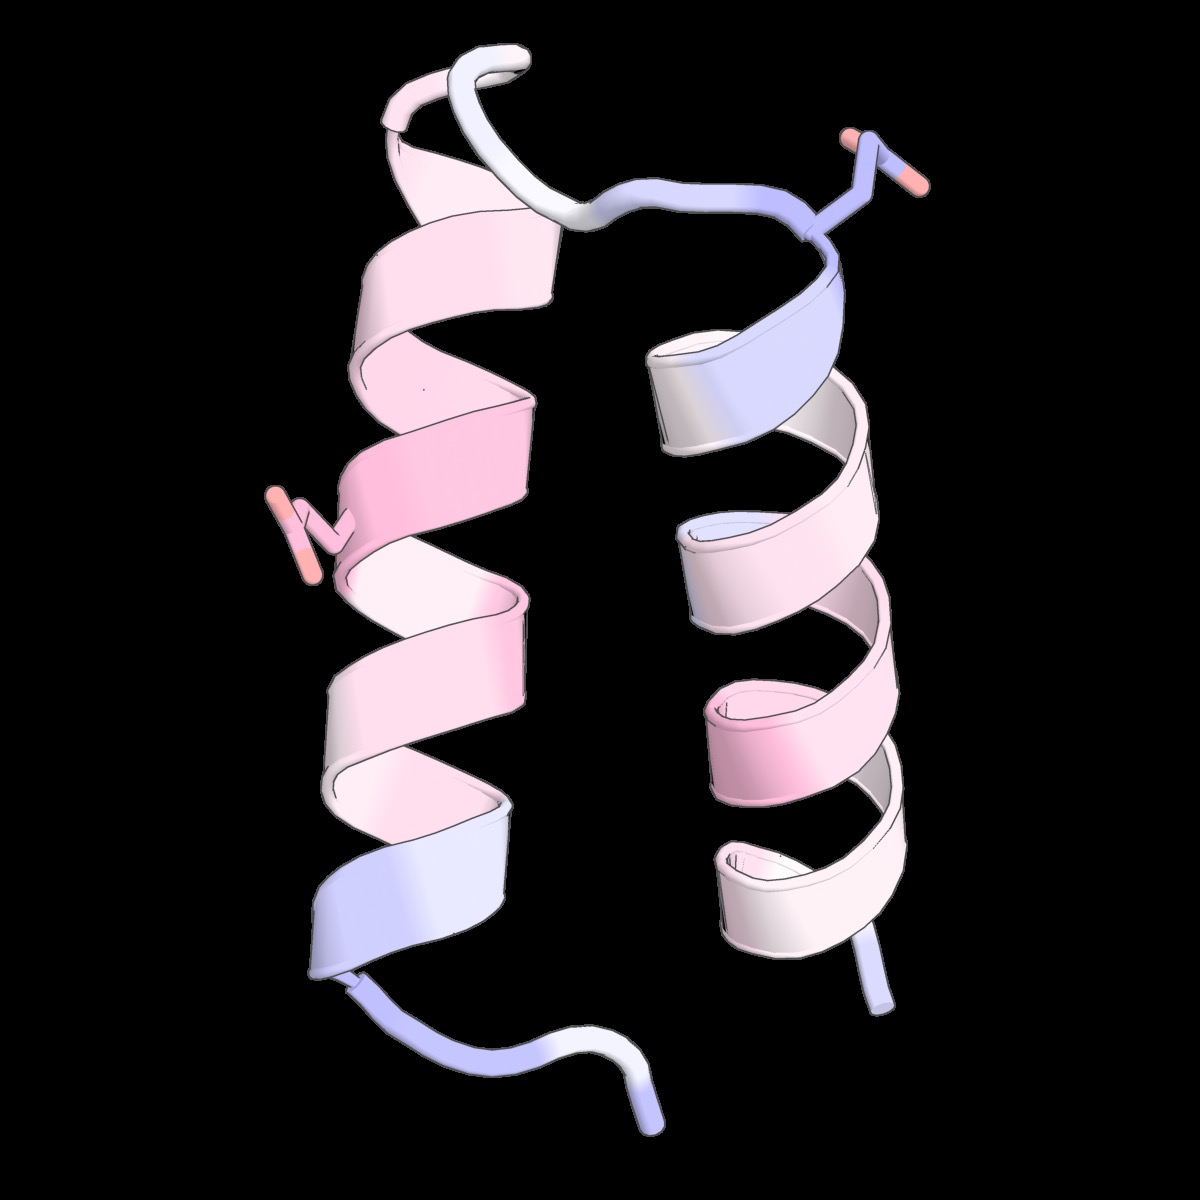 图 5:多任务模型性能变化的描绘。
实验显示,这些多任务模型可以显著优于局部监督学习方法。通过共享跨任务的结构信息,模型能够更有效地利用稀疏数据。
5. 总结
这篇论文提出了一种基于高斯过程的灵活核方法,用于蛋白质属性预测。主要贡献包括:
- 数据高效性:在稀疏数据下,序列核 GP 表现优异,常优于依赖大型基础模型的方法。
- 不确定性估计:利用 GP 特性提供高质量的不确定性量化。
- 多任务学习:通过结构条件核,实现了跨多个属性景观的有效多任务学习。
作者认为,这种方法结合了进化信息(替换矩阵)和局部线性假设,为蛋白质设计提供了一个强大的判别器工具,补充了现有的生成模型。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。