Early-Token Confidence Predicts Reasoning Quality in Multi-Agent LLM Debate
作者:Ali Keramati, Justin Cheok, Jacob Horne, Mark Warschauer
作者利用多智能体辩论框架,探究解码过程中的 token 级对数概率能否预测推理质量。研究发现生成初期的早期 token 置信度是推理质量的最强预测因子,优于全序列统计。
论文信息摘要
论文要解决什么
在没有参考答案的开放式任务中,评估多智能体 LLM 系统的推理质量具有挑战性,需要寻找轻量级且有效的内在信号来估计推理可靠性。
论文方法概览
- Backbone: Multi-Agent LLM Debate System (Advocate, Skeptic, Synthesizer)
- 关键模块: Token-level log-probability extraction, LLM-as-judge evaluation
- 损失函数: N/A (Empirical Analysis)
读后要点
个人理解,欢迎指正
实验表明生成初始阶段的对数概率轨迹最具异质性和信息量;支持性推理角色的置信度与质量对齐度高于对抗性批评角色;早期解码动态可作为轻量级可靠性信号。
局限与疑问
研究主要基于 ASAP 作文数据集,结论在其他领域或任务上的泛化性待验证;仅分析了特定辩论架构下的置信度信号。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.10307v1。
arXiv 论文阅读笔记:Early-Token Confidence Predicts Reasoning Quality in Multi-Agent LLM Debate
论文基本信息
- 论文 ID: 2606.10307v1
- 标题: Early-Token Confidence Predicts Reasoning Quality in Multi-Agent LLM Debate
- 作者: Ali Keramati, Justin Cheok, Jacob Horne, Mark Warschauer
- 机构: University of California, Irvine
- 日期: 2026 年 6 月 9 日
研究背景与问题定义
随着大型语言模型(LLM)的发展,多智能体系统(Multi-Agent Systems)在解决复杂任务方面展现出显著优势。作者指出,通过分解问题为特定角色的子任务,这类系统在推理、规划和自动化决策等应用中提高了性能、鲁棒性和一致性。其中,辩论(Debate)作为一种交互范式,通过激发支持和反对的论点,鼓励探索多样化的推理路径,并暴露单智能体轨迹中可能隐藏的错误。
然而,评估多智能体 LLM 系统中的推理质量具有挑战性,特别是在没有参考答案的开放式任务中。论文认为,虽然基于量表的评分(Rubric-based scoring)提供了一个具体的评估场景(如自动作文评分 AES),但辩论增加了系统复杂性,引入了多个智能体、多条消息以及潜在的细微程序失败风险。
现有的评估方法主要依赖“LLM-as-judge”范式,即使用独立的语言模型根据预定义标准对生成输出进行评分。尽管这已成为人类评估的可扩展替代方案,但作者指出这仅提供了一个外部质量信号。一个重要的开放问题是:这些判断在多大程度上反映了底层推理过程的真实可靠性?特别是,能否在生成模型内部识别出与外部评估的推理质量相关的内在信号?
方法论与实验框架
为了解决上述问题,作者提出利用解码过程中产生的 token 级对数概率(token-level log-probabilities)作为模型置信度的操作化指标。论文假设,如果智能体遵循更连贯且基于证据的推理路径,模型应为其生成的 token 分配更高的概率质量,从而产生更自信的 logprob 轨迹。
多智能体辩论架构
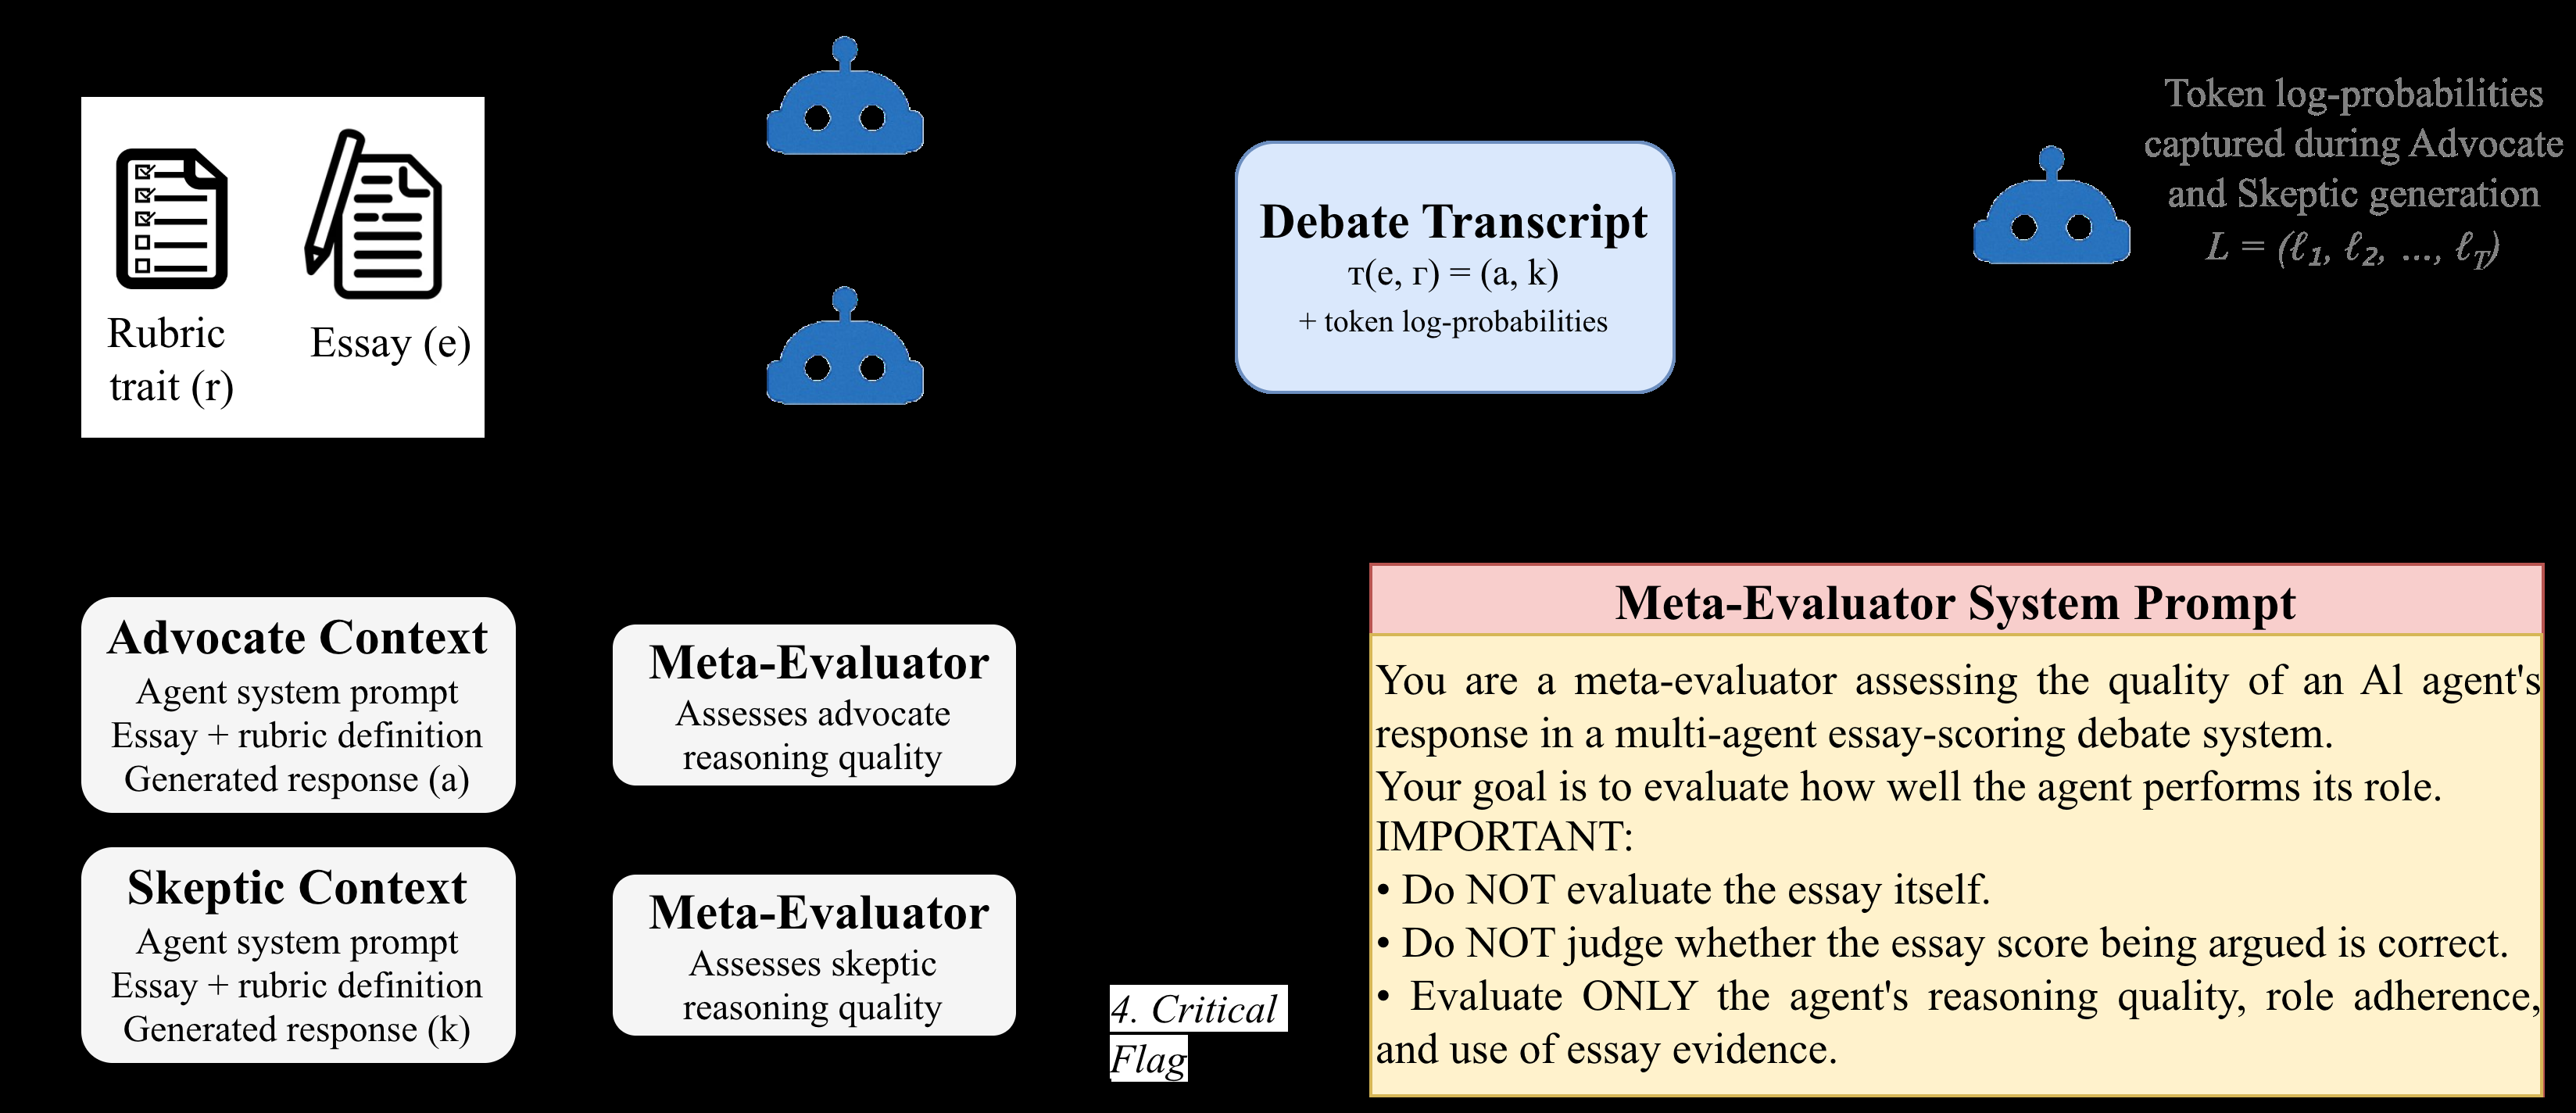
论文构建了一个基于多智能体辩论的框架,并结合了 LLM-as-judge 元评估模块用于推理分析。整体框架如图 1 所示。
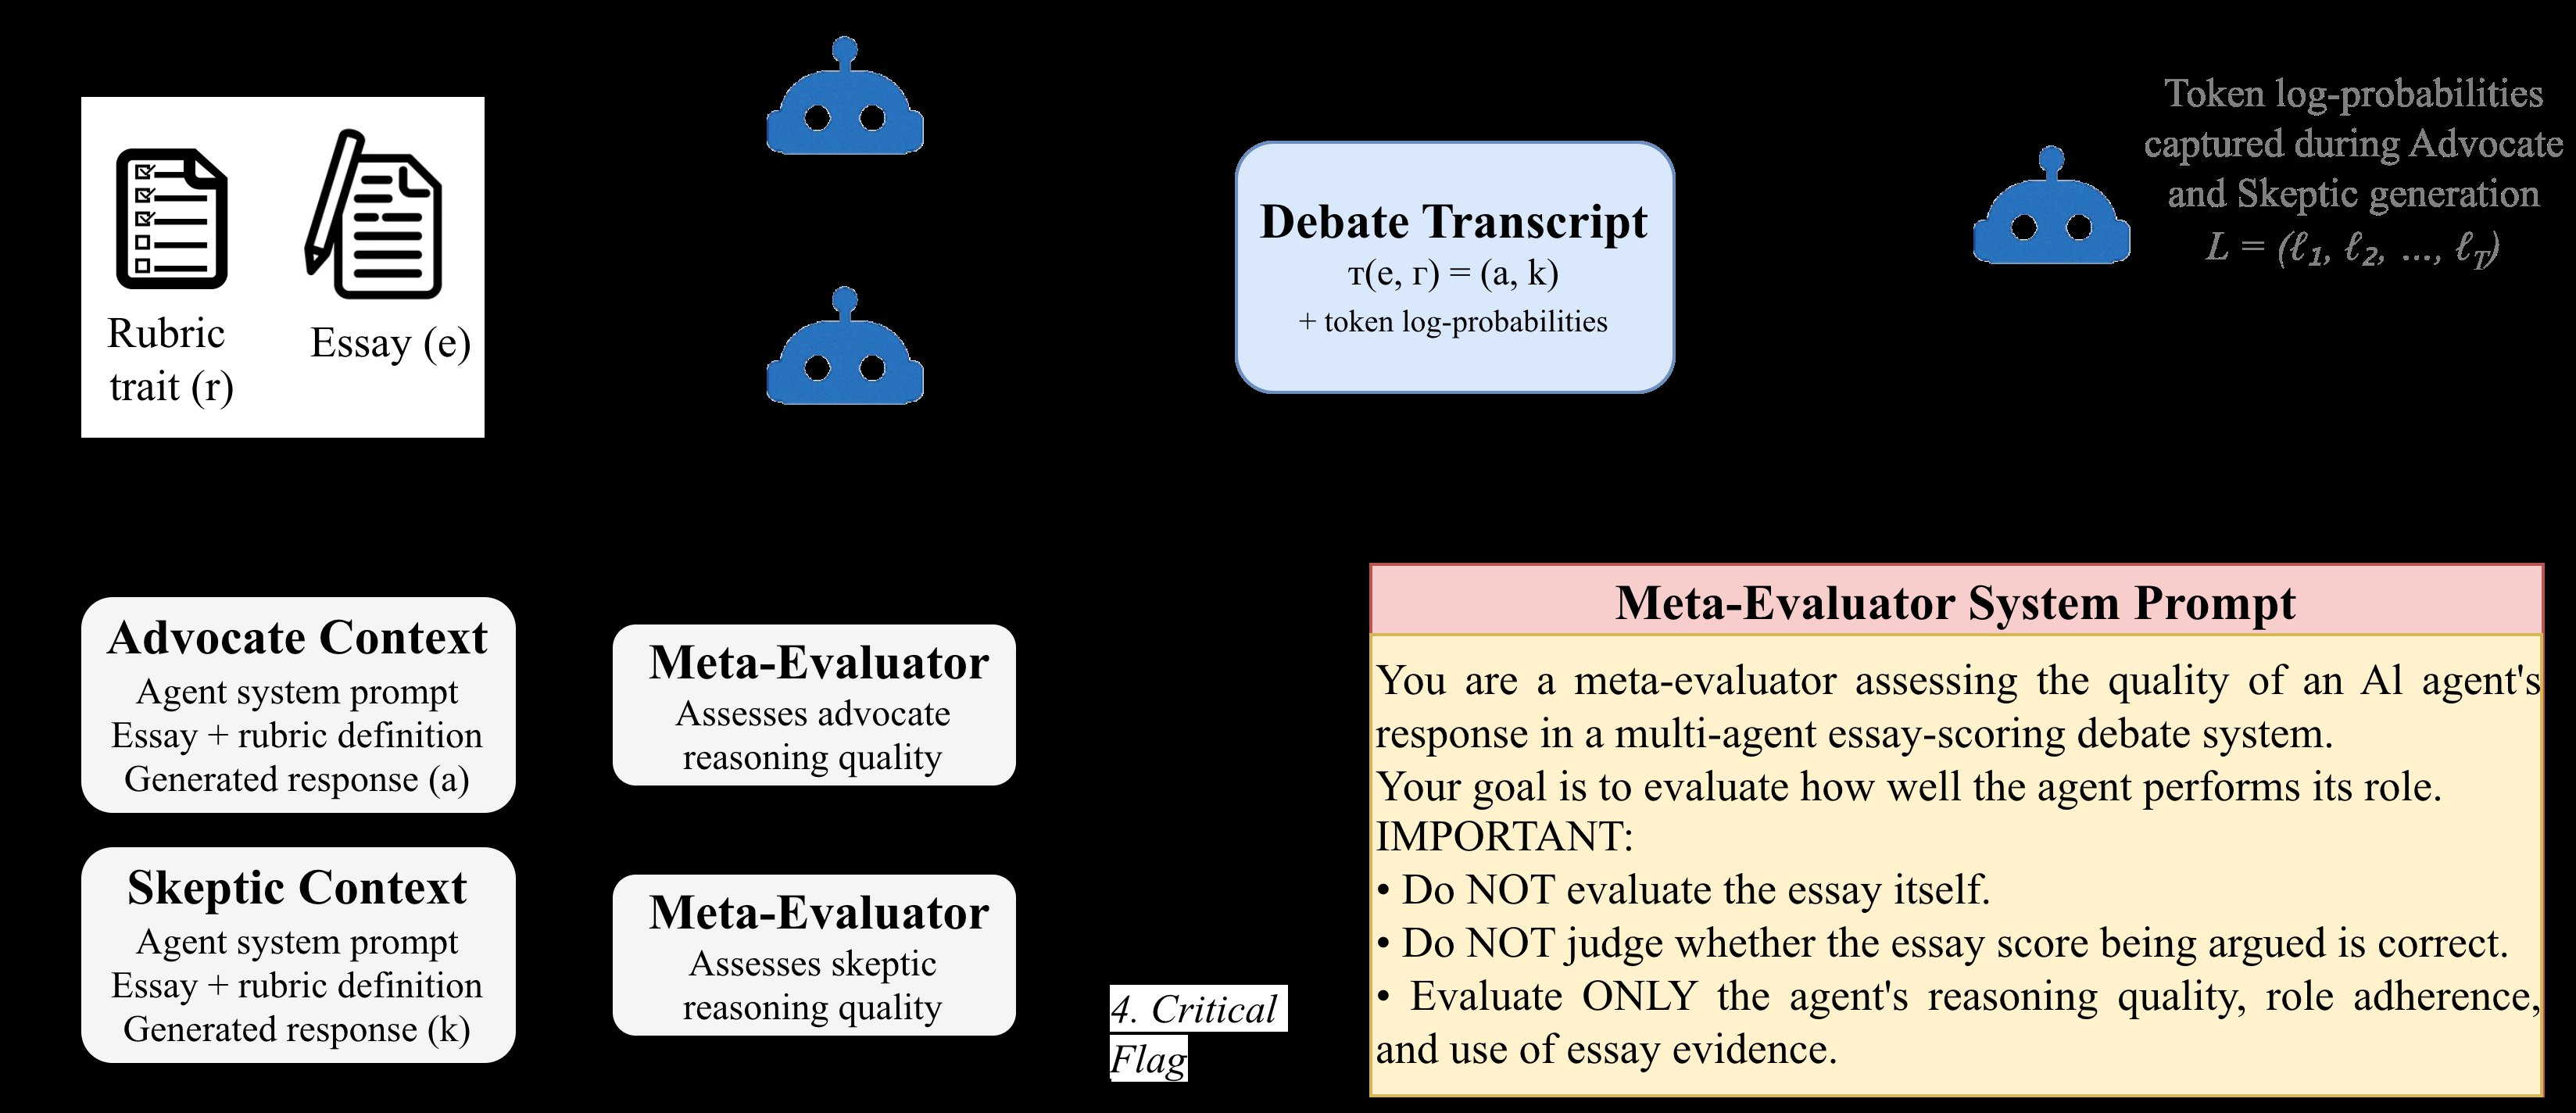
该框架包含两个主要阶段:
- 辩论阶段:Advocate(辩护者)和 Skeptic(怀疑者)针对给定的作文 - 量表对(essay–rubric pair)生成对立论点,同时暴露 token 级对数概率作为内在置信度信号。
- 评估阶段:一个独立的元评估器(meta-evaluator)根据基于量表的维度(如指令遵循、论证质量、证据基础)对每个论点进行评分。
智能体角色设定
辩论框架由三个专门化的智能体组成,针对每个作文 - 量表对按顺序交互:
- Advocate:发起辩论,构建强调作文相对于量表特质优势的论点,仅使用作文文本中的支持性证据,不分配分数。
- Skeptic:响应并识别作文相对于同一标准的局限性或缺点,生成基于证据的反驳,挑战辩护者的主张,同样不分配分数。
- Synthesizer-Judge Scorer:阅读完成的对话记录并生成最终的特质级分数。由于该智能体执行受约束的决策任务,其输出可直接与真实分数进行准确性评估,因此本研究主要关注 Advocate 和 Skeptic 产生的开放式推理。
置信度信号计算
作者使用生成过程中获得的 token 级对数概率来估计模型置信度。对于包含 个 token 的生成响应,模型在每个解码步骤产生一个对数概率: 其中 是提示上下文, 是前序 token。研究旨在分析这些 token 级概率信号是否与外部评估的智能体推理质量相关。
核心实验发现
早期 Token 置信度是强预测因子
论文在两个 ASAP 作文数据集上比较了置信度代理与基于量表的法官评分。作者发现,早期 token 的置信度,特别是生成前几个 token 内的置信度,是推理质量最一致的预测因子,其表现优于全序列统计。
对数概率轨迹的分析显示,生成的初始阶段是最具异质性的,因此也最具信息量。这意味着模型在开始生成时的不确定性或确定性状态,能够很好地预示后续推理的整体质量。
置信度轨迹分析
图 2 展示了 Advocate 和 Skeptic 响应在作文集 7(左)和作文集 8 上的 token 级对数概率轨迹。
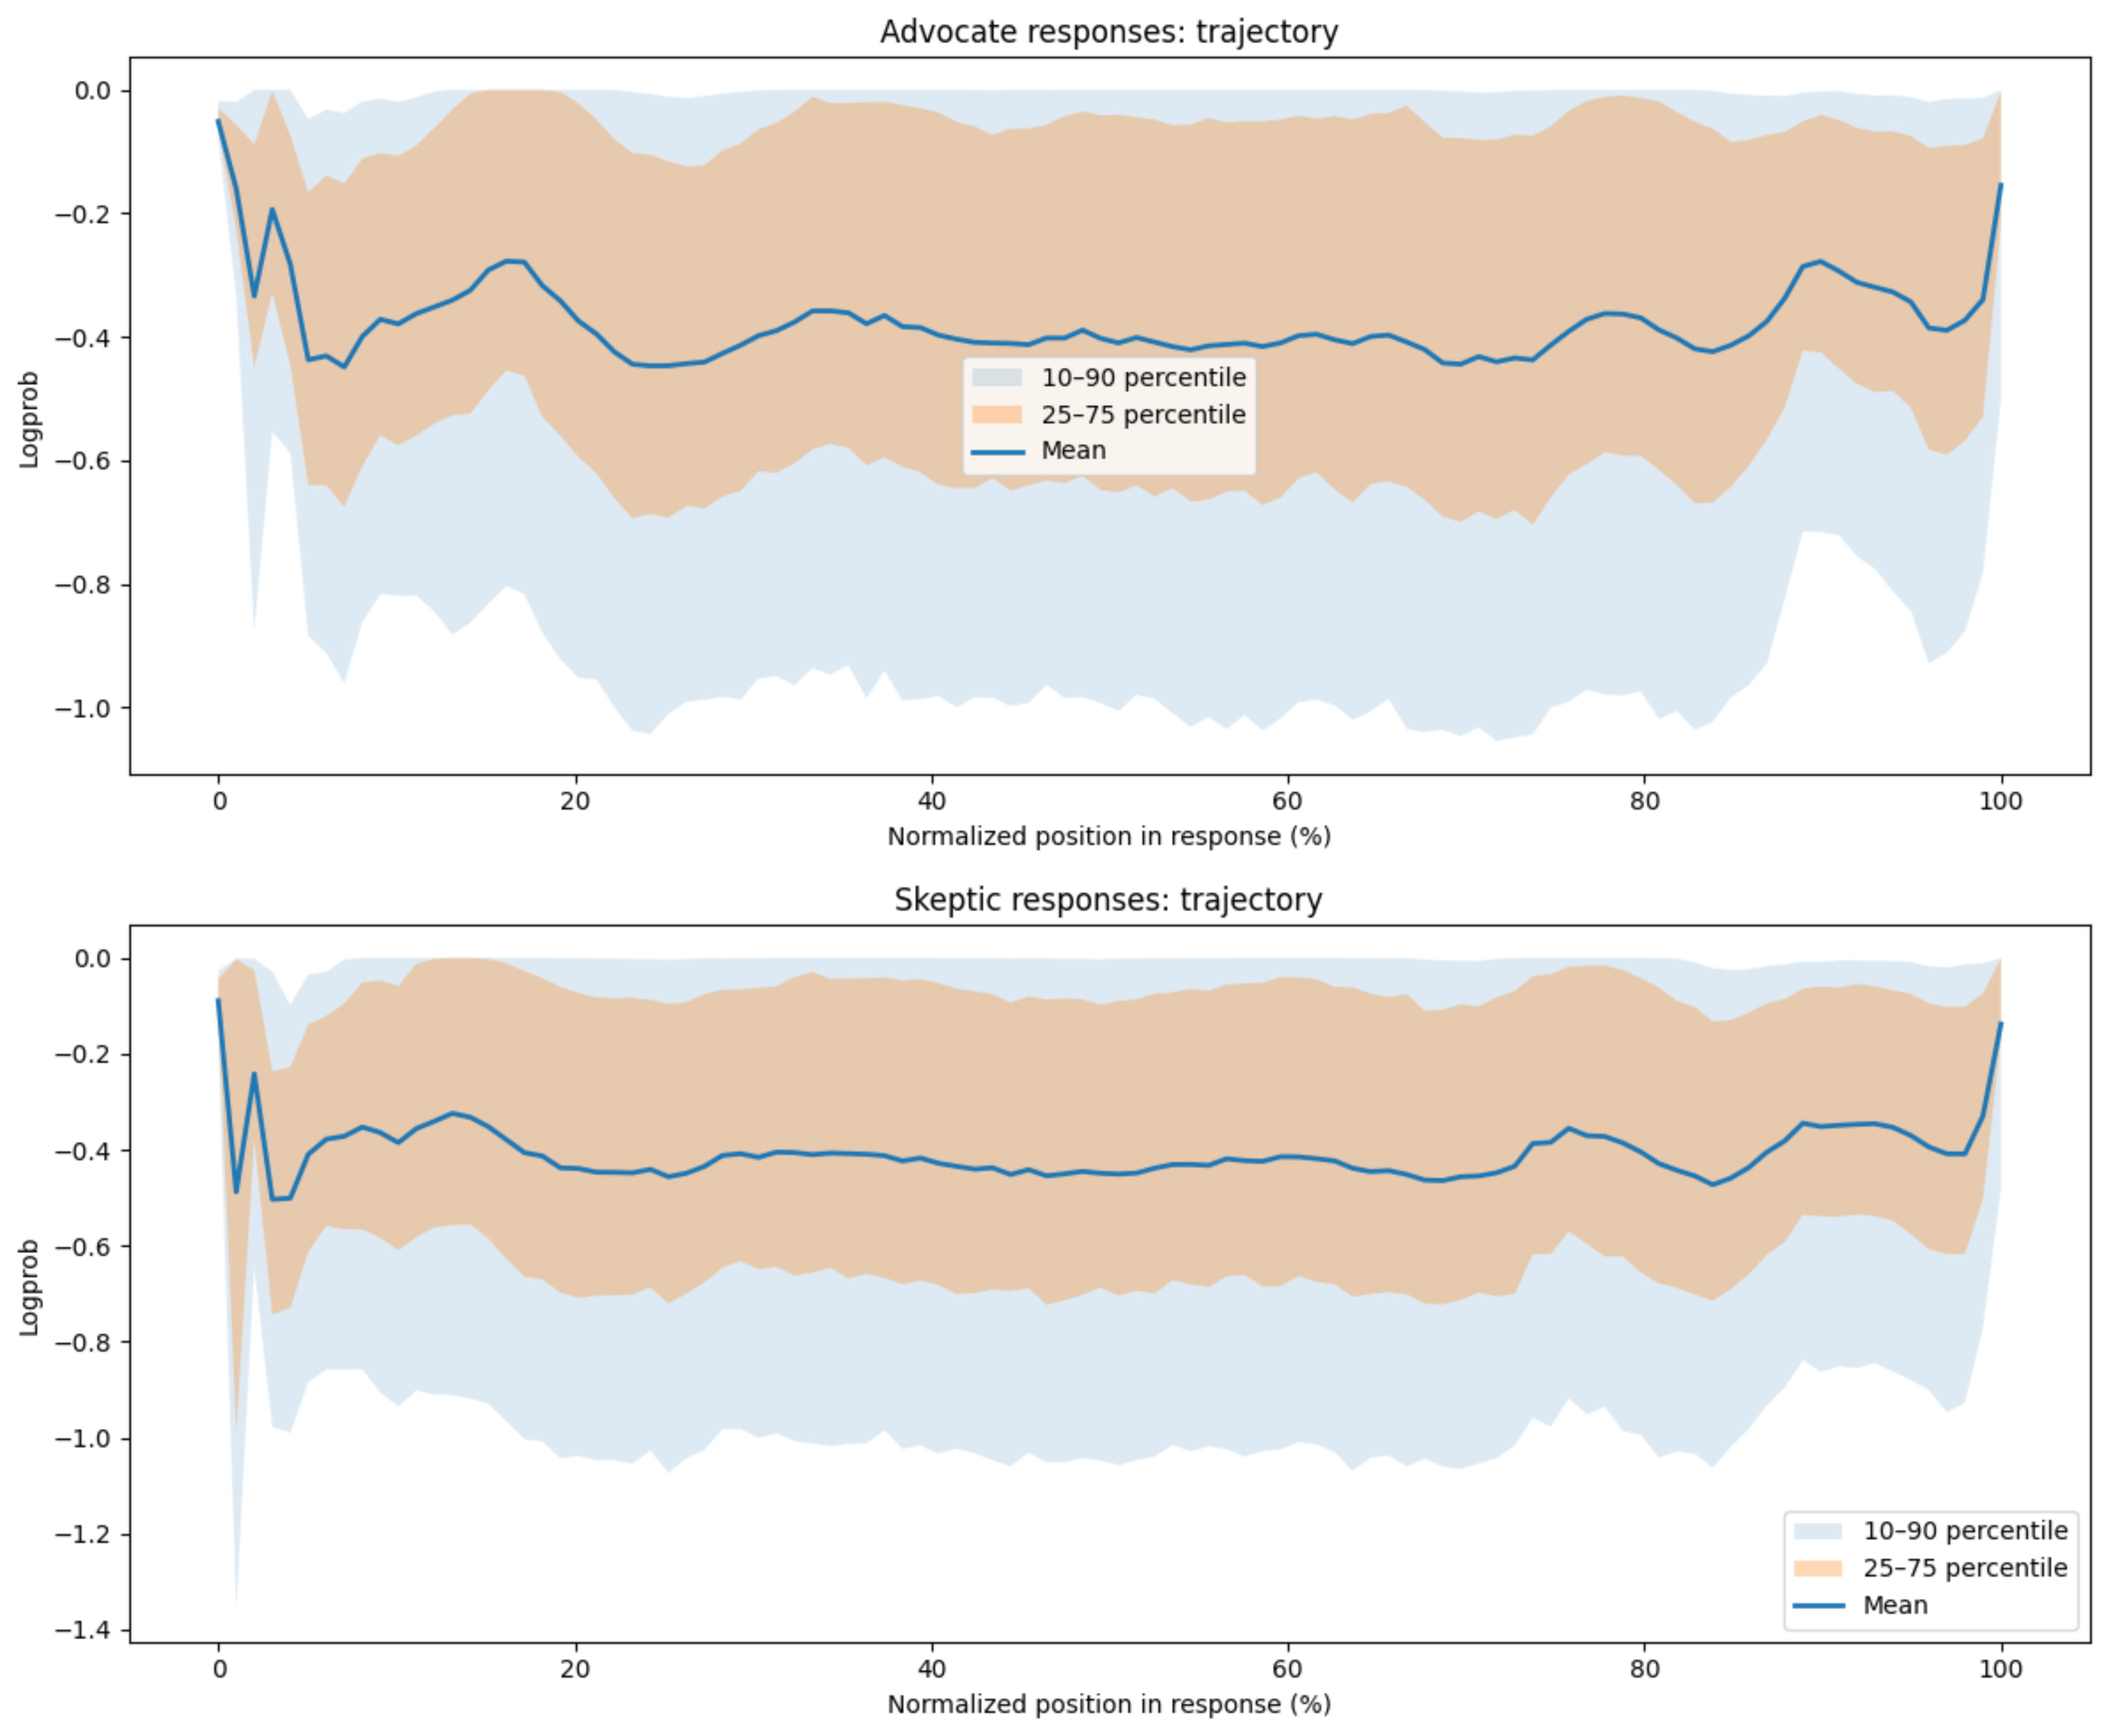
通过观察这些轨迹,作者进一步验证了早期生成阶段的重要性。轨迹图揭示了不同角色和不同作文集之间的概率分布差异,支持了早期解码动态作为轻量级有效信号的结论。
智能体角色的系统性不对称
论文还观察到了智能体角色之间的系统性不对称。作者指出,在支持性推理(Advocate)中,置信度与质量之间的对齐程度强于对抗性批评(Skeptic)。这意味着对于辩护者而言,高置信度更有可能对应高质量的推理,而对于怀疑者而言,这种相关性可能较弱。这一发现表明,不同角色在辩论中的认知负荷或生成策略可能存在差异,影响了置信度信号的可靠性。
评估维度的分布特征
在评估维度方面,图 3 展示了 LLM-as-judge 评分在不同评估维度上的分布情况。
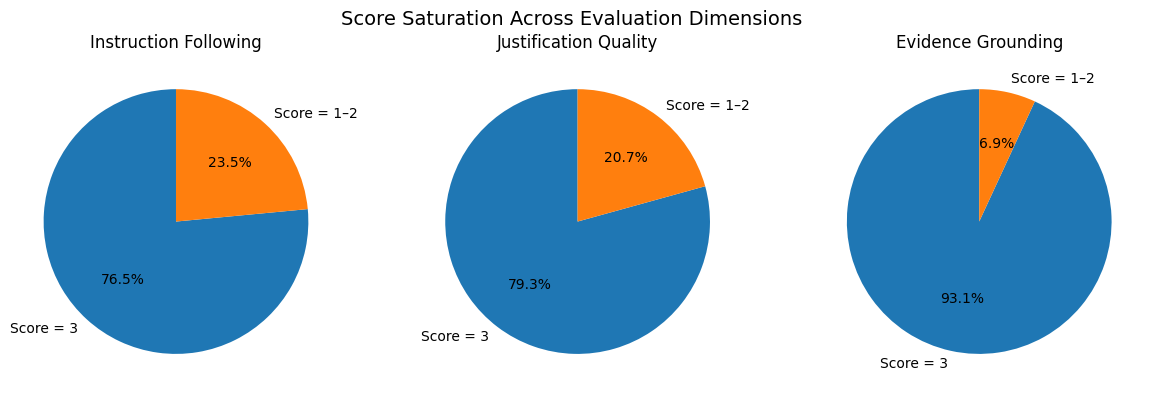
作者注意到,证据基础(Evidence grounding)这一维度表现出高度饱和(highly saturated)。这意味着在评估过程中,该维度的评分可能缺乏足够的区分度,或者大多数样本在该维度上都达到了较高或较低的水平,这可能会影响基于该维度的置信度相关性分析。
结论与启示
综上所述,该研究探讨了多智能体 LLM 辩论系统中推理质量的评估问题。作者提出,内在的置信度信号(token 级对数概率)可以预测由 LLM-as-judge 评估的推理质量。
主要结论包括:
- 早期信号的重要性:早期 token 的置信度是推理质量的最强预测因子,优于全序列统计。
- 生成阶段的异质性:生成的初始阶段最具信息量。
- 角色不对称性:支持性推理比对抗性批评表现出更强的置信度与质量对齐。
这些结果表明,早期解码动态为估计多智能体 LLM 系统中的推理可靠性提供了一种轻量级且有效的信号。这一发现对于优化多智能体系统的评估层、减少对外部评估的依赖以及提高系统可靠性具有重要的实践意义。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。