
Illusions of the Gold Standard: A Large-scale Analysis of Human Evaluation Protocols for Long-form Text Generation
作者:Katelyn Xiaoying Mei, Yi-Li Hsu, Minjoon Choi, Zongwan Cao, Chenjun Xu
作者对 2023 至 2025 年间 *CL 会议中涉及长文本生成的论文进行了大规模分析,定义了 20 项人类评估可报告标准,旨在揭示当前评估协议中存在的透明度与可复现性问题。
论文信息摘要
论文要解决什么
长文本生成任务中人类评估协议缺乏透明度和标准化,关键细节(如标注指南、标注者信息、统计严谨性)经常缺失,导致评估结果的有效性、稳健性及跨研究可比性受限。
论文方法概览
- Backbone: 20 项可报告标准框架
- 关键模块: 人工审查(284 篇)与 LLM 辅助分析(1.8k+ 篇)相结合
- 损失函数: N/A
读后要点
个人理解,欢迎指正
分析表明当前社区在人类评估设计细节上普遍报告不足,且存在向 LLM 评估者转移的趋势;作者建议采用标准化报告规范以提升透明度。
局限与疑问
分析局限于 *CL 会议论文,LLM 辅助分析部分可能存在噪声,且建议的采纳程度有待观察。
阅读笔记
以下为个人阅读笔记,原文见 arXiv:2606.07936v2。
黄金标准的幻觉:长文本生成人类评估协议的大规模分析
背景与动机
随着大语言模型(LLM)的广泛应用,长文本或开放式生成任务已成为自然语言处理(NLP)研究的主流。在这些场景中,自动化评估指标往往表现不佳,因此人类评估仍被视为衡量生成文本质量的“金标准”,尤其是在医疗、科学、法律等高专业领域。然而,论文指出,当前人类评估程序的可靠性和可复现性依赖于透明且记录完善的协议,而这些细节在现有实践中经常缺失。
作者认为,缺乏标准化和操作流程化限制了评估的有效性、结论的稳健性以及跨研究的可比性。此外,随着模型自我评估能力的提升,人类评估正越来越多地被 LLM 评估者(LLM-judges)补充或替代。在这种情况下,人类评估还承担着评估 LLM 评估者性能的元评估角色。基于此,作者将研究视角转向 *CL 研究社区,旨在理解人类评估的报告实践,并批判当前实践中的不足。
研究方法与标准定义
为了系统性地检查社区内的报告规范,作者定义了一套包含 20 个可报告标准(reportable criteria)的框架。这些标准基于科学可复现性文献,涵盖了任务定义、标注操作化、标注者信息以及数据分析与解释等核心方面。
数据收集与分析流程
论文对 2023 年至 2025 年间发表在 *CL 会议上的 9100 多篇论文进行了大规模分析。研究重点关注涉及中长篇自然语言生成的论文,因为这类任务对人类评估的负担较重,且缺乏清晰可复现的自动化评估指标。
在数据采样方面,作者从涉及长文本生成并包含人类评估的 1800 多篇论文中采样了 356 篇。其中,284 篇论文进行了完整的人工标注,其余部分则通过 LLM 辅助进行标注。这种混合方法旨在平衡分析的深度与广度。
标注工具与协议
在构建代码本(codebook)的过程中,作者通过迭代方式开发了评估标准,最终确定了 37 个问题,其中 20 个为核心可报告标准。为了执行这一大规模分析,研究团队设计了专门的标注界面。
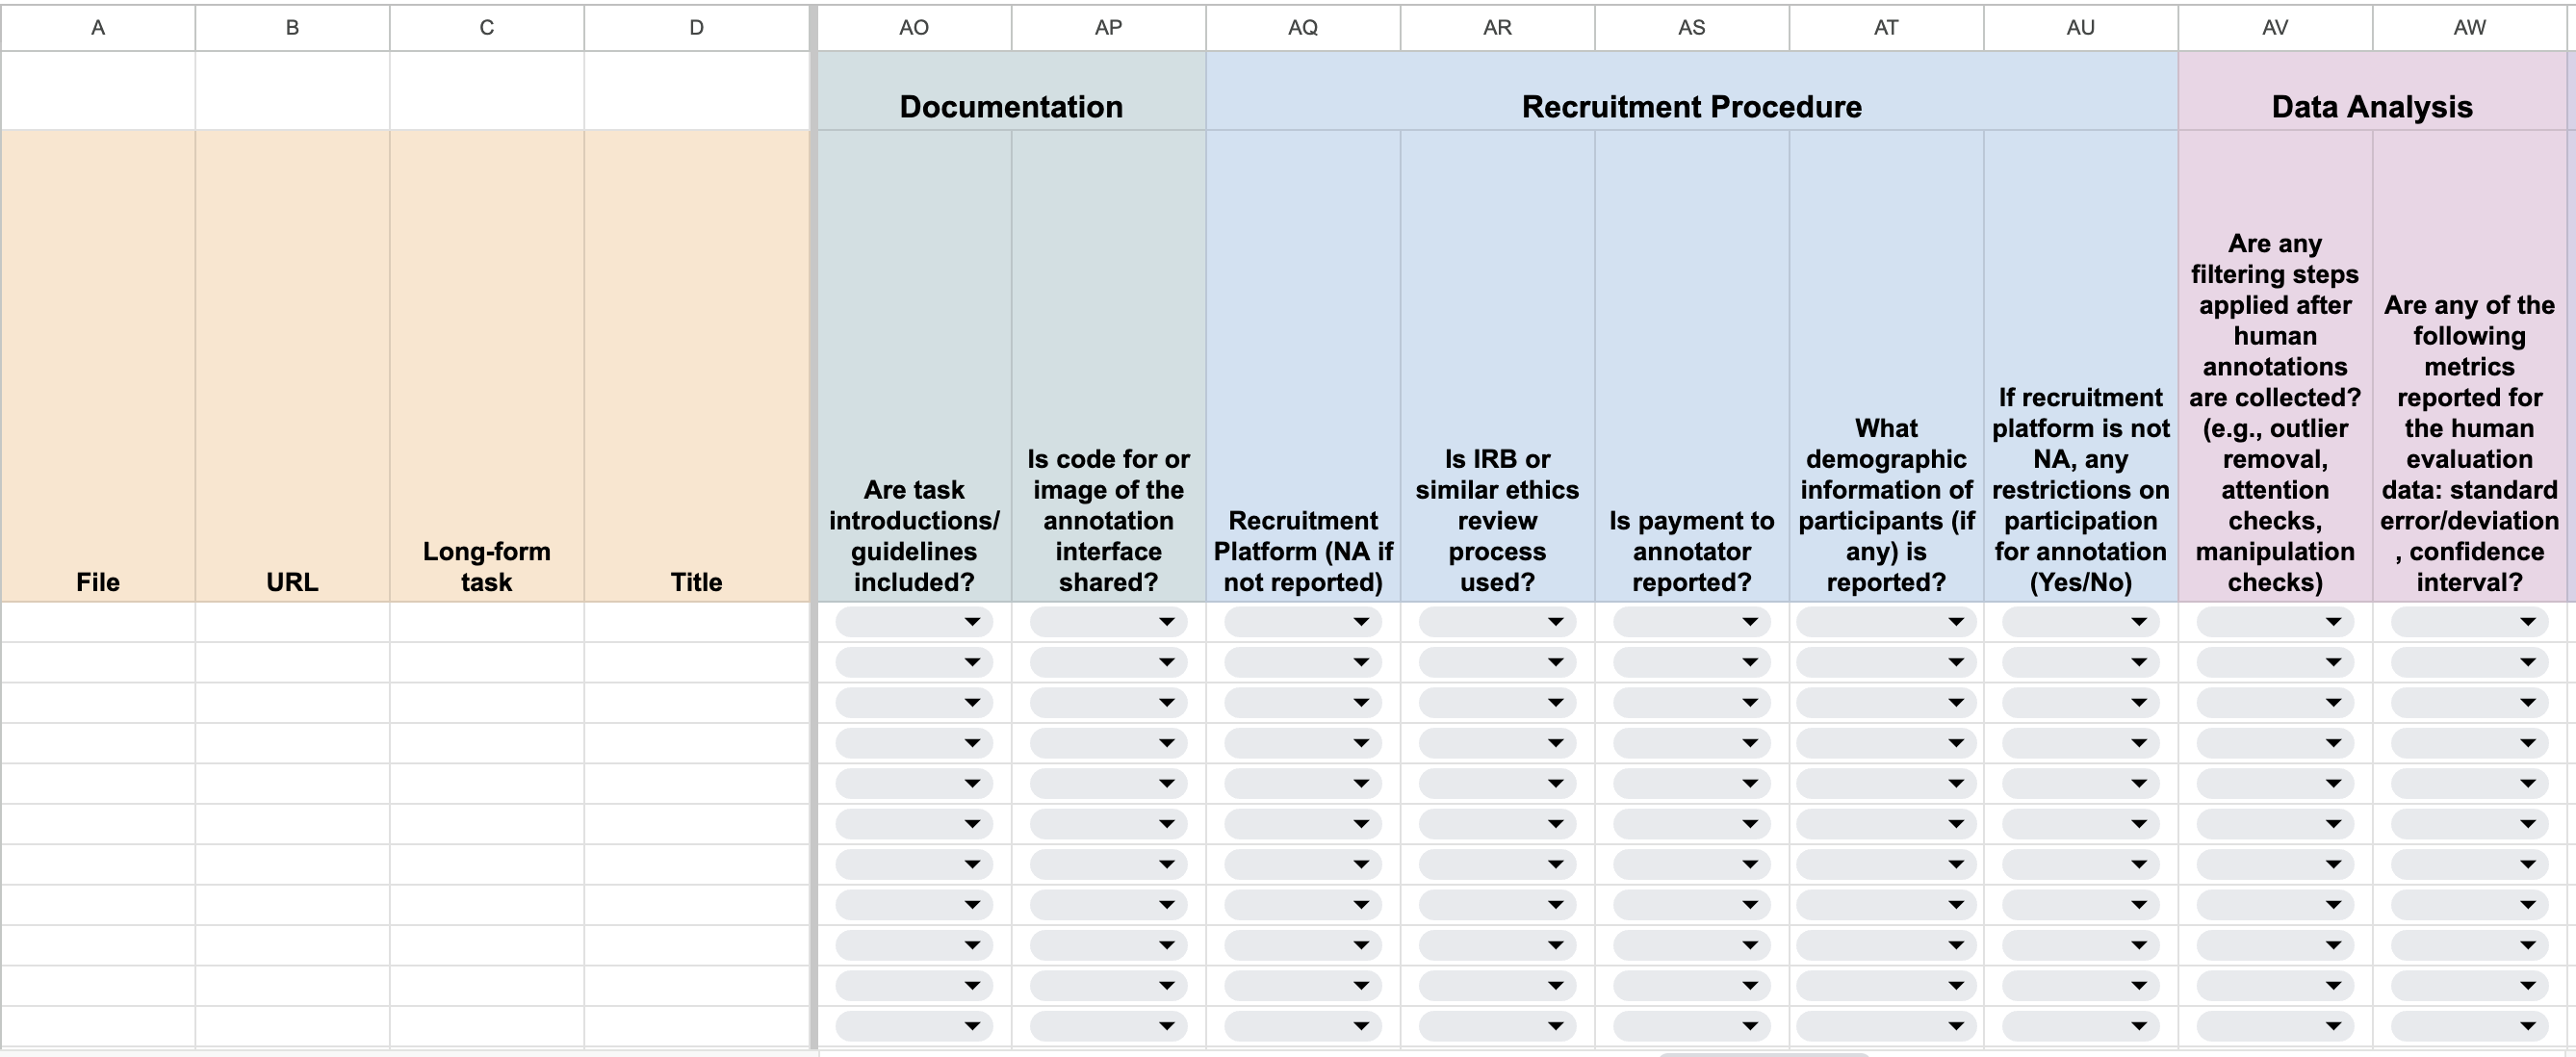
上图展示了研究团队在 Google Sheets 中使用的标注界面截图,其中包含了与文档化相关的问题。该界面支持标注者系统地检查每篇论文是否报告了评估指南、标注者人口统计信息、样本数量等关键细节。通过这种结构化的标注流程,作者能够量化当前社区在人类评估协议报告方面的合规程度。
主要发现
通过对大量论文的分析,作者揭示了人类评估协议文档化中存在的明显缺陷,关键方面的报告普遍不足。
报告不足的具体表现
论文分析了 20 个核心标准的报告比例。虽然大多数论文报告了评估维度、部分标注者信息以及标注样本数量,但在评估研究设计的其他方面存在显著的报告不足。例如:
- 评估指南与理由: 仅约一半的论文包含了人类评估任务的指南,或为所评估的维度提供了理由。
- 统计严谨性: 诸如使用功效分析(power analysis)计算样本量或报告统计置信度等良好实践极为罕见。
- 标注者信息: 关于标注者纳入/排除标准、招聘平台以及人口统计信息的报告也不完整。
评估范式的转变
研究还发现了一个值得注意的趋势:近年来,使用人类评估进行长文本生成评估的论文比例正在下降,而使用 LLM 评估者进行评估的论文比例似乎在增加。这一变化引发了关于人类评估在元评估中角色的进一步思考。
结论与建议
基于上述发现,作者认为当前人类评估实践中的模糊性导致了对测量内容、测量方式、判断贡献者以及判断解释的误解。为了支持未来研究更加透明和可复现的报告,论文提出了可操作的建议。
作者强调,人类判断仍然是评估方法的基础部分,应像社区使用的其他研究方法一样受到同样的严谨性和标准约束。通过采用定义好的 20 项报告标准,研究社区可以提高人类评估研究的可复现性,减少“黄金标准”的幻觉,确保评估结果真正反映模型的性能。
论文的分析代码和标注数据集已公开,旨在促进社区对评估协议透明度的持续关注和改进。
本篇笔记收录于 arXiv 日报 20260616。更多综述见 博客归档 。